Anthropic 在 2026 年 11 月 13 日发表《Building always-on agents》(作者 William Hu),讲官方怎么做 24 小时待命的 AI 助理:分成事件收件箱(event inbox)、计时器(timers)、记忆(memory)、权限(permissions)、发件箱(outbox)五个组件。
Always-on agent(常驻 AI 助理)是会自己醒来做事的 AI,更详细的说明看 Always-on agent 是什么。
Always-on agent 其实大多在睡觉
Anthropic 说“一直在线”只是用户的感受。Agent 大部分时间在睡,不花任何 token(AI 用量的计价单位)。有事件进来才醒来跑一次 run(一次运行):收到事件,开一个 session(对话记录),跑 agent loop,把结果写回保存的状态。做完回去睡,如此循环。
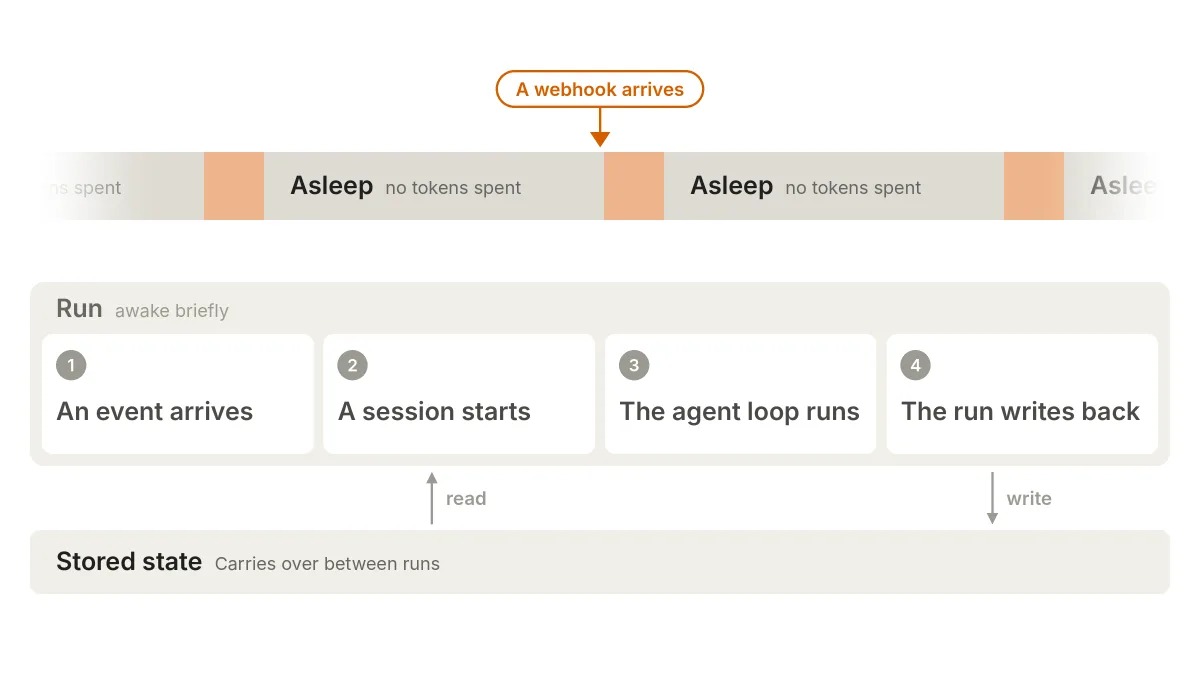
核心循环和一般 agent 相同,差别在外围:何时醒、run 之间留下什么、结果怎么送到你手上。
为什么现在做得起来
Anthropic 给了两个原因。新模型判断力更好,更懂用户的意思,也知道什么时候该主动汇报。另外智能变便宜了,长任务受益最多:在一项长时间写代码的测试中,Opus 5.5 每解一题比 Opus 5 便宜 78%,一般工作量只便宜 40%。长任务大幅变便宜,always-on agent 跑起来也就更现实。Opus 5.5 的细节看 Claude Opus 5.5 介绍。
事件收件箱:所有事件先排队
一般 AI 只在你发消息时才动,这里的触发来源更多:webhook(别的系统发来的通知)、定时任务、后台工作。
让每个来源直接调用 agent 会出问题:两个事件同时到,会开出互相冲突的 run,宕机时事件也会凭空消失。
所以所有来源只把事件丢进收件箱,由 worker(后台程序)去取。最简单的版本有三样东西:
- 一张记录事件的数据表
- 一个写入事件的接收端
- 一个读取事件的 worker
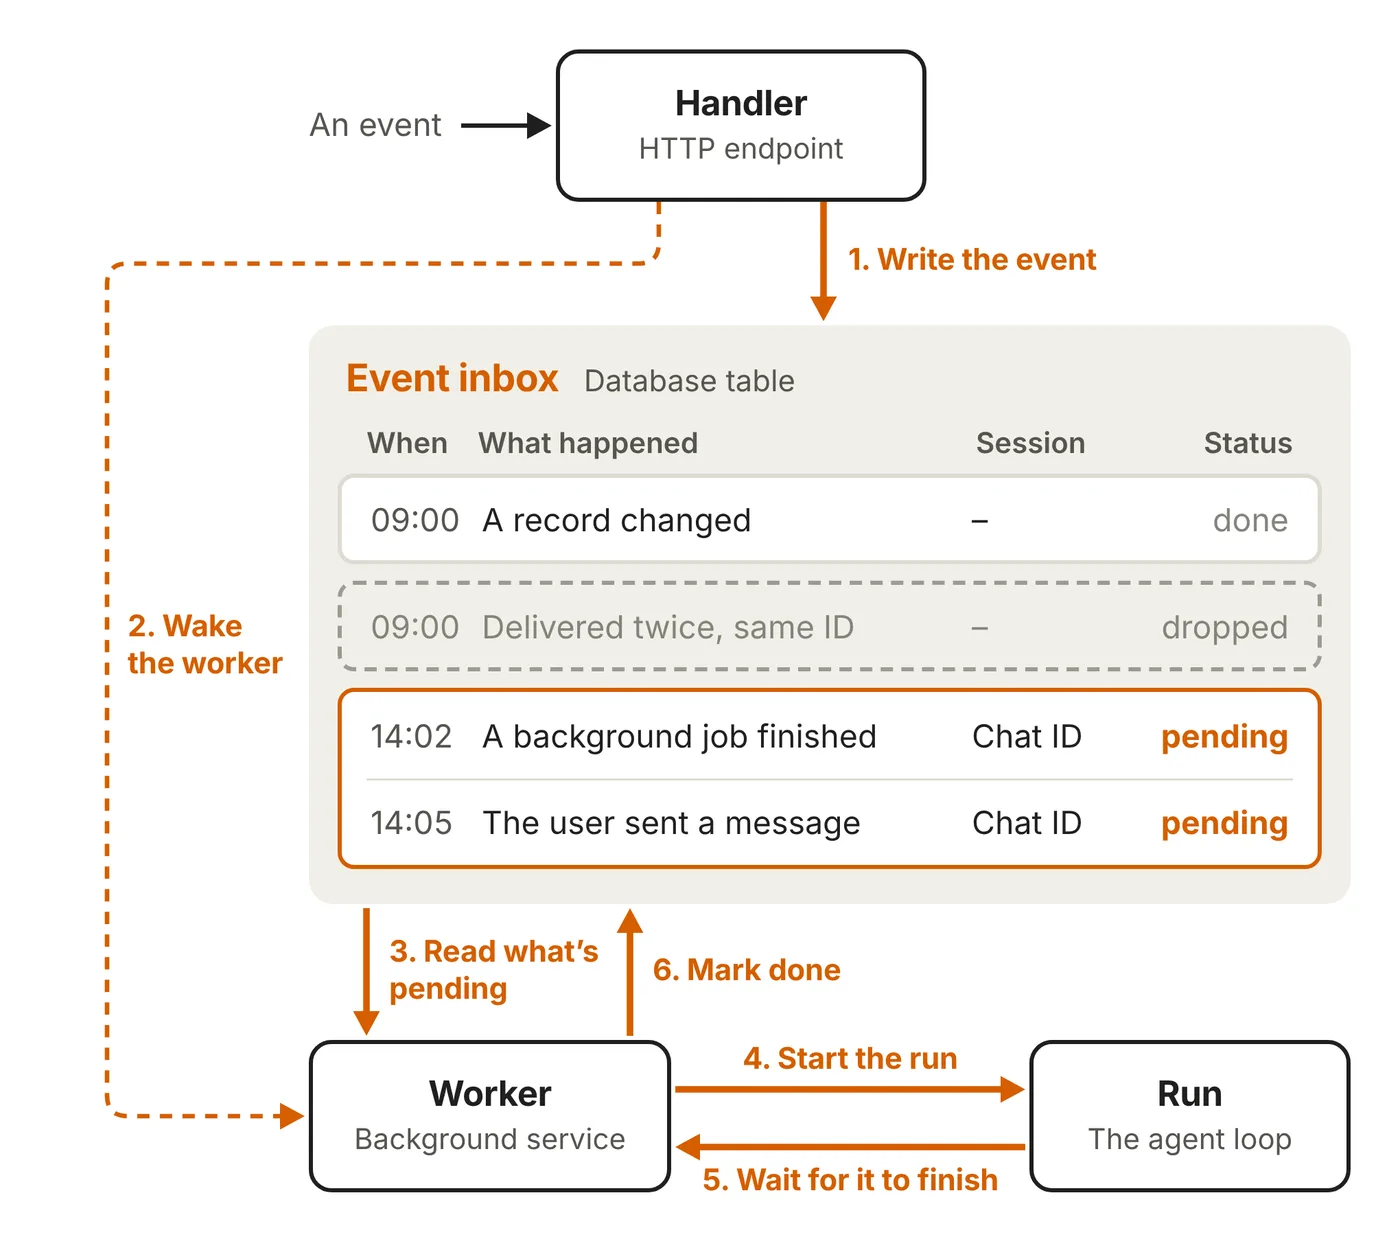
接收端要快速响应,prompt injection(藏在内容里、想骗 AI 照做的恶意指令)这类深入检查留到 run 里做。一切以收件箱为准,worker 挂掉,新的可以捡起同一个事件重做。同一个收件箱同一时间只有一个 worker,连续来的几条消息可以合并成一次 run,agent 只回复一次。
计时器:让 agent 自己安排下一次醒来
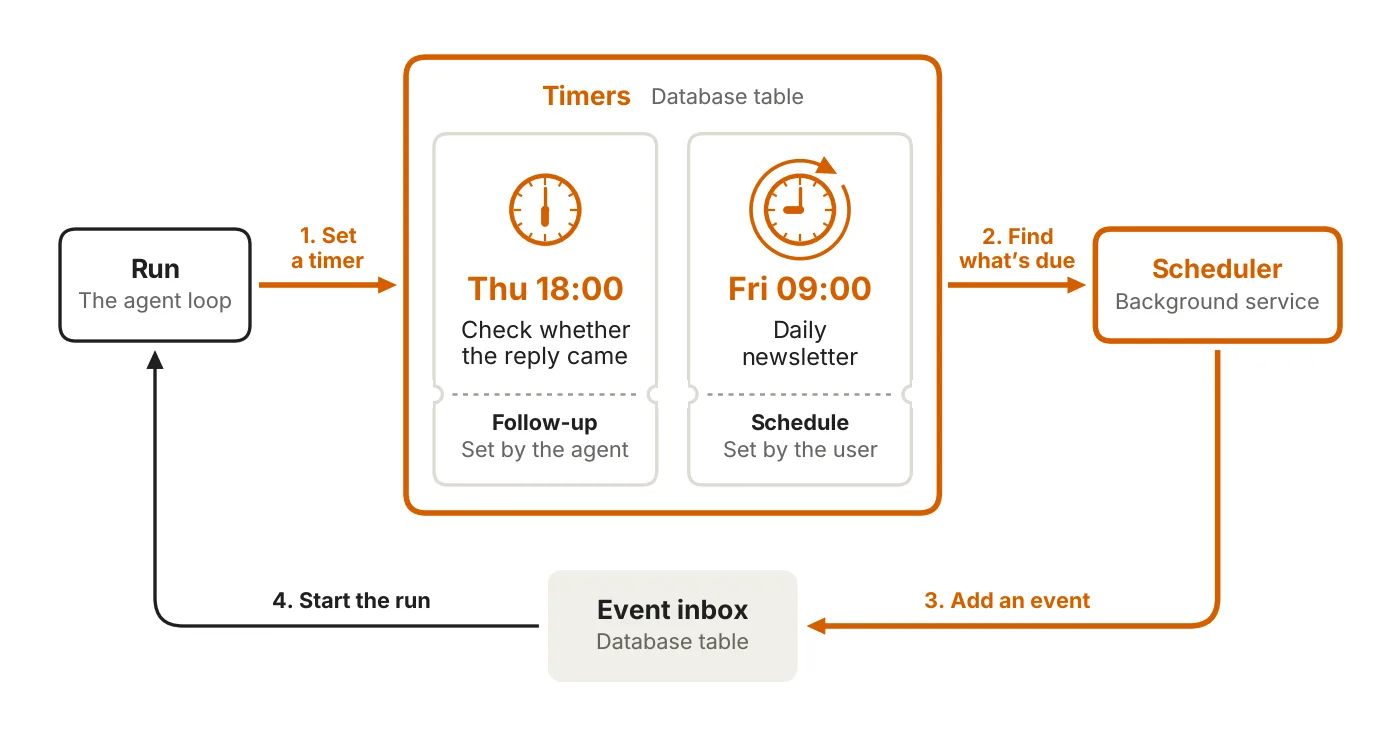
要主动还需要计时器,分两种:
- 跟进(follow-up): agent 给自己设的期限,例如回头看对方有没有回信
- 定时(schedule): 固定周期的任务,例如每天一份电子报
计时器放在自己的数据表,收件箱只放已经可以处理的事件。计时器自己不启动 run,由 scheduler(调度程序)定时扫描,把到期的变成事件丢进收件箱。
记忆:每次醒来都靠它接上
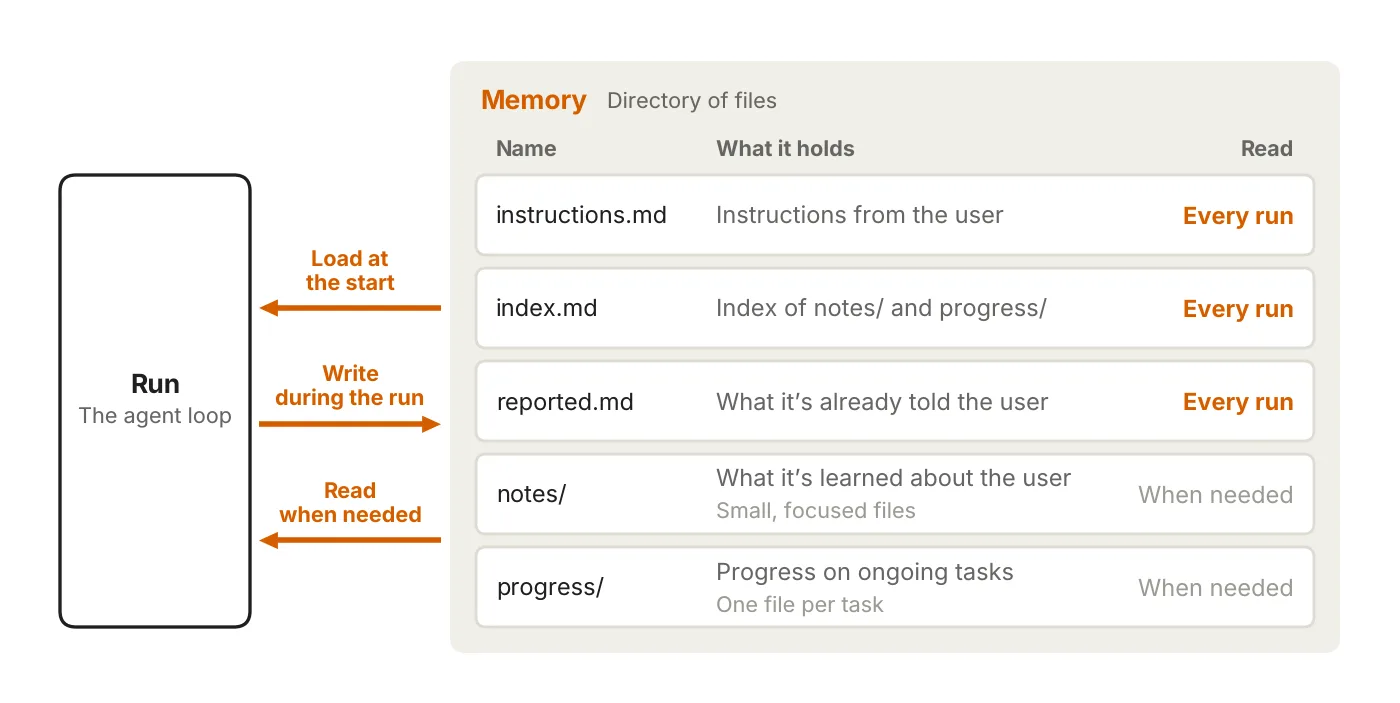
每次 run 之间是断开的,连续感靠记忆。Claude Code 的 auto memory 和 Messages API 的 memory tool 都把记忆做成一个文件夹里的文件。Always-on agent 要把这些文件夹放进数据库或对象存储这类持久的地方,worker 换了,记忆还在。
原则是只存查不回来的东西,数据已经在别的系统(例如问题跟踪工具)里,就只存指针。四种记忆:
- 用户指令: 单独一个文件,每次 run 都加载,因为用户不会一直在旁边指挥
- 用户笔记: 角色、偏好、用户纠正过的地方,只加载索引,需要时再读细节
- 过去消息: 已经告诉用户什么,避免重复
- 任务进度: 每个任务一个进度文件,新的 run 读了就能接着做
还可以加 dreaming:回头检视过去的 session,整理记忆、替换过时条目,找出跨多次 run 才看得出的规律。Claude Managed Agents 已经有同类功能,看 Claude Managed Agents Dreams 是什么。记忆的基础看 AI Agent 的记忆机制。
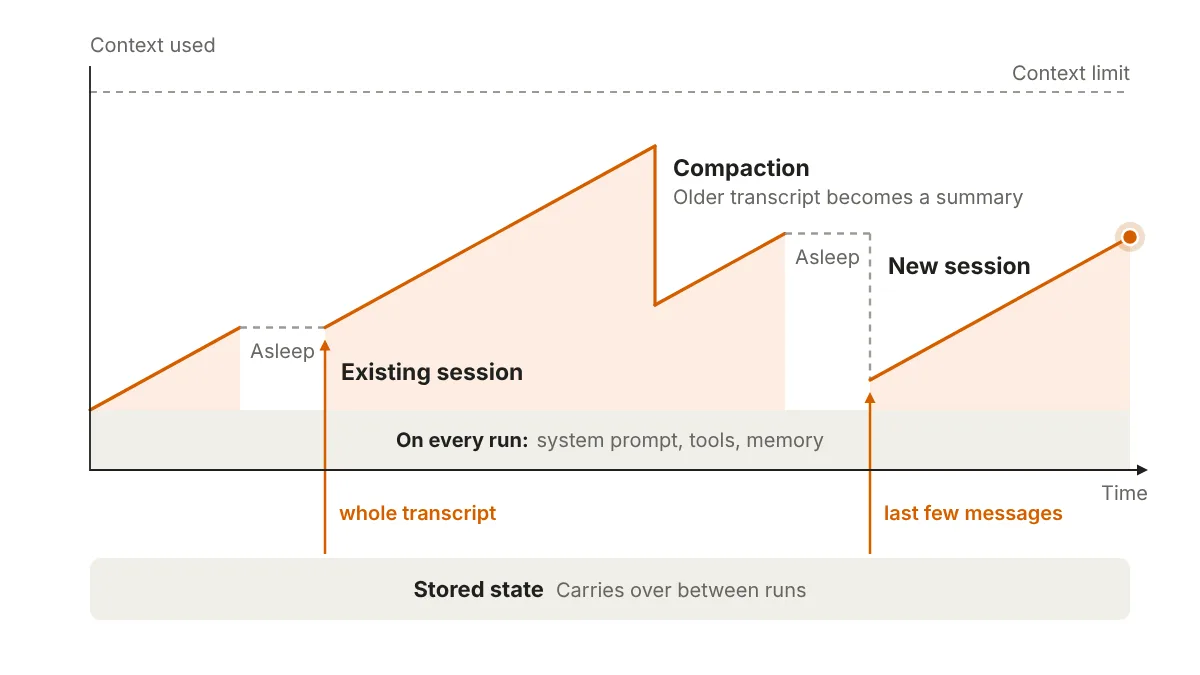
每次 run 一开始,agent 先加载 system prompt、工具定义和记忆文件,这是每次都要付的成本,要精简,并用 prompt caching(缓存重复的开头以省费用)。新 session 只带这些内容和触发事件,旧 session 会带回之前所有消息。
太长时可以 compaction(把旧消息压成摘要)或开新 session,两种都会丢细节,重要的事要先存进记忆。
权限:风险最集中的地方
Anthropic 指出权限是风险最高的环节:一次 run 握有用户的访问权,又没人盯着。每次工具调用,agent 要决定直接做、拦下,还是等人批准。有三个做法:
- 账号凭证放在 agent 外面: 密码、访问令牌这类凭证交给 agent 环境外的代理服务器(proxy),请求发出时才补上,agent 自己手上没有
- Auto mode: 和 Claude Code 一样,由分类器审查高风险操作,拦下危险的,让 Claude 换个安全的做法。最重要的决定仍要用户看过
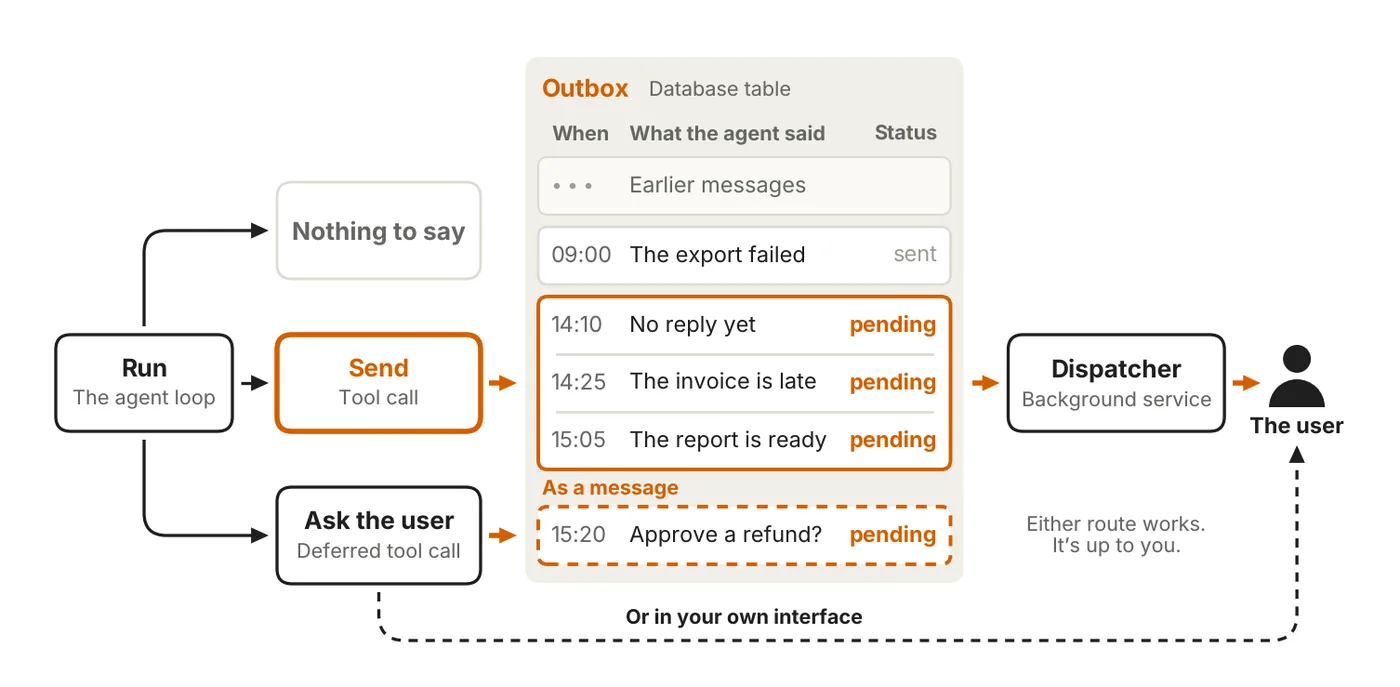
- Deferred tool call(延后的工具调用): 需要批准时,这次 run 结束,session 保存在调用到一半的状态,请求做成交互卡片给用户看(Anthropic 举的例子是用 MCP Apps 做的界面),回复变成事件进收件箱,新的 run 接着做。等待期间 worker 还能处理别的事件
更多风险面向可以看 AI Agent 的安全风险。
发件箱:只讲结果,不讲过程
一般 AI 会实时输出整个思考过程,always-on agent 在后台工作,你只拿到结果和重点。
一次 run 有三种结局:发出一条消息、判断没什么好讲的、用延后的工具调用来问你。多数 agent 有个“send”工具直接发就够了。要控制发消息的节奏或从错误中恢复,才需要正式的发件箱:一张待发消息的数据表,加一个 dispatcher(派发程序)决定发哪些。
消息量要调:太多会变吵,太少会漏事。Anthropic 建议用 eval(测试)找平衡,从安静开始,慢慢争取注意力。
五个组件怎么串起来
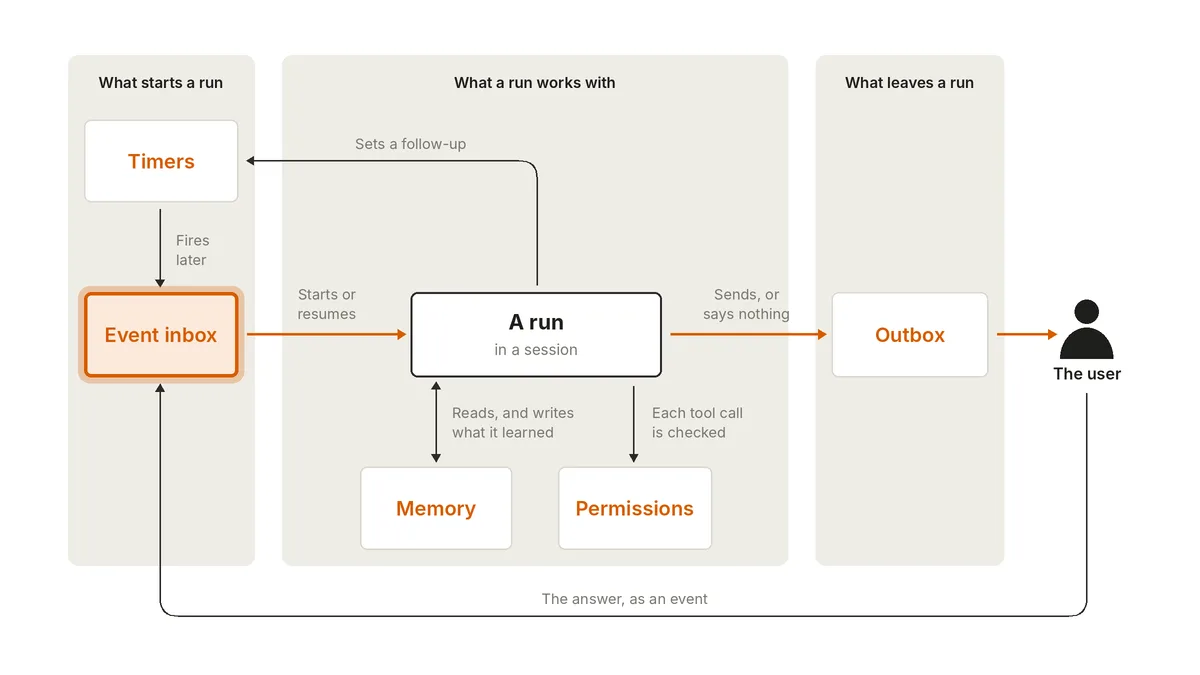
每次 run 都从收件箱里的一个事件开始,可能是用户消息、webhook 或计时器。Worker 叫醒 agent,用新的或旧的 session。Agent 先读记忆,在权限内动手,再把学到的写回记忆,最后推一条到发件箱,由 dispatcher 发给你。
Run 也可以设一个计时器,之后再叫醒自己。你的回复又变成事件回到收件箱。每次 run 都很短,循环不会停,agent 就像一直在线。
跟 Rubric Labs 的做法差在哪
工程团队 Rubric Labs 的设计是一条长期不断的对话串,用 heartbeat(定时塞进对话的消息)叫醒 agent。发消息也是工具,所以 agent 可以决定这次不打扰你。它另有广泛的访问权和通知收件箱。
两边都用工具决定要不要通知你,也都用收件箱接外部事件。差别是 Rubric Labs 只有一条对话串,Anthropic 则让每次醒来跑一次短 run,可以开新的 session 或接回旧的,长期要留的信息存在记忆文件里。定时任务和分身的基本做法,可以看 Skill、Sub-agent、Cron 三大机制。
判断 always-on 产品的三个问题
- 事件怎么进来?有收件箱,还是每个来源直接叫 agent。
- 它记得什么?指令、笔记、已说过的话、任务进度有没有分开存。
- 它能做什么?账号凭证在不在它手上,高风险操作谁批准。
发消息的部分,Anthropic 建议 agent 从安静开始,用 eval 调整消息量,再慢慢争取你的注意力。
封面与正文图片来源:Anthropic(claude.com/resources/articles/building-always-on-agents)
本文为 AI agent 设计概念的整理,不涉及证券或投资建议。