一句话重点
Anthropic 在 2026 年 9 月 22 日推出 Claude Opus 5.5。官方称它在多数工作上达到 Fable 5.1 的水平,默认设置下比 Opus 5 省约 4 成成本。 Claude 分成 Fable、Opus、Sonnet、Haiku 几个系列(截至 2026 年 9 月),能力和价格由高到低,Opus 属于中高阶。上线近两周,它在多个第三方排行榜排名第一;第一周不少评论者给了好评,9 月底之后也出现不少抱怨。
这次升级重点
- 接近 Fable 5.1:Fable 5.1 是更贵的高阶模型,官方称 Opus 5.5 在多数工作上达到它的水平。
- 更便宜、更快:API 输入、输出单价比 Opus 5 低 2 成,生成速度快 3 成以上(官方数字)。
- 默认思考力度调低:Claude 回答前会先“想”,想得越深通常越准确,也越慢越贵。Opus 5.5 默认用中等力度,需要的话可以自己调高。
- Claude Code 默认换模型:Pro 或 Team Standard 方案的 Claude Code,默认模型从 Sonnet 换成 Opus。
跑分怎么看
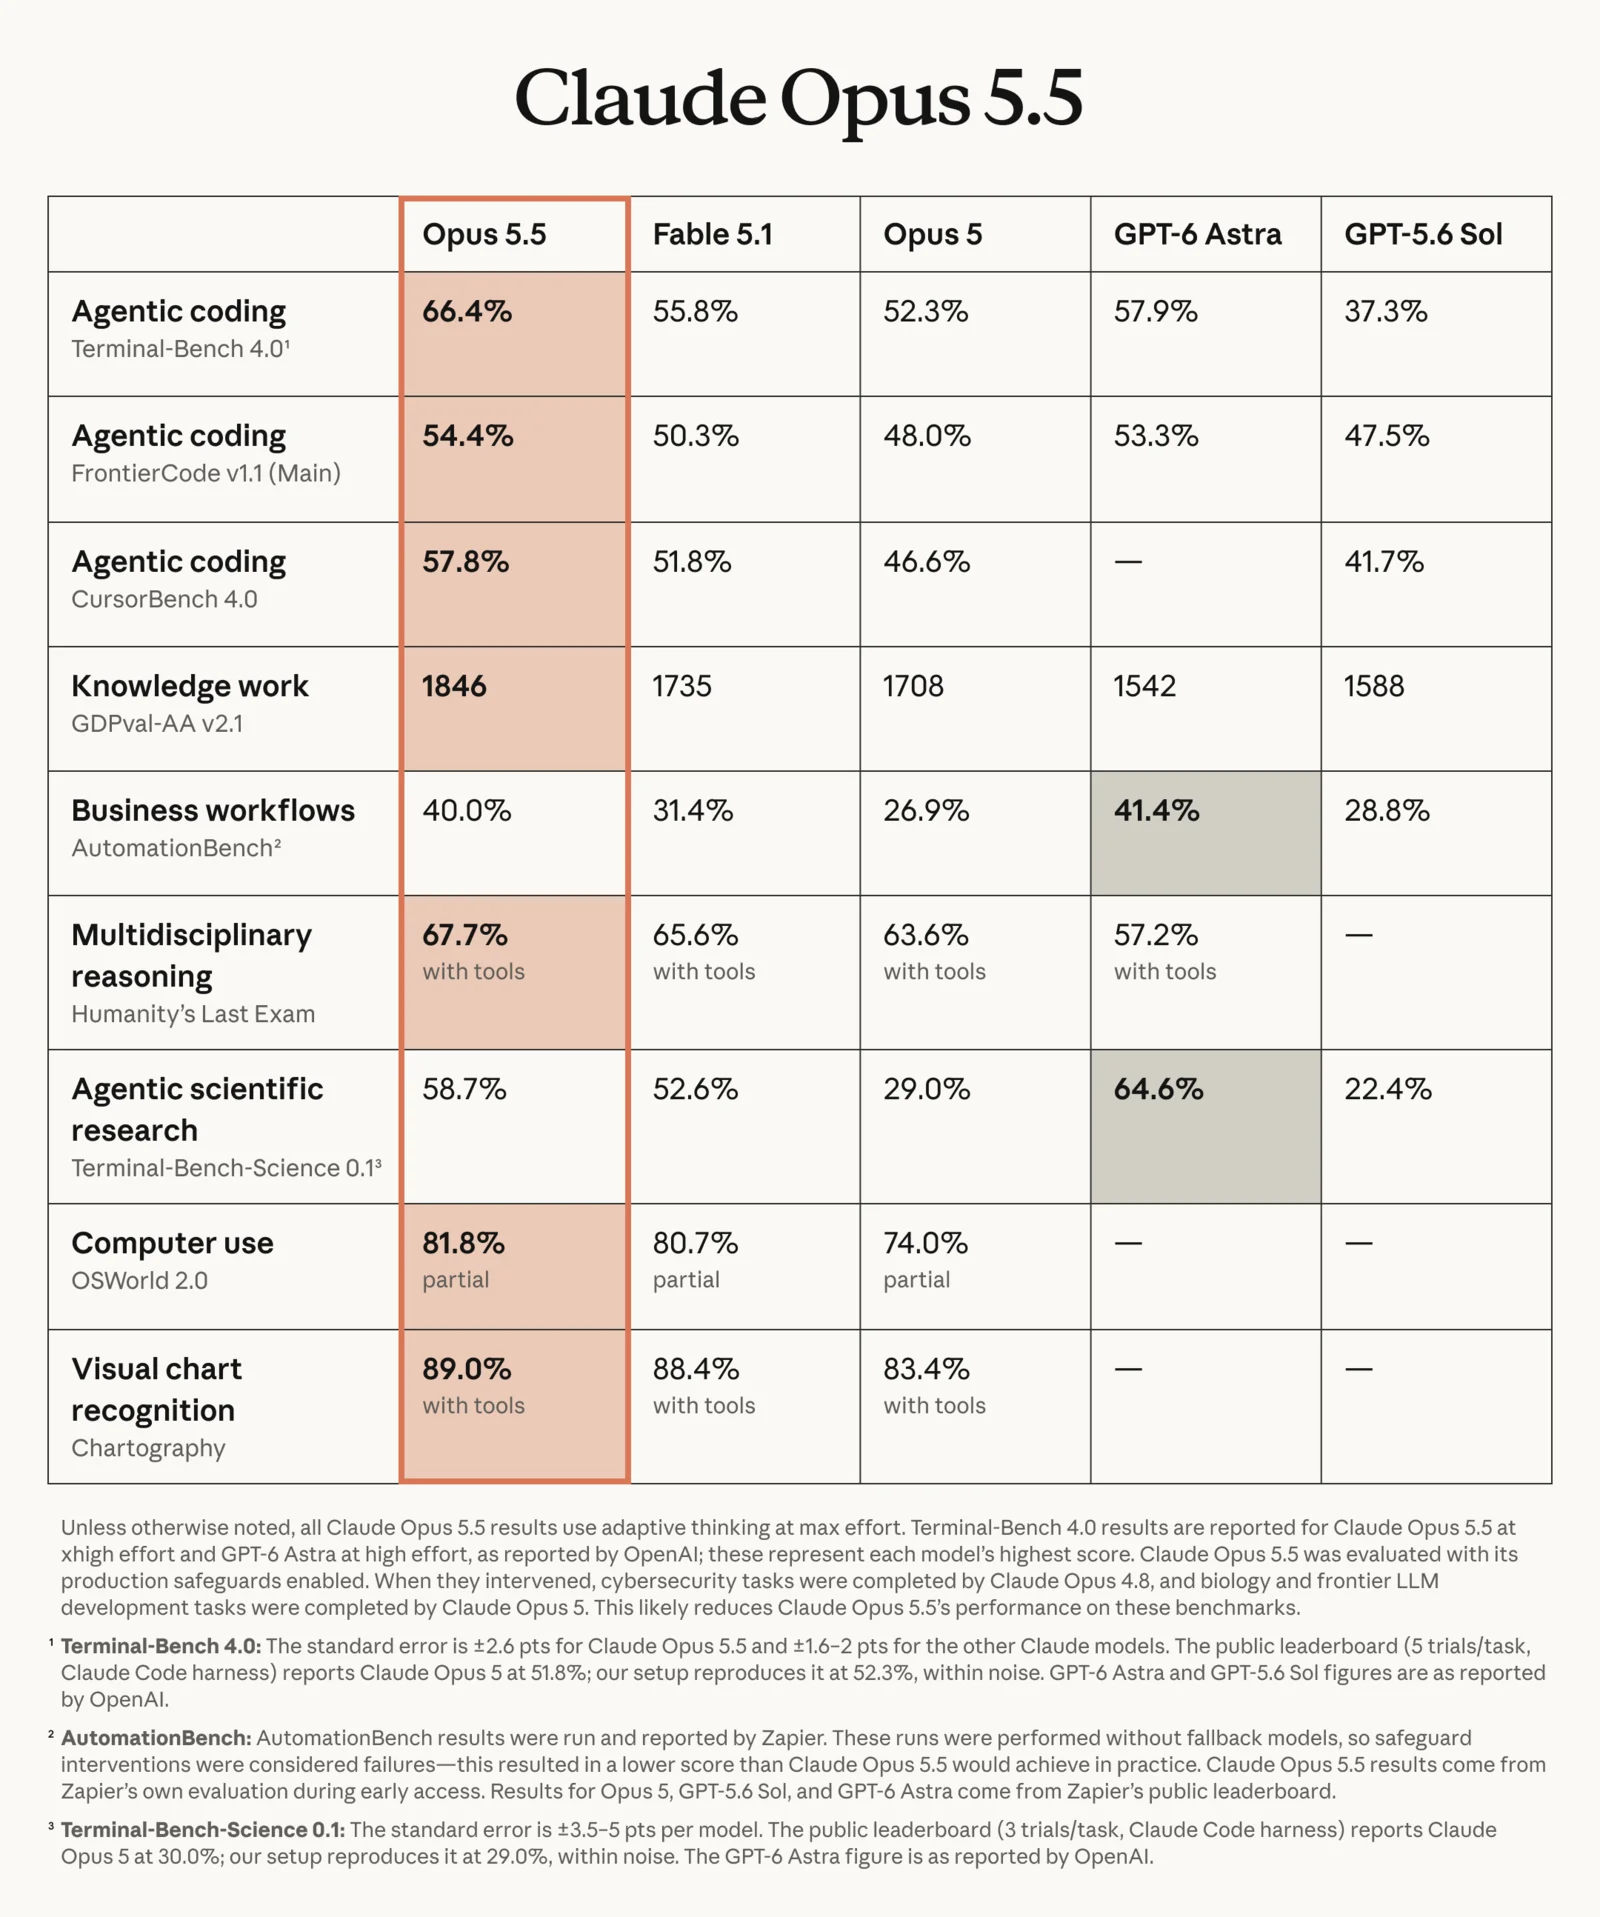
跑分就是让不同模型做同一组任务,再按表现打分。官方公布的九项测试里,Opus 5.5 有七项拿下表中最高分(其中三项 GPT-6 Astra 没有分数),另外两项输给 GPT-6 Astra。Anthropic 也提醒,到了这个能力等级,跑分差距已经不太能反映实际使用的感觉。
上线近两周:第三方排名
| 榜单 | 测什么 | Opus 5.5 名次与分数 | 数据日期 |
|---|---|---|---|
| Artificial Analysis | 综合智力指数 | 第 1 名,58 分(max,允许默认备用模型) | 2026-10-04 查阅 |
| LMArena 文字对战 | 真人盲测投票 | 第 4 名(high 设置),1504 分,与第 2~3 名差距在误差内 | 2026-10-02 |
| LMArena WebDev | 网页制作真人盲测 | 第 1 名(max 设置),1815 分 | 2026-10-01 |
| Vals Index | 金融、法律等实务任务 | 第 3 名(max,含备用模型完成的任务),66.97% | 2026-10-02 |
各榜单的思考力度(effort)与备用规则不同,分数要结合设置一起看。
社区评价:好评在哪,抱怨在哪
Zvi 在 LessWrong(9 月 26 日)形容,这是他见过“反应最一致正面”的一批评价(来源)。
好评:
- 好沟通:比 Opus 5 自然。Simon Willison 说它“看起来解决了大家对 Opus 沟通风格最大的抱怨”(来源)。
- 编程与 agent 任务表现好:有几位开发者把它当成默认模型。
- 速度快。
抱怨:
- 安全分类器误拦:敏感工作会转给旧模型(见下方“安全重点”),有人觉得打断工作。
- 最高 effort 很耗 token,有时做不完:Simon Willison 用 max 设置测试时,曾两次没有返回结果。
- “变笨了”的疑虑:9 月底开始出现,目前查到的测试还不足以确认退步。
以上是个别体验,不能换算成整体好评比例。
价格与方案
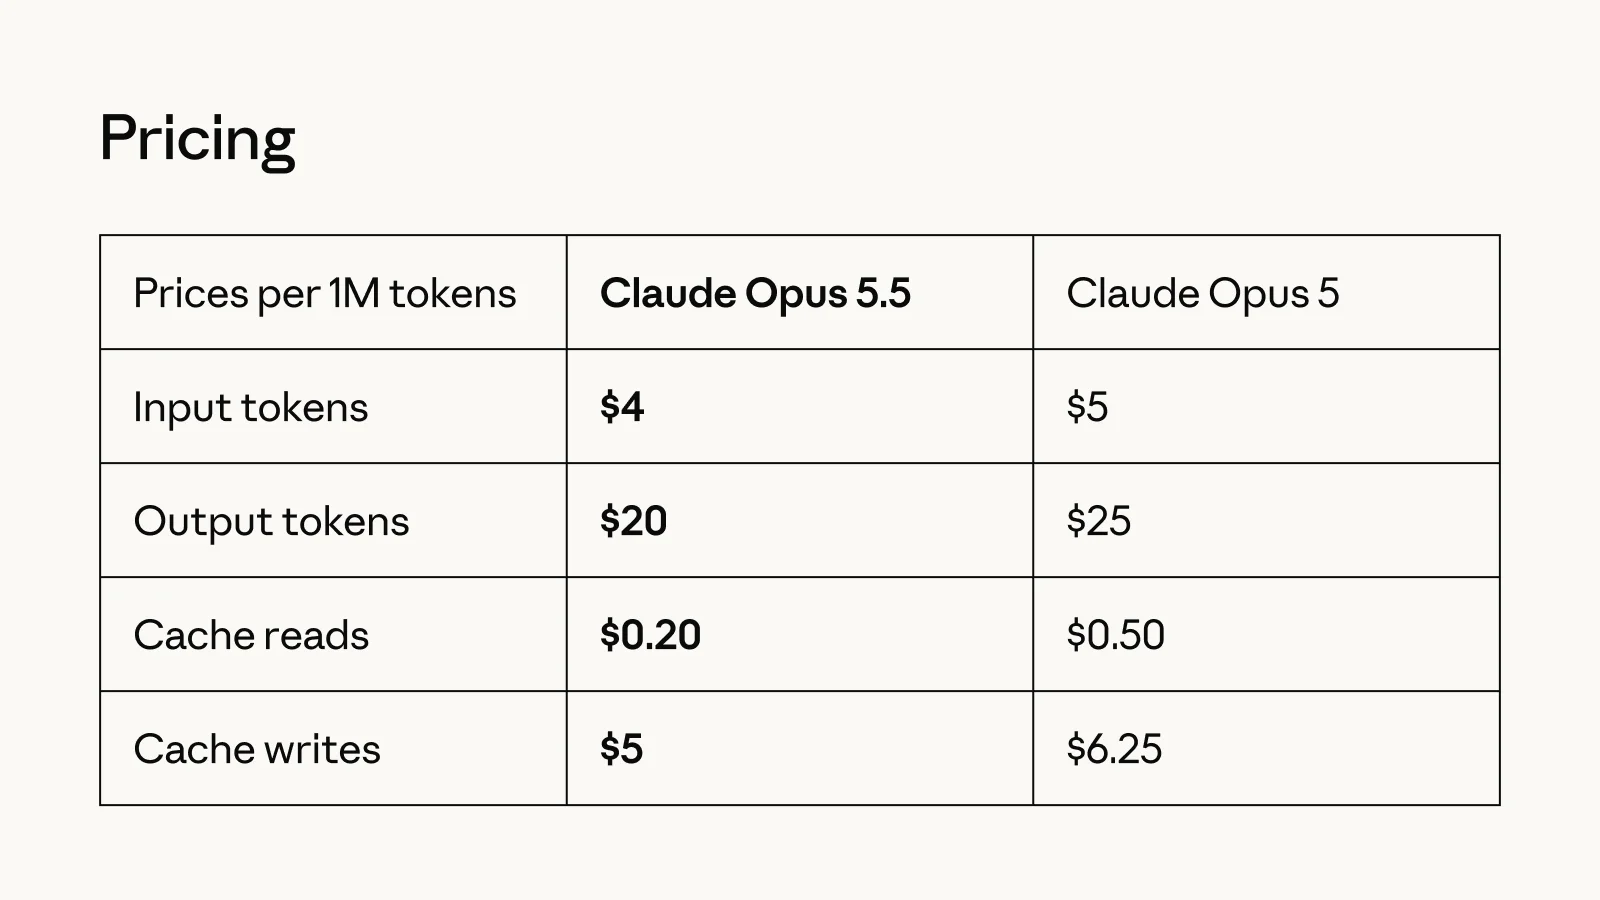
| 项目 | Opus 5.5 | Opus 5 |
|---|---|---|
| 输入 | $4/MTok | $5/MTok |
| 输出 | $20/MTok | $25/MTok |
| 缓存读取 | $0.20/MTok | $0.50/MTok |
MTok 是“每百万 token”。100 万输入加 100 万输出 token,Opus 5.5 约 24 美元,Opus 5 约 30 美元。缓存读取是重复读取同一段内容的收费,跑长任务的人最有感。
这张表是 API 的计费方式。Pro、Max 这类订阅是月费制,不用计算 token,但用量有上限;免费方案还不能用 Opus 5.5(截至 2026 年 9 月)。开发者可以通过 Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry 获取。
开发者要注意的变更
一般用户可以跳过。接入 API 的开发者换模型前,留意这四点:
- thinking 不能关,强行关闭会返回错误。
- 强制指定某个工具会出错,改用自动判断就正常。
- 读不懂 Fable 留下的 thinking blocks。
- Claude API 和 Google Cloud 上的旧版 computer use 工具已停用。
安全重点
Anthropic 每次发布新模型都会公布“系统卡”,说明做过哪些安全测试。这次的重点:
- 对齐测试表现好:官方行为测试中,多数不对齐指标优于近期 Claude 模型。
- 提示注入退步:粘贴进对话的文字若藏着恶意指令,Opus 5.5 比以前更容易照做;加上官方防护后,基本上不会照做。
- 敏感问题自动切换模型:在 Claude App 问到网络安全或生物相关的敏感问题,会转给 Opus 4.8 或 Opus 5 回答,画面会提示。
小企鹅的总结
老实说,小企鹅玩了一天 Opus 5.5,有点感动到。它总算回到 Opus 4.6 那种好沟通的感觉,不像 Opus 5 说话跟机器人一样。拿来指挥其他 agent(orchestration)也特别顺,终于可以让它自己 spawn subagents(派出子 agent)分头做事,这点 Opus 4.6 就比较笨拙。token 也用得比较省。最有感的是,回复里那些奇怪的“—”终于不见了 😭
接下来小企鹅会继续测试 Opus 5.5,有新心得再发上来。
第一周的评价和第三方排名,大致印证了小企鹅第一天的感觉。要留意的是安全转模型,以及最高 effort 的成本与稳定性;预算有限的人,可以用自己的任务比较输入、输出单价只要一半的 Sonnet 5.5。
受益最直接的是通过 API 付 Opus 5 价格的人,以及用 Pro 或 Team Standard 方案 Claude Code 的人。开发者记得重新测试 effort 等级,不要直接沿用旧设置。
本文为 AI 模型 API 计费与订阅方案的消费信息,不涉及证券或投资建议。实际定价以 Anthropic 官方最新公告为准,本文信息截至 2026 年 10 月 4 日,可能已经过时。
延伸阅读
- Claude Fable 5.1 完整介绍
- Claude Sonnet 5.5 完整介绍
- Claude Opus vs Sonnet:什么时候该用哪个
- Claude Code 完整教程
- Claude Opus 4.8 介绍
封面图片来源:Anthropic(anthropic.com/claude-opus-5-5)