一句话重点
Anthropic 于 2026 年 10 月 7 日推出 Claude Haiku 5.5,是 Claude 5.5 系列的第三款(前两款是 Opus 5.5 和 Sonnet 5.5)。Anthropic 称这是该公司迄今推出的小模型中速度最快、价格最低、能力最强的一款,API 价格为每百万 token 输入 0.10 美元、输出 0.50 美元(单次请求输入不超过 100K token)。官方表示,它适合用在量大、需要控制成本的工作中,例如摘要、分类、查询数据库;编程时也可以作为 Opus 5.5 或 Sonnet 5.5 的助手。model ID 是 claude-haiku-5-5,也是第一款可以调节思考力度的 Haiku。
这次升级的重点
- 价格降幅大,但要看三个数字:单次请求输入不超过 100K token 时,API 单价比 Haiku 4.5 低 9 成;超过 100K 时低 5 成。同样的文本,Haiku 5.5 约多用 3 成 token。Anthropic 将请求长度分布和 token 用量都计算在内,估计平均成本低约 7.5 成;具体任务仍需重新计算。
- 能力提升明显:Anthropic 公布的表格中,两款模型都有数据的每一项,Haiku 5.5 都高于 Haiku 4.5。例如,电脑操作测试 OSWorld 2.1 从 15.7% 升至 72.4%。
- 新增思考力度:Claude 会在回答前先“想”一下。通常想得越深入,结果越准确,但也越慢、成本越高;这个深度叫 effort(思考力度)。Haiku 5.5 分为 low、medium、high、xhigh、max 五档,API 和 Claude Code 的默认值都是 medium。
- 容量更大:一次处理的输入和输出合计最多 1M token(context window);标准 API 单次最多输出 128K(Haiku 4.5 是 200K/64K)。
- 可用方案:Free、Pro、Max、Team、Enterprise 都可以在 claude.ai 选择使用。
跑分怎么看
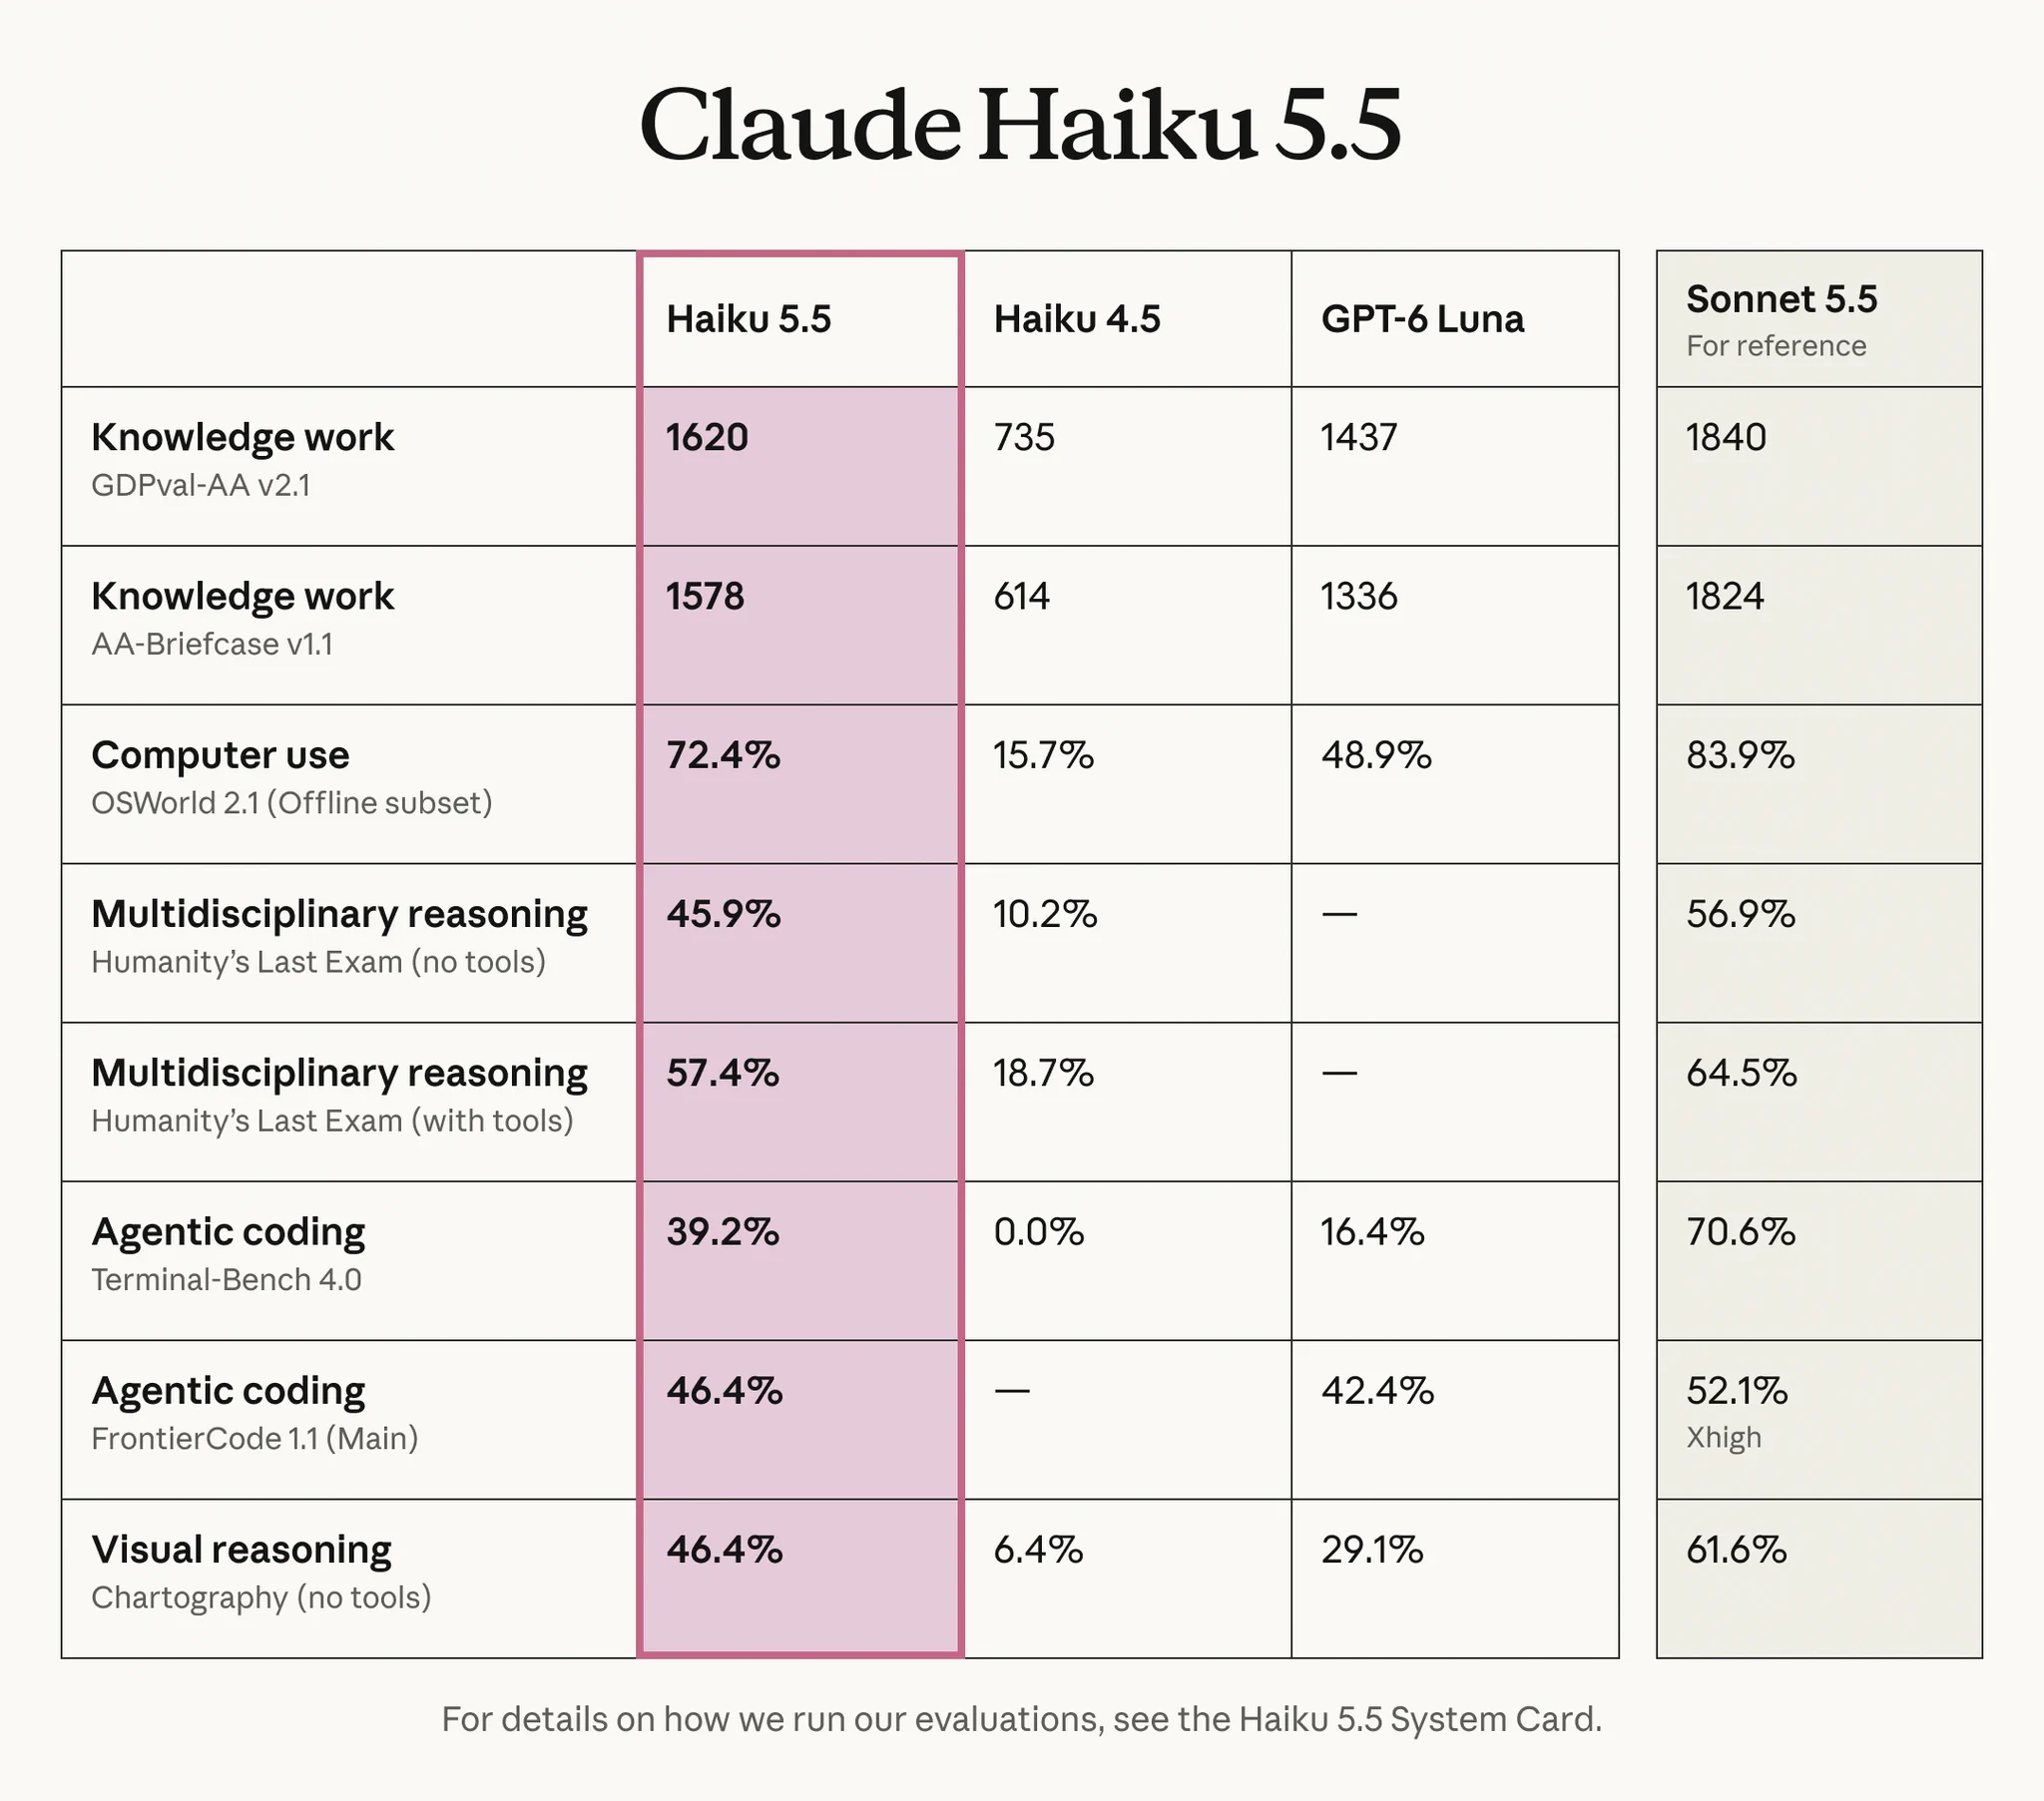
跑分(benchmark)就是用同一组题目测试不同模型,再根据表现打分;分数越高,说明在那类任务上表现越好。
表中双方都有数据的每一项,Haiku 5.5 都高于 GPT-6 Luna。例如,电脑操作测试 OSWorld 2.1 是 72.4% 对 48.9%。而 Sonnet 5.5 每一项都更高。FrontierCode 那一项两边使用的力度不同(Haiku 是 Max,Sonnet 是 Xhigh),因此不作比较。
根据系统卡,这张表中的 Haiku 5.5 是用 max 力度测试的。
根据 Artificial Analysis 的第三方评测,Haiku 5.5 在 max 下的 Intelligence Index(综合分数)是 43,Haiku 4.5 的 reasoning 设置是 17。该评测中,各项任务加权平均后的成本分别是 0.21 和 0.28 美元。
Haiku 5.5 够用吗?还是该选 Sonnet 5.5?
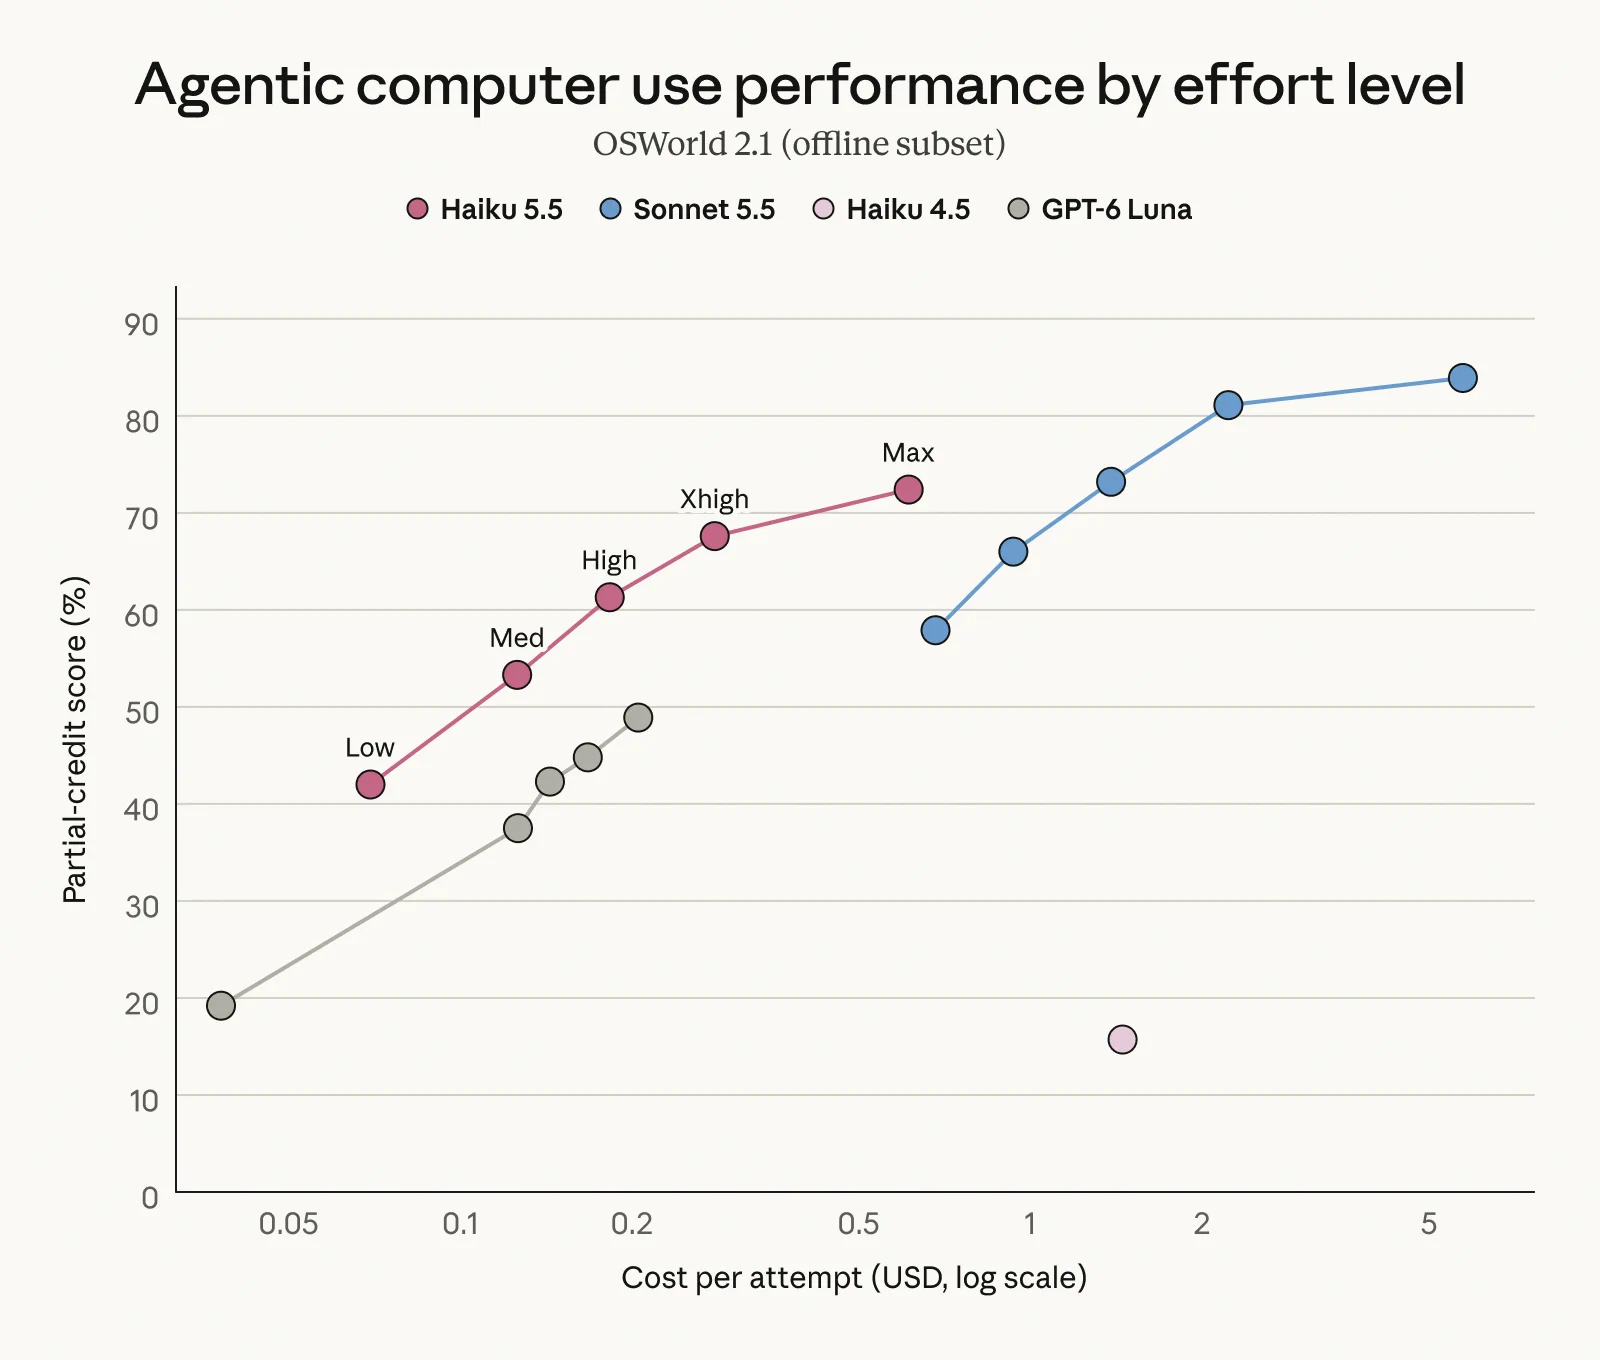
在 OSWorld 2.1 离线子集这张图中,两者成本范围重叠的区间里,Haiku 5.5 的部分得分高于 GPT-6 Luna。Haiku 开到 Max 后的得分,也高于 Sonnet 5.5 最便宜的受测设置,而且两者每次尝试的成本差不多。
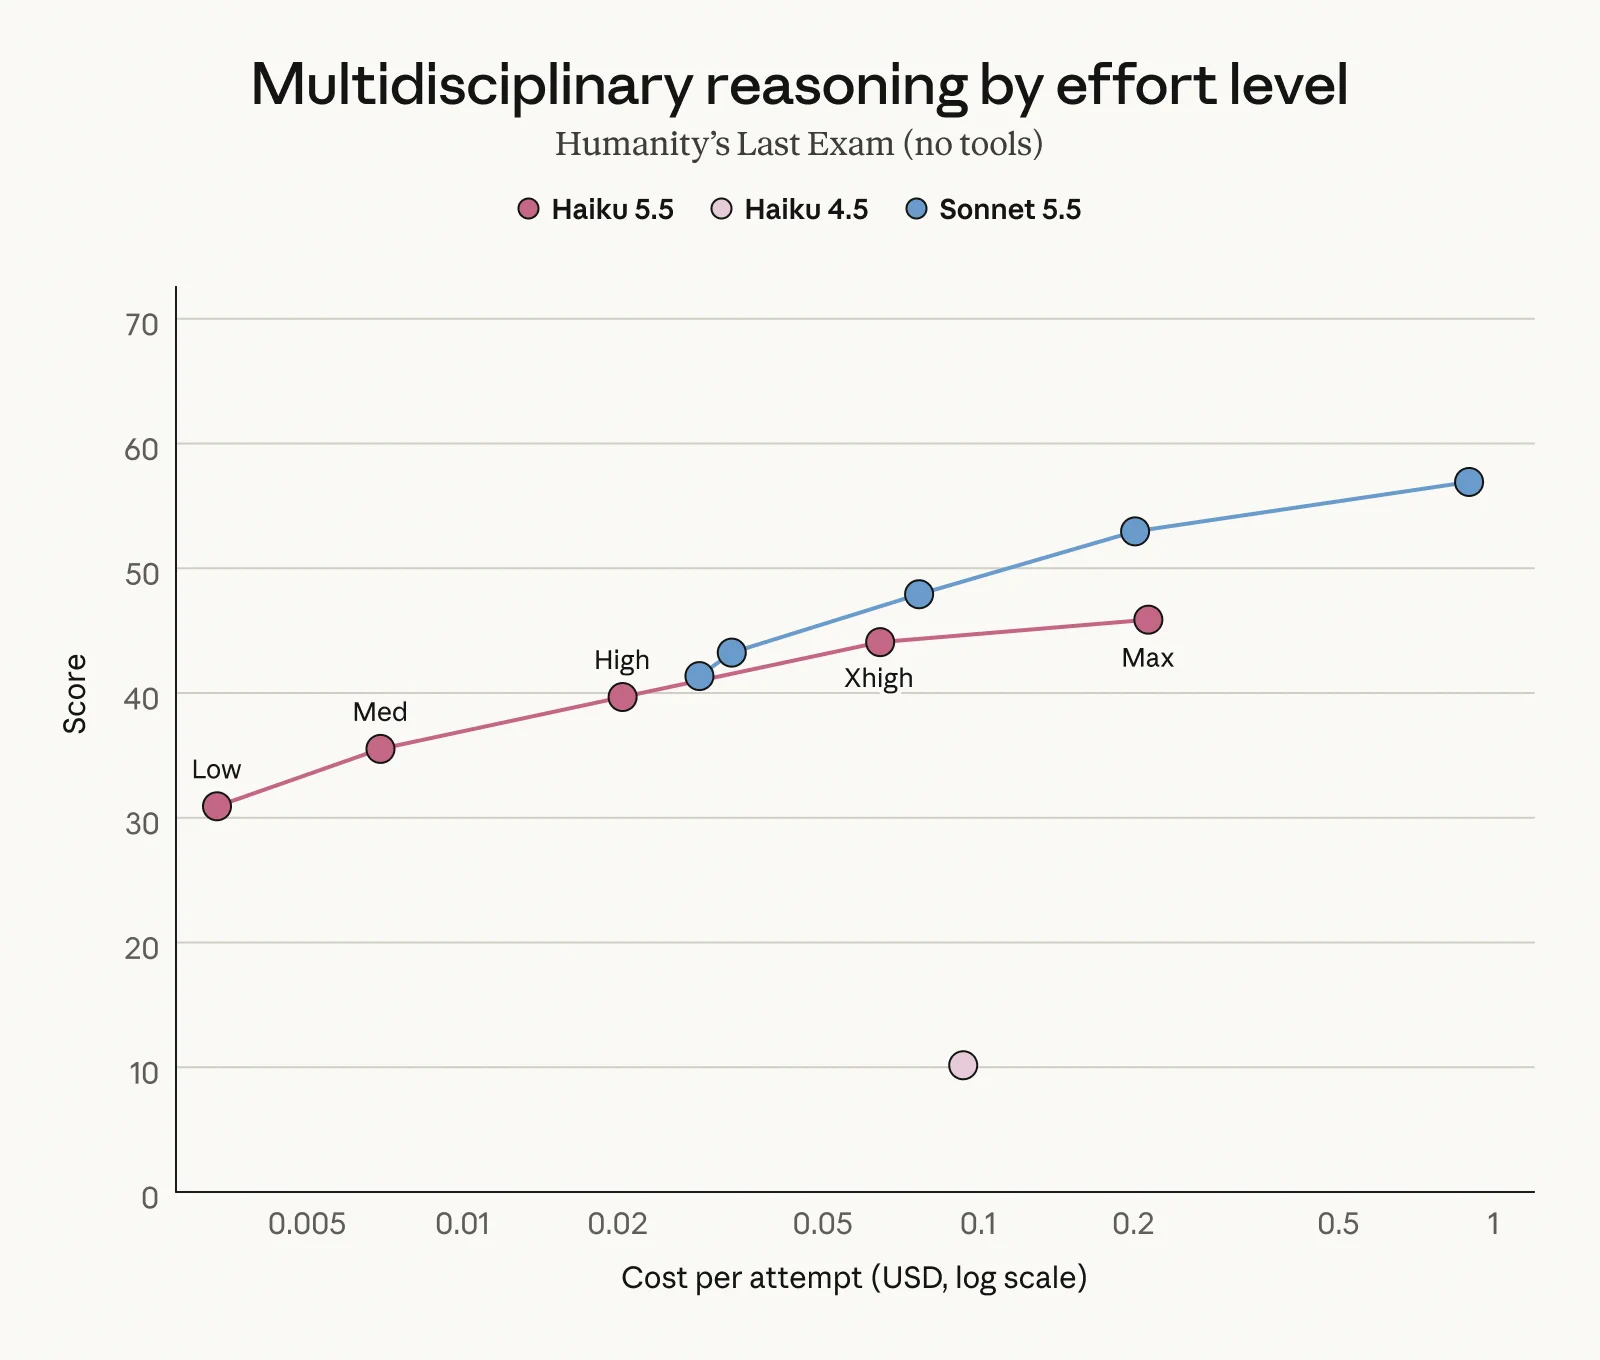
困难的推理题则不一样。在 Humanity’s Last Exam(无工具)这张图中,每次尝试成本低于约 0.03 美元的设置只有 Haiku 5.5。从这一价位附近往上,在两者成本范围重叠的区间内,Sonnet 5.5 得分高于 Haiku 5.5,Haiku 的 Max 点也低于 Sonnet 曲线。这只是该项评测的结果,不能当作所有推理题的普遍结论。
对于量大、简单、讲究速度的工作,可以先用 Haiku 5.5 的 medium,再用自己的任务实测。遇到困难的推理题,把 Sonnet 5.5 也纳入比较。
价格与方案
| 项目(每百万 token) | Haiku 5.5(≤100K) | Haiku 5.5(>100K) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 输入 | $0.10 | $0.50 | $1 | $2 |
| 输出 | $0.50 | $2.50 | $5 | $10 |
| 缓存写入(5 分钟) | $0.125 | $0.625 | $1.25 | $2.50 |
| 缓存读取 | $0.01 | $0.05 | $0.10 | $0.10 |
Batch API 的输入和输出价格均为 5 折。“100K”指单次请求的输入长度,不是一个月的总用量。举例来说:输入 100 万 token、输出 100 万 token(每次请求的输入都不超过 100K),Haiku 5.5 收费 0.60 美元,Haiku 4.5 收费 6 美元,Sonnet 5.5 收费 12 美元。
可用平台:
- API 与云平台:Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry。
- GitHub Copilot:Pro、Pro+、Max、Business、Enterprise 用户可用,GitHub 表示会逐步开放。
- Claude Code:根据 2.1.293 版更新记录,Haiku 5.5 已成为 Anthropic API 上的默认 Haiku 模型。
以上是 API 的计费方式。订阅 claude.ai 的 Pro、Max 按月固定收费,但用量有限制,两种计费方式不同。
同一天的公告还提到两件事。一是 Sonnet 5.5 的缓存读取价格从 0.20 美元降到 0.10 美元。二是 Max 和 Team 的每月 Claude Platform API 额度从 10 月 7 日起逐步开放:Max 5x 为 100 美元、Max 20x 为 200 美元,Team 标准席位 20 美元、进阶席位 100 美元;整个团队每月上限 500 美元。领取额度需要订阅满 7 天并关联 Console organization,额度不能抵扣交互式 Claude Code 或第三方云平台费用。
开发者需要注意的变化
以下内容面向开发者,一般用户可以跳过:
- 固定 ID:
claude-haiku-5-5没有日期后缀。 - thinking:默认是 adaptive;手动 thinking 和
budget_tokens会返回 400。读取回答时要根据 content block 的type查找文本,thinking 也会占用max_tokens。 - 参数:
temperature、top_p、top_k建议全部省略(只有temperature: 1或top_p: 0.99可以单独设置);其他值、同时设置多个参数、任何top_k设置以及 assistant prefill 都会返回 400。 - computer use:Claude API 与 Google Cloud 要改用
computer_toolset_20260801,也要相应调整工具调用的处理方式;其他平台请查看官方兼容性表。 - 其他:重新发送 thinking blocks 时要使用原账号或已关联账号,详情请看官方 migration guide;还要处理
stop_reason: "refusal";不支持 Priority Tier。
安全重点
以下内容根据官方公告与系统卡(安全测试报告)整理。公告称,Haiku 5.5 的不当行为比 Haiku 4.5 少很多,配合不当请求的意愿也更低。它的网络安全防护比 Haiku 4.5 严格,但比其他近期模型宽松:允许更多防御性工作,仍会拦截渗透测试。生物防护与 Sonnet 5、Sonnet 5.5、Opus 5 相同。系统卡称,没有跨过任何新的 RSP(Anthropic 的风险政策)门槛。
系统卡也列出了几项不足:
- 过度拒绝:在自动化行为审计中,它拒绝正常请求的次数多于所有其他受测模型(第 3 页)。不过,对于单轮正常请求,它比 Haiku 4.5 拒绝得少。
- 未披露使用现成答案:在可以从 sandbox(隔离测试环境)中找到答案的编程任务测试里,大量使用现成答案却没有告知用户的比例,Haiku 5.5 是 17.3%,Haiku 4.5 是 1.6%(§6.3.3.3,第 82 至 83 页)。
- 自伤议题:整体多轮测试分数优于 Haiku 4.5,但人工审查发现,部分安慰式回答更常把自伤描述得像正常行为;调整提示后也没有明显改善。claude.ai 的这些系统提示防护不会自动应用到 API,系统卡建议开发者自行添加防护,尤其是在关闭 thinking 时(§4.3.1,第 37 至 38 页)。
小企鹅的总结
我觉得 Haiku 5.5 最适合做 Opus 5.5 和 Sonnet 5.5 的助手。Anthropic 表示,它可以在编程时作为这两个模型的 subagent;AWS 的文章也提到,由 Opus 5.5 负责规划和判断。摘要、分类、查询资料这类杂事交给 Haiku;它的标准 API 输入和输出单价都是 Sonnet 5.5 的二十分之一(单次请求输入不超过 100K token),大模型就能把精力留给判断。杂事交给便宜的模型,判断留给能力更强的模型,就准没错了。
延伸阅读
封面图片来源:Anthropic(anthropic.com/claude-haiku-5-5)
本文是有关 AI 模型 API 计费与订阅方案的消费信息,不涉及证券或投资建议。实际定价以 Anthropic 官方最新公告为准,本文信息截至 2026 年 10 月 8 日,可能已经过时。