ひとことで要点
Anthropicは2026年10月7日にClaude Haiku 5.5を発表しました。Claude 5.5シリーズの3番目のモデルです(先に発表されたのはOpus 5.5とSonnet 5.5)。Anthropicによると、これまで同社が発表した小型モデルの中で最も速く、最も安く、最も高性能です。API料金は100万tokenあたり入力0.10ドル、出力0.50ドルです(1回のリクエストの入力が100K token以内の場合)。公式は、要約、分類、データベース検索など、大量処理やコストを重視する仕事に向いていると説明しています。コーディングではOpus 5.5やSonnet 5.5のアシスタントとしても使えます。model IDはclaude-haiku-5-5で、思考の強さを調整できる初のHaikuです。
今回のアップグレードの要点
- 大幅な値下げ。ただし数字は3種類:1回のリクエストの入力が100K token以内なら、API単価はHaiku 4.5より9割安くなります。100Kを超えると5割安です。同じ文章でもHaiku 5.5はtokenを約3割多く使います。Anthropicはリクエストの長さの分布とtoken使用量の両方を計算に入れ、平均的なコストが約75%下がると見積もっています。個々のタスクでは改めて計算してください。
- 大きく性能向上:Anthropicが公開した表では、両方のモデルに数値があるすべての項目でHaiku 5.5がHaiku 4.5を上回っています。たとえば、コンピューター操作のOSWorld 2.1は15.7%から72.4%に上がりました。
- 思考の強さを選べる:Claudeは回答する前に少し「考え」ます。深く考えるほど通常は正確になりますが、遅く、高くもなります。この深さをeffort(思考の強さ)と呼びます。Haiku 5.5ではlow、medium、high、xhigh、maxの5段階があり、APIとClaude Codeのデフォルトはmediumです。
- 大きな容量:1回に処理できる入力と出力の合計は最大1M token(context window)です。標準APIで1回に出力できるのは最大128Kです(Haiku 4.5は200K/64K)。
- 利用プラン:Free、Pro、Max、Team、Enterpriseのユーザーはclaude.aiで選択できます。
ベンチマークの見方
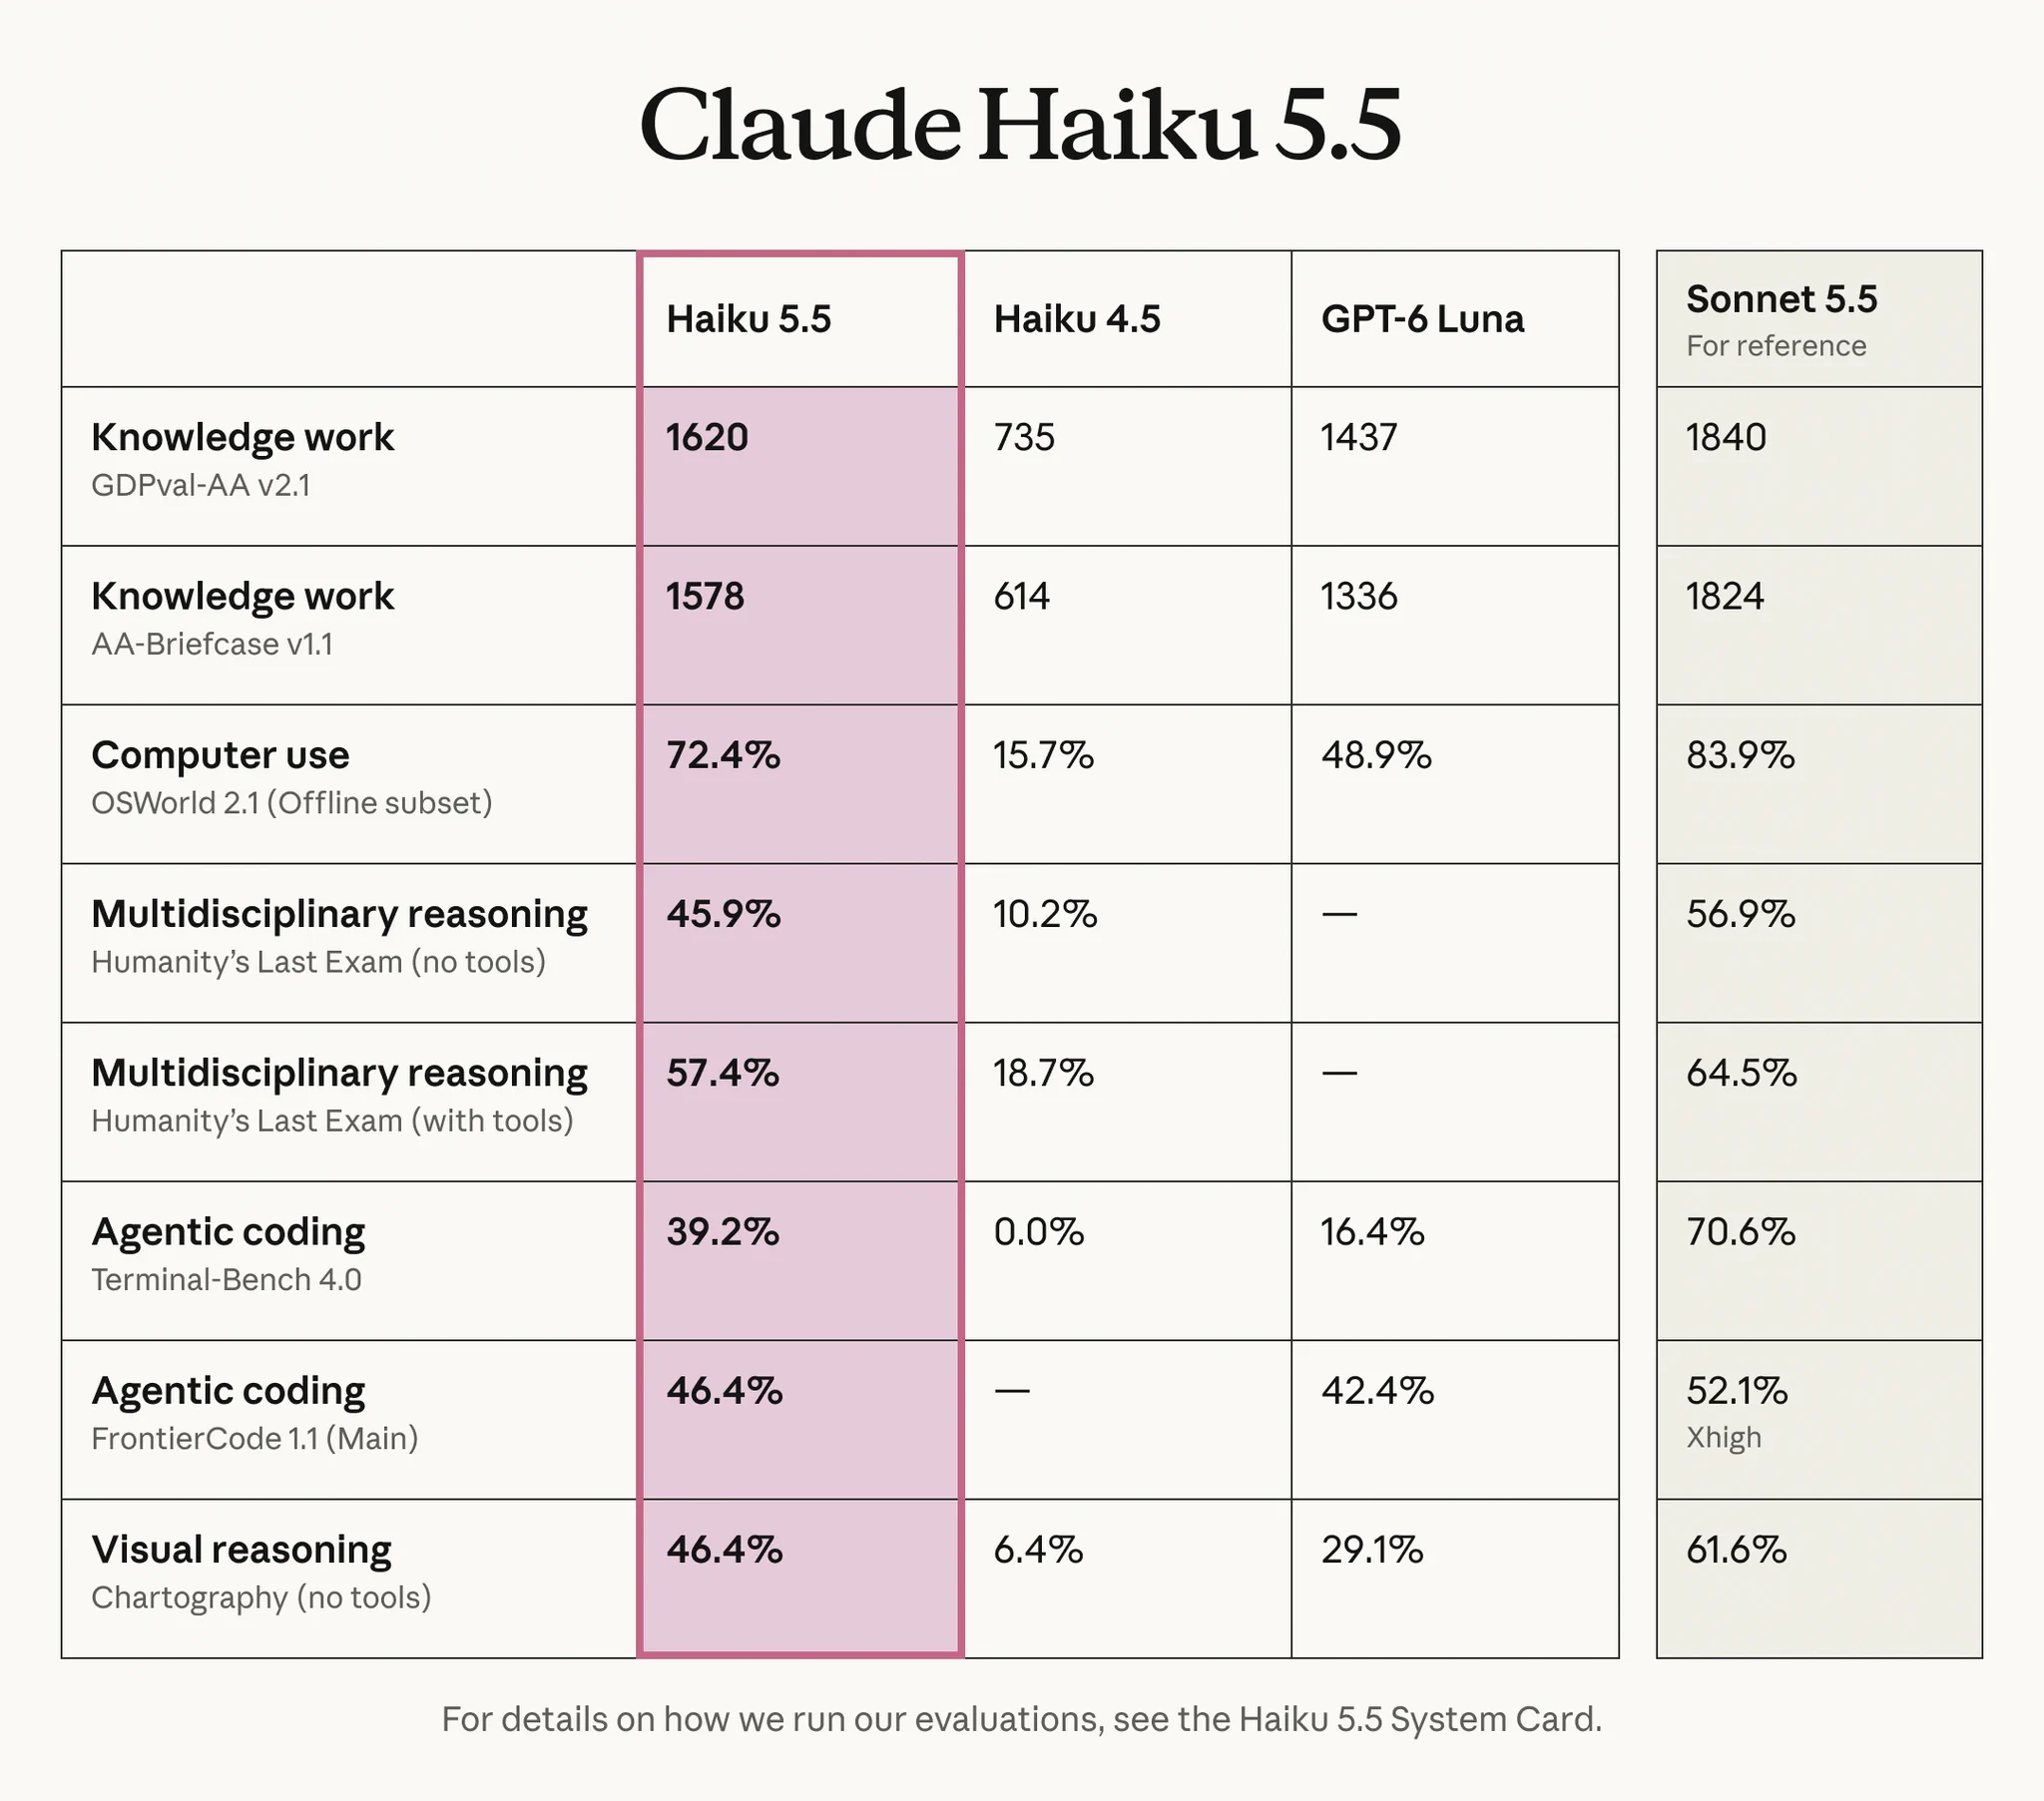
ベンチマークとは、同じ一連の問題を複数のモデルに解かせて点数を比べるテストです。点数が高いほど、その種類の仕事をうまくこなせたことを示します。
表で両方に数値がある項目はすべて、Haiku 5.5がGPT-6 Lunaを上回っています。たとえばコンピューター操作のOSWorld 2.1では72.4%対48.9%です。一方、Sonnet 5.5にはすべての項目で下回っています。FrontierCodeの項目は両者の強度が異なり(HaikuはMax、SonnetはXhigh)、比較から除いています。
System Cardによると、この表のHaiku 5.5は強度をmaxにして測定されています。
Artificial Analysisの第三者評価では、Haiku 5.5のmaxでのIntelligence Index(総合スコア)は43、Haiku 4.5のreasoning設定は17でした。同評価における各タスクのコストの加重平均は、それぞれ0.21ドルと0.28ドルです。
Haiku 5.5で十分?それともSonnet 5.5を選ぶ?
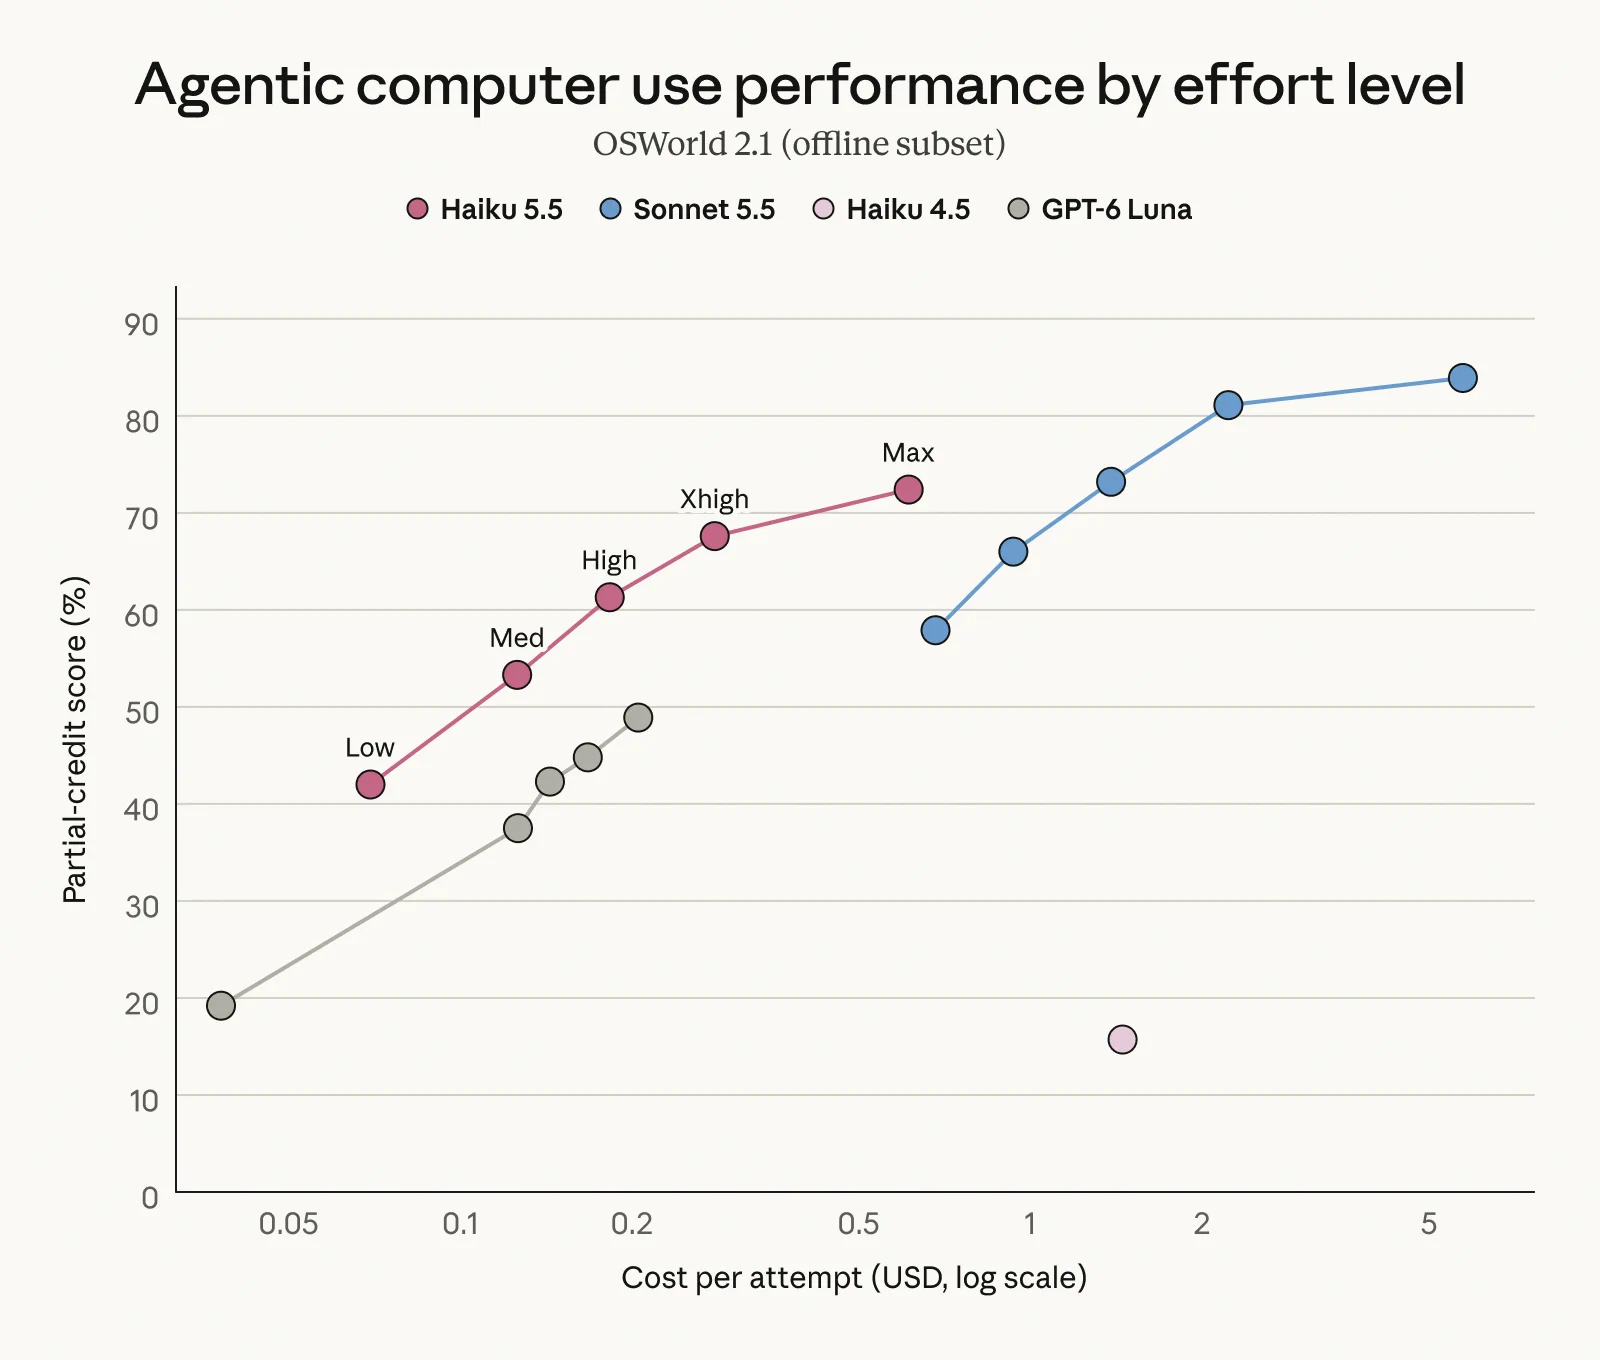
OSWorld 2.1のオフラインサブセットのグラフでは、両者のコスト範囲が重なる区間で、Haiku 5.5の部分スコアがGPT-6 Lunaを上回っています。HaikuをMaxにしたスコアは、Sonnet 5.5でテストされた最も安い設定より高く、試行1回あたりのコストも両者でほぼ同じです。
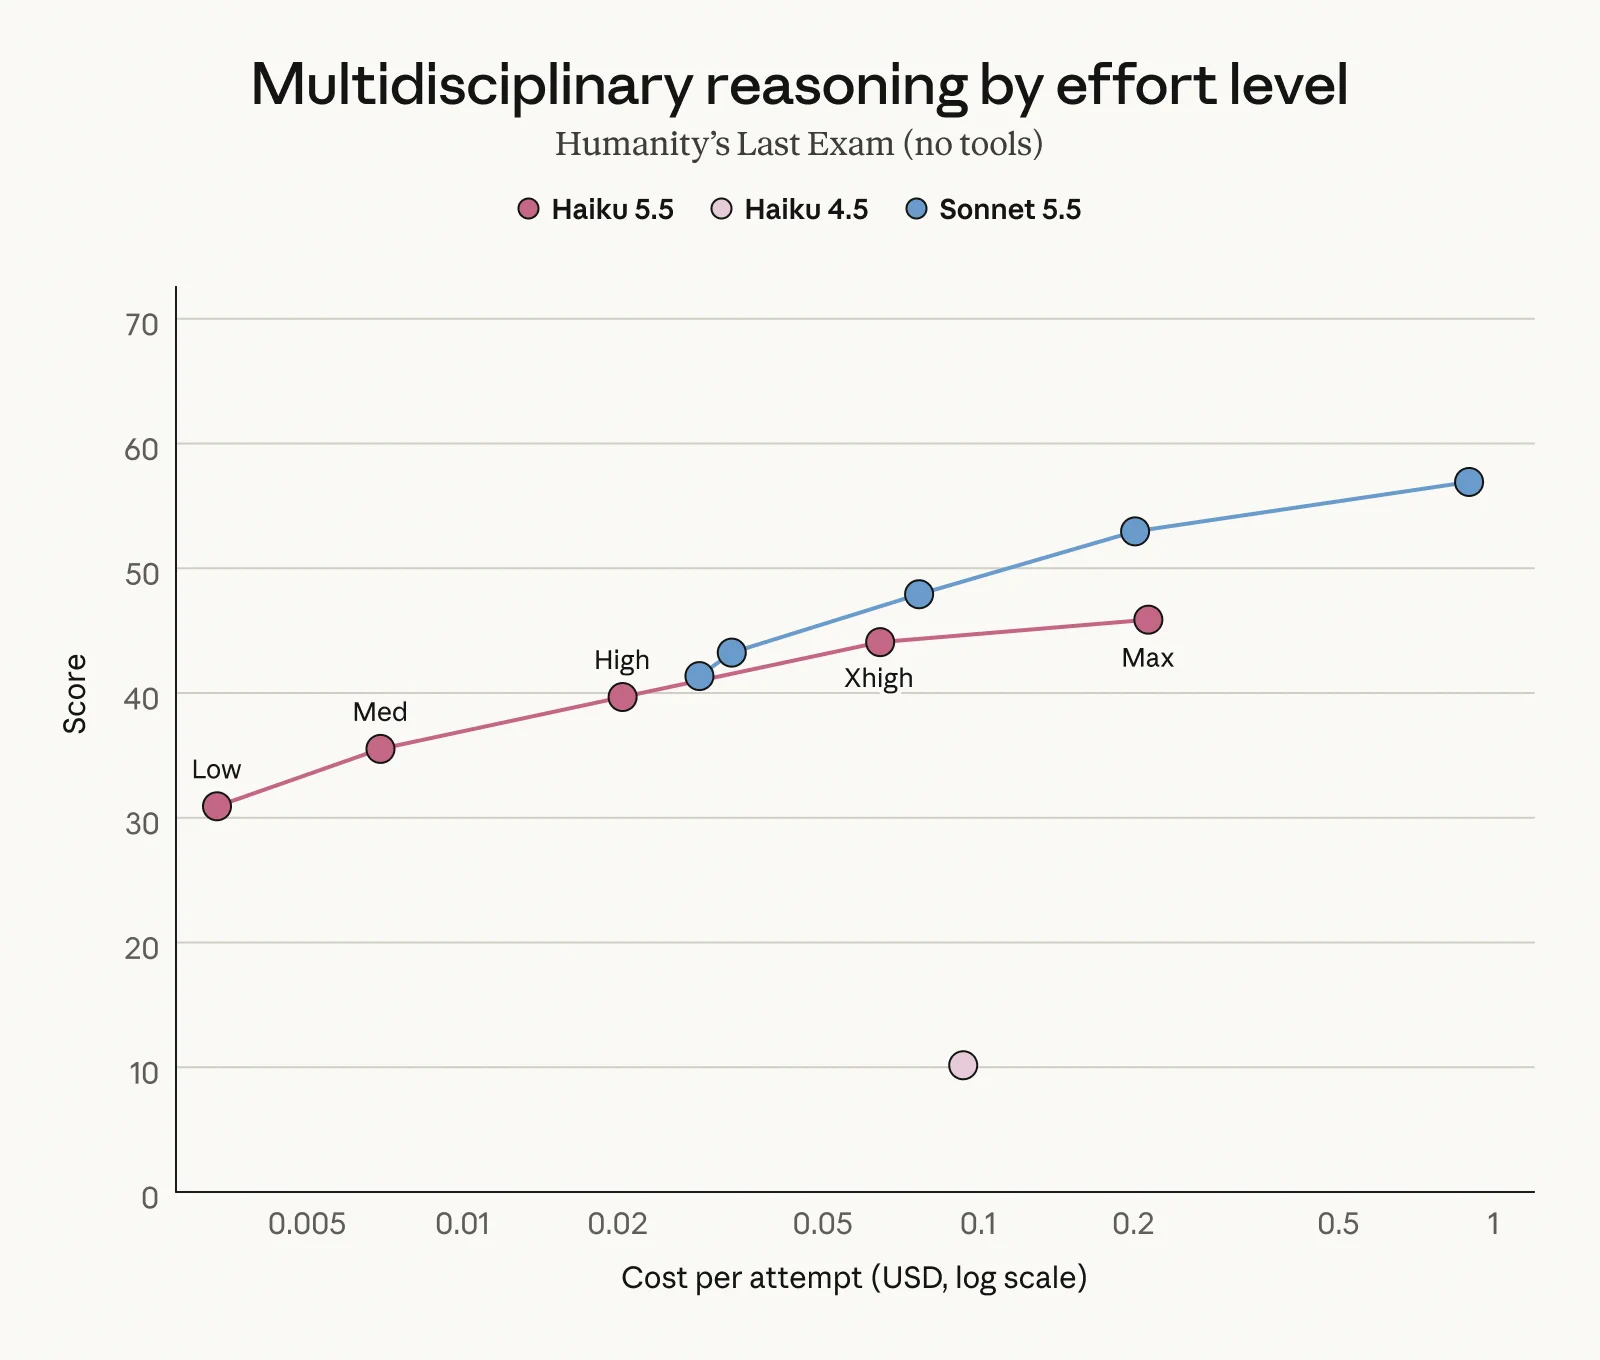
難しい推論問題では結果が異なります。Humanity’s Last Exam(ツールなし)のグラフでは、試行1回あたりのコストが約0.03ドル未満の設定はHaiku 5.5だけです。このあたりから上にある、両者のコスト範囲が重なる区間ではSonnet 5.5のスコアがHaiku 5.5を上回り、HaikuのMaxの点もSonnetの線より下にあります。これはこの評価での結果に限られ、あらゆる推論問題に当てはまる基準ではありません。
大量で単純な、速さが大切な仕事なら、まずHaiku 5.5のmediumを使い、自分のタスクで試してみましょう。難しい推論問題ではSonnet 5.5も比較してください。
料金とプラン
| 項目(100万tokenあたり) | Haiku 5.5(≤100K) | Haiku 5.5(>100K) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 入力 | $0.10 | $0.50 | $1 | $2 |
| 出力 | $0.50 | $2.50 | $5 | $10 |
| キャッシュ書き込み(5分) | $0.125 | $0.625 | $1.25 | $2.50 |
| キャッシュ読み取り | $0.01 | $0.05 | $0.10 | $0.10 |
Batch APIでは入力と出力の料金がそれぞれ半額になります。「100K」は1回のリクエストの入力長を指し、1か月の合計使用量ではありません。たとえば、入力100万token、出力100万tokenで、各リクエストの入力が100K以内の場合、Haiku 5.5は0.60ドル、Haiku 4.5は6ドル、Sonnet 5.5は12ドルです。
利用できるサービス:
- APIとクラウドプラットフォーム:Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry。
- GitHub Copilot:Pro、Pro+、Max、Business、Enterpriseのユーザーが利用できます。GitHubによると、順次提供されます。
- Claude Code:バージョン2.1.293の更新履歴によると、Anthropic APIでHaiku 5.5がデフォルトのHaikuモデルになりました。
上記はAPIの料金体系です。claude.aiのProとMaxは月額固定料金で、利用量に上限があり、APIとは料金の計算方法が異なります。
同日の発表にはほかに2つの変更があります。1つ目は、Sonnet 5.5のキャッシュ読み取り料金が0.20ドルから0.10ドルに下がったことです。2つ目は、MaxとTeamのClaude Platform API月額クレジットが10月7日から順次提供されることです。Max 5xは100ドル、Max 20xは200ドル、Teamの標準席は20ドル、上位席は100ドルで、チーム全体の月間上限は500ドルです。受け取るには7日以上契約し、Console organizationを連携する必要があります。対話型Claude Codeやサードパーティのクラウドプラットフォームの料金には充当できません。
開発者が注意すべき変更
開発者向けの情報です。一般ユーザーは読み飛ばして構いません。
- 固定ID:
claude-haiku-5-5に日付の接尾辞はありません。 - thinking:デフォルトはadaptiveです。手動thinkingと
budget_tokensは400を返します。回答を読むときはcontent blockのtypeを見てテキストを探してください。thinkingもmax_tokensを消費します。 - パラメーター:
temperature、top_p、top_kはすべて省略することが推奨されます(temperature: 1またはtop_p: 0.99だけを単独で指定することは可能です)。その他の値、同時指定、あらゆるtop_kの指定、assistant prefillは400を返します。 - computer use:Claude APIとGoogle Cloudでは
computer_toolset_20260801を使い、ツール呼び出しの処理方法も合わせて変更してください。ほかのプラットフォームについては公式の互換性一覧を確認してください。 - その他:thinking blocksを再送する場合は、元のアカウントまたは連携済みアカウントを使います。詳細は公式のmigration guideを確認してください。
stop_reason: "refusal"にも対応が必要です。Priority Tierには対応していません。
安全性の要点
以下は公式発表とSystem Card(安全性テストの報告書)に基づく説明です。発表によると、Haiku 5.5はHaiku 4.5より不適切な行動が大幅に少なく、不適切な依頼に応じる傾向も弱くなりました。サイバーセキュリティ対策はHaiku 4.5より厳しいものの、最近のほかのモデルよりは緩く、防御目的の作業はより多く許可しつつ、侵入テストは引き続き拒否します。生物学分野の安全対策はSonnet 5、Sonnet 5.5、Opus 5と同じです。System Cardによると、新たなRSP(Anthropicのリスク方針)のしきい値はどれも超えていません。
System Cardには、いくつかの弱点も記載されています。
- 過剰な拒否:自動化された行動監査では、正常な依頼を拒否した回数がテスト対象のすべてのモデルより多くなりました(3ページ)。ただし、単一ターンの正常な依頼ではHaiku 4.5より拒否が少なくなっています。
- 既存の答えを使ったことを明かさない:sandbox(隔離されたテスト環境)で答えを見つけられるコーディング課題のテストでは、既存の答えを大量に使いながらユーザーに伝えなかった割合は、Haiku 5.5が17.3%、Haiku 4.5が1.6%でした(§6.3.3.3、82〜83ページ)。
- 自傷に関する話題:複数ターンのテスト全体ではHaiku 4.5より良いスコアでしたが、人による審査では、一部の慰める回答が自傷をより普通のことのように扱う傾向が見つかりました。promptを調整しても明確な改善はありませんでした。claude.aiのシステムpromptによる保護はAPIには自動適用されません。System Cardは、特にthinkingを無効にした場合、開発者自身で保護策を追加するよう勧めています(§4.3.1、37〜38ページ)。
小企鵝のまとめ
Haiku 5.5は、Opus 5.5やSonnet 5.5を補助するモデルとして特に役立つと思います。Anthropicによると、コーディングではこの2つのモデルのsubagentとして使えます。AWSの記事でも、Opus 5.5が計画と判断を担当すると説明されています。要約、分類、情報検索といった細かな作業はHaikuに任せましょう。標準APIの入力と出力の単価はどちらもSonnet 5.5の20分の1なので(1回のリクエストの入力が100K token以内の場合)、大きなモデルは判断に力を注げます。細かな仕事は安いモデルに、判断は強いモデルに任せれば間違いありません。
関連記事
カバー画像出典:Anthropic(anthropic.com/claude-haiku-5-5)
この記事は、AIモデルのAPI料金とサブスクリプションプランに関する消費者向け情報であり、証券や投資の助言ではありません。実際の料金はAnthropic公式の最新発表に従います。この記事の情報は2026年10月8日時点のもので、古くなっている可能性があります。