一句話重點
Anthropic 在 2026 年 10 月 7 日推出 Claude Haiku 5.5,是 Claude 5.5 系列的第三款(前兩款是 Opus 5.5 和 Sonnet 5.5)。Anthropic 說它是該公司至今推出的小模型中,最快、最便宜、能力最強的一款,API 價格是每百萬 token 輸入 0.10 美元、輸出 0.50 美元(一次請求的輸入在 100K token 以內)。官方說它適合量大、要省錢的工作,例如摘要、分類、查資料庫,寫程式時也能當 Opus 5.5 或 Sonnet 5.5 的小幫手。model ID 是 claude-haiku-5-5,也是第一款能調整思考力度的 Haiku。
這次升級重點
- 價格降很多,但有三個數字:一次請求的輸入在 100K token 以內,API 單價比 Haiku 4.5 低 9 成;超過 100K,低 5 成。同樣的文字,Haiku 5.5 約多用 3 成 token。Anthropic 把請求長度分布與 token 用量都算進去,估計平均成本低約 7.5 成;個別任務仍要重算。
- 大幅進步:Anthropic 公布的表格裡,兩者都有數字的每一列,Haiku 5.5 都比 Haiku 4.5 高,例如電腦操作 OSWorld 2.1 從 15.7% 升到 72.4%。
- 多了思考力度:Claude 回答前會先「想」一下。想得越深通常越準,也越慢越貴,這個深度叫 effort(思考力度)。Haiku 5.5 分 low、medium、high、xhigh、max 五級,API 與 Claude Code 預設 medium。
- 更大的容量:一次處理的輸入與輸出合計最多 1M token(context window),標準 API 一次最多輸出 128K(Haiku 4.5 是 200K/64K)。
- 方案:Free、Pro、Max、Team、Enterprise 都可以在 claude.ai 選用。
跑分怎麼看
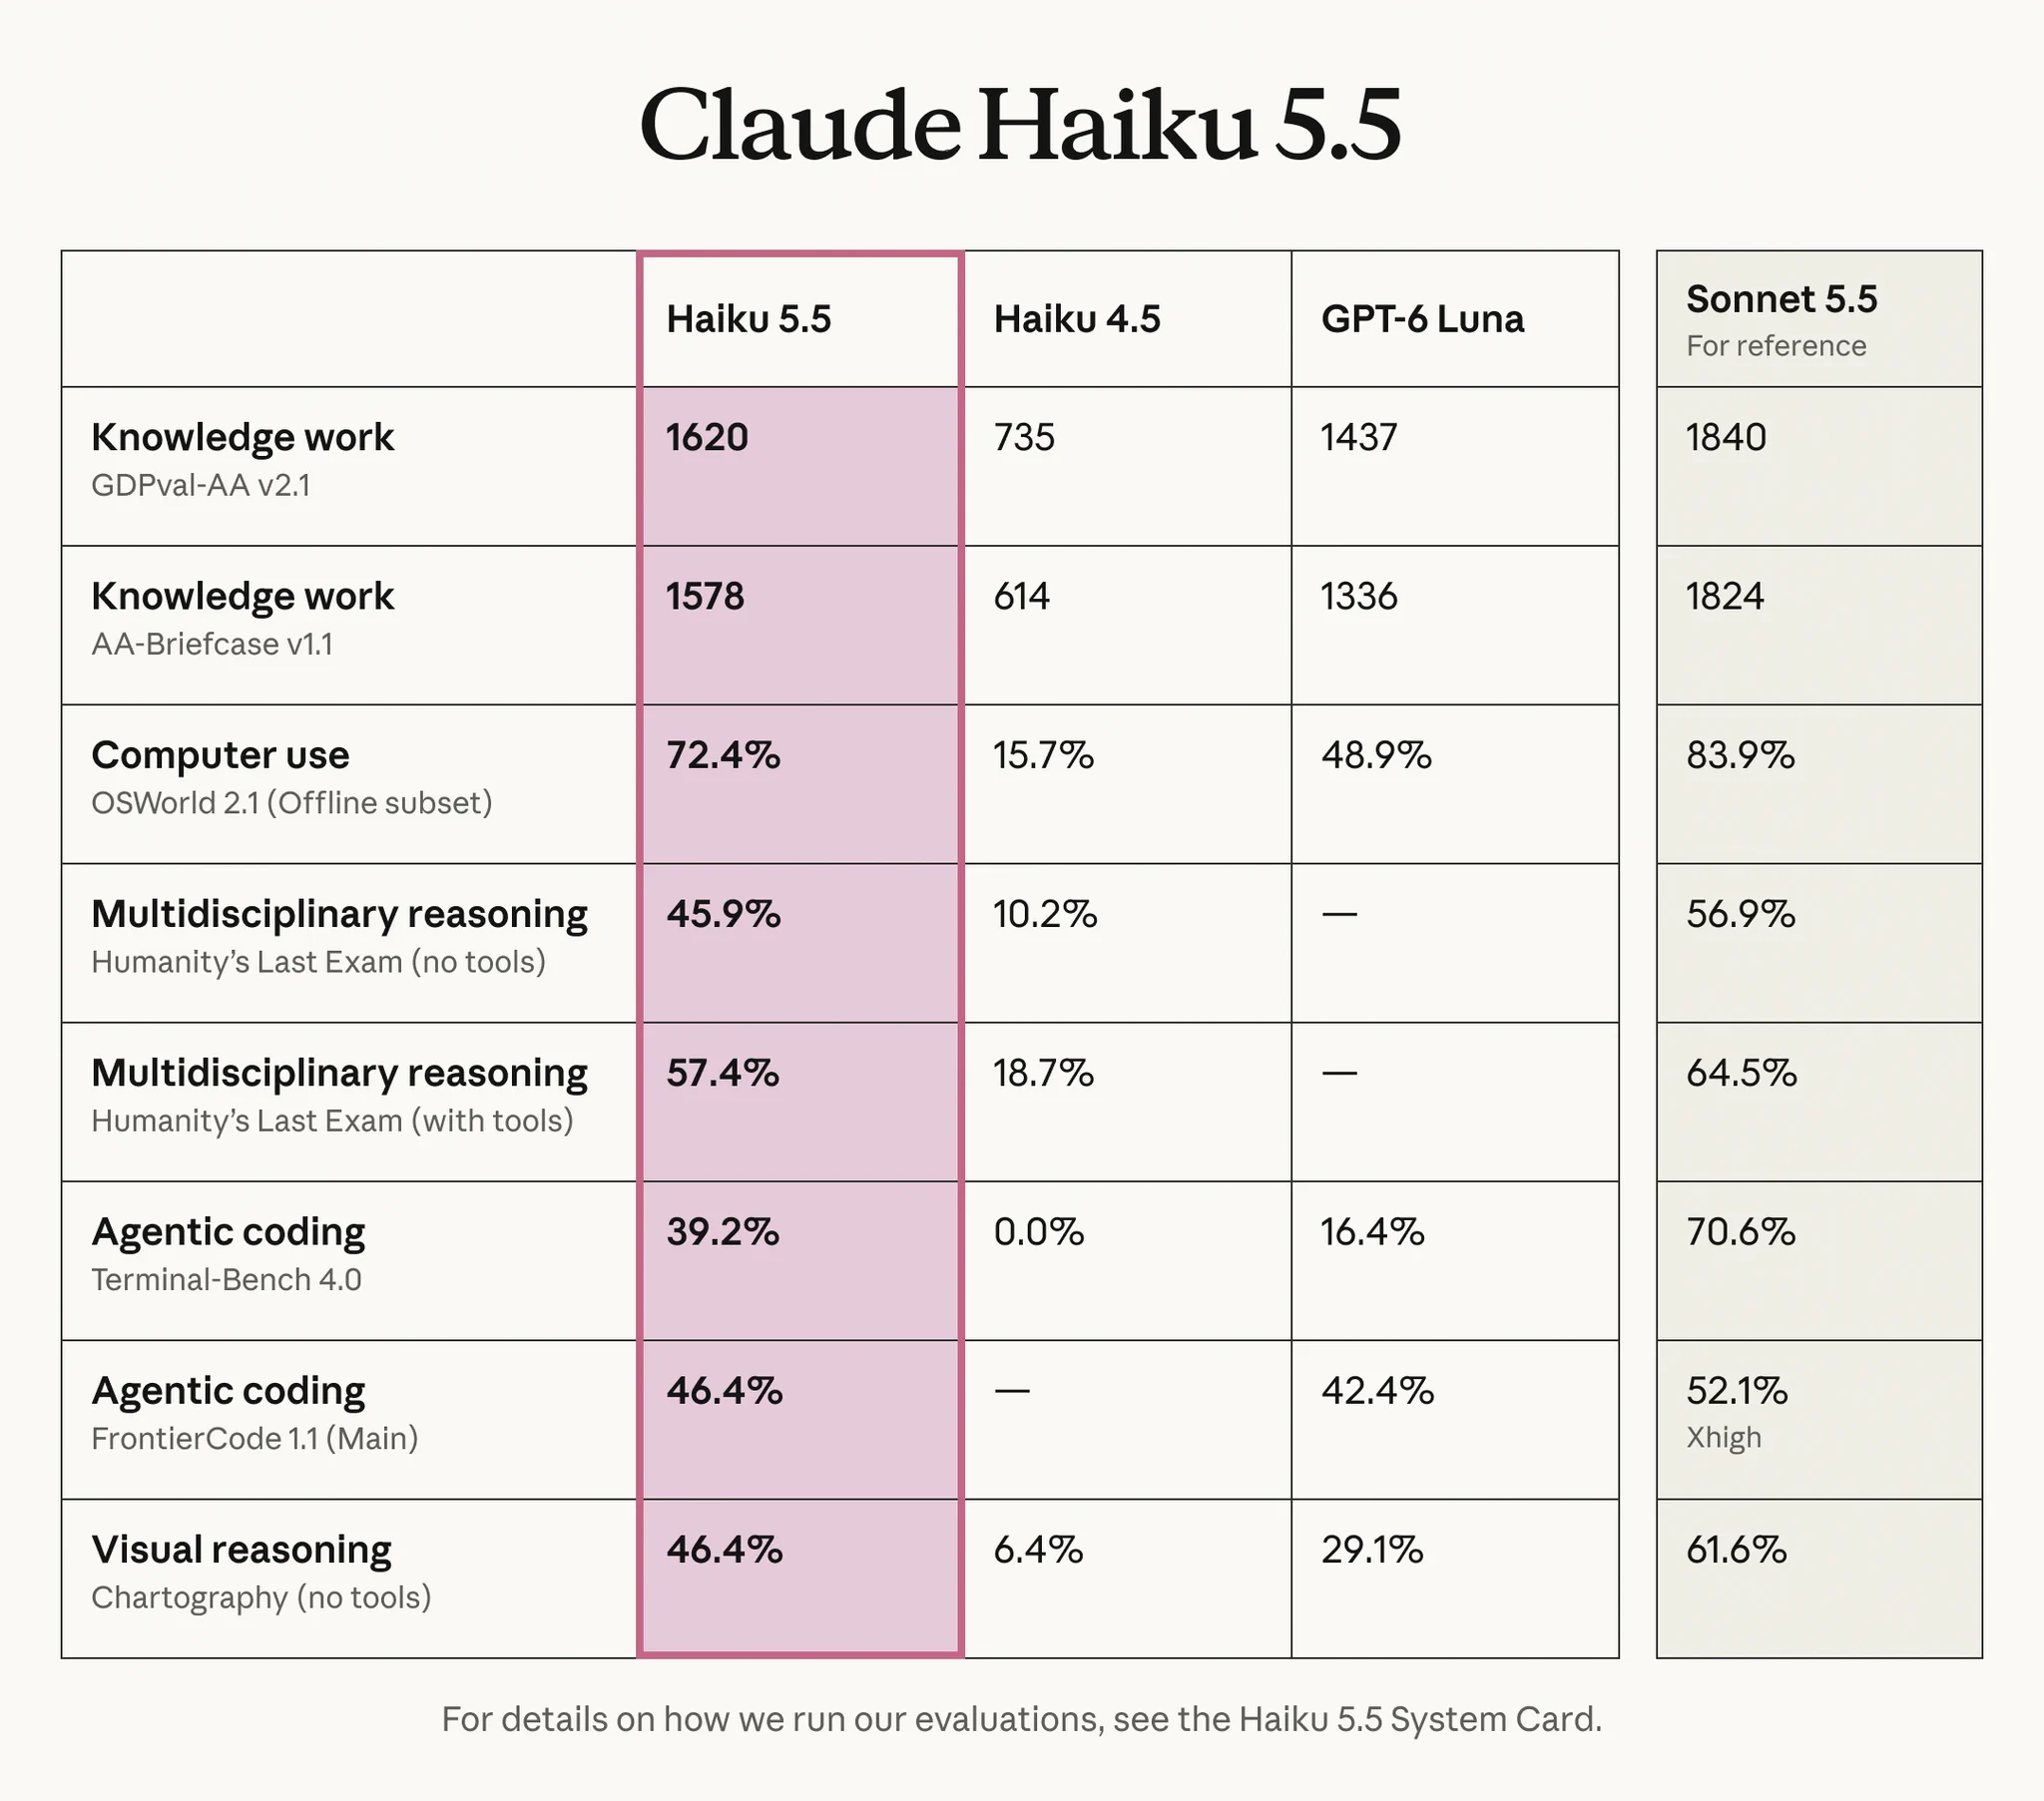
跑分(benchmark)是拿同一組題目給不同模型做,再打分數,分數越高代表那類工作做得越好。
表中雙方都有數字的每一列,Haiku 5.5 都高過 GPT-6 Luna。例如電腦操作 OSWorld 2.1 是 72.4% 對 48.9%。對 Sonnet 5.5 則每一列都比較低。FrontierCode 那列兩邊的力度不同(Haiku 是 Max,Sonnet 是 Xhigh),不拿來比。
根據系統卡,這張表的 Haiku 5.5 是開到 max 力度跑的。
根據 Artificial Analysis 的第三方評測,Haiku 5.5 在 max 的 Intelligence Index(綜合分數)是 43,Haiku 4.5 的 reasoning 設定是 17。該評測每項任務的加權平均成本,分別是 0.21 與 0.28 美元。
Haiku 5.5 夠用嗎?還是要上 Sonnet 5.5?
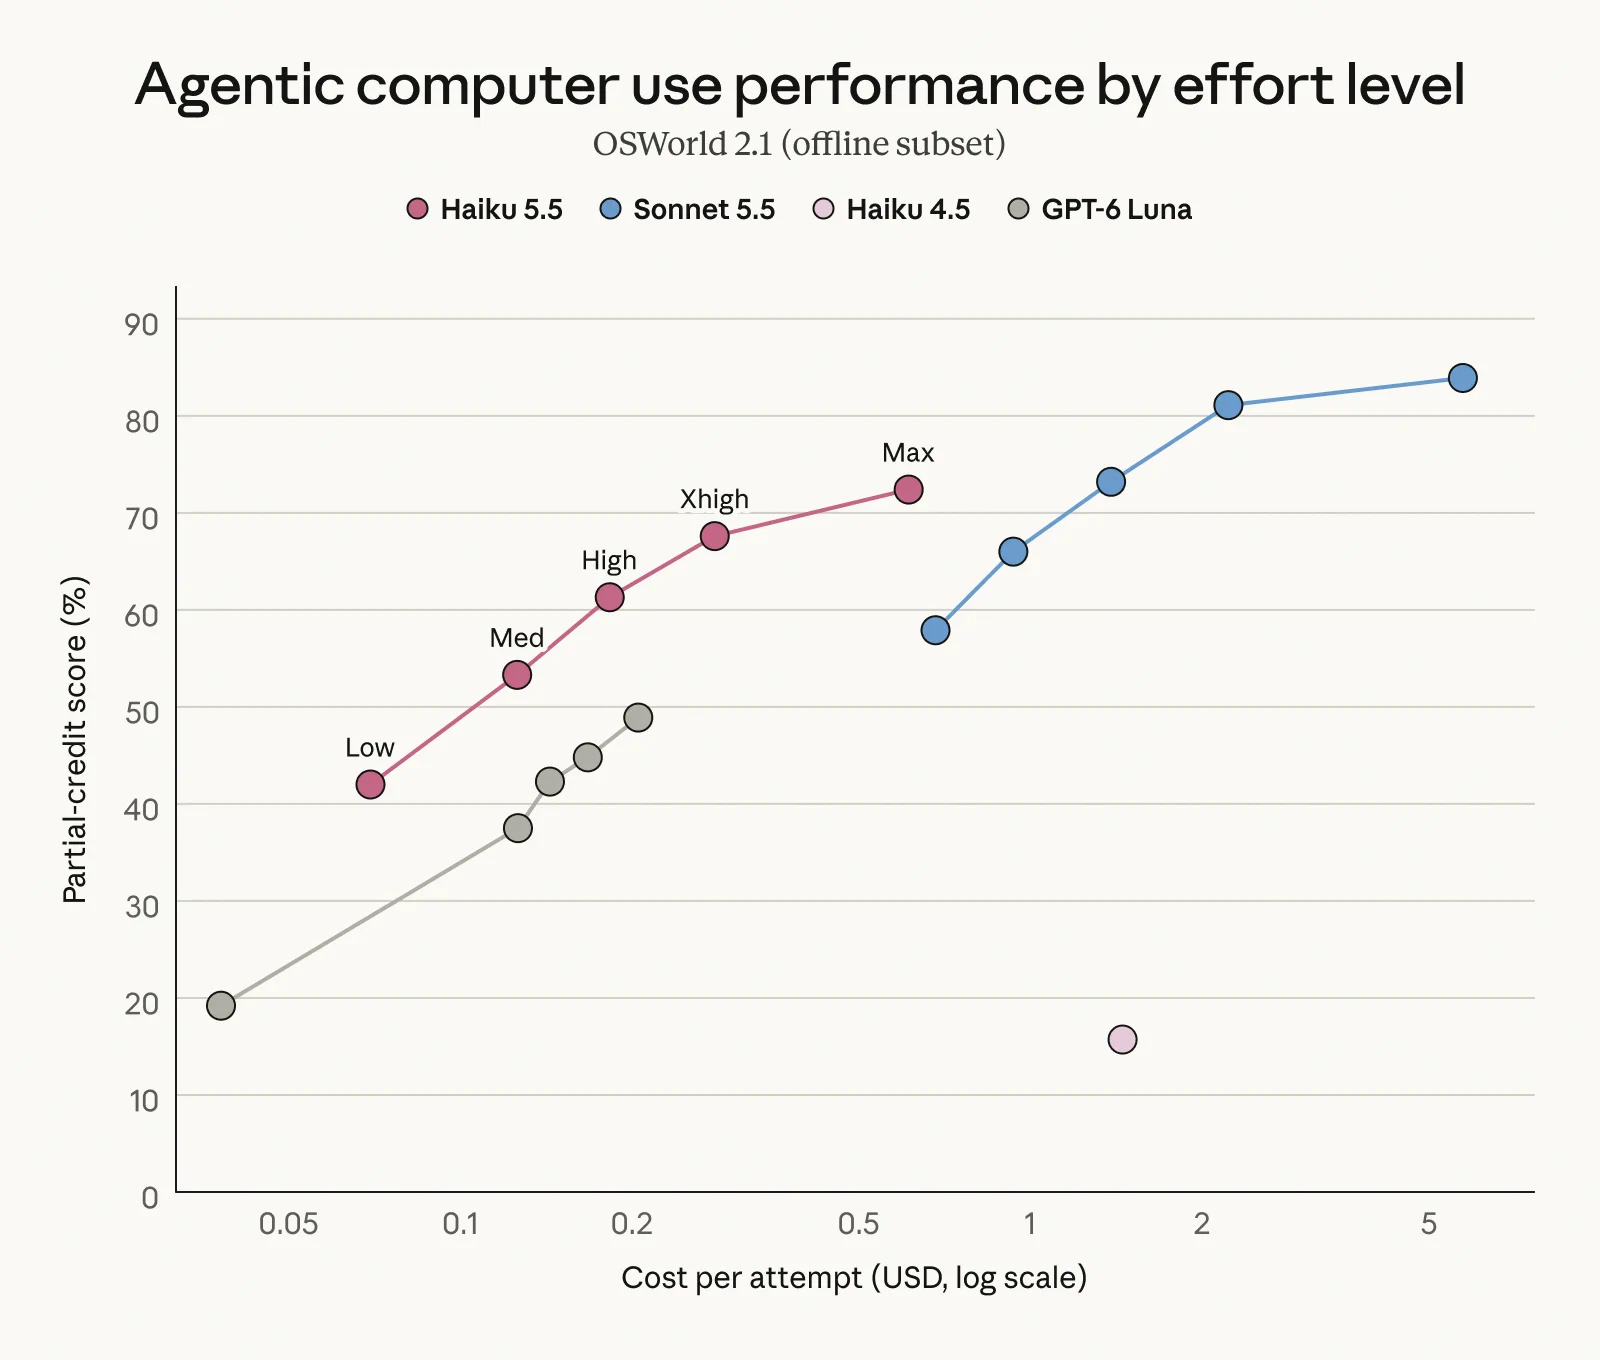
在 OSWorld 2.1 離線子集這張圖中,兩者成本範圍重疊的區間,Haiku 5.5 的部分得分高於 GPT-6 Luna。Haiku 開到 Max 的得分,也高於 Sonnet 5.5 最便宜的受測設定,而且兩者每次嘗試的成本差不多。
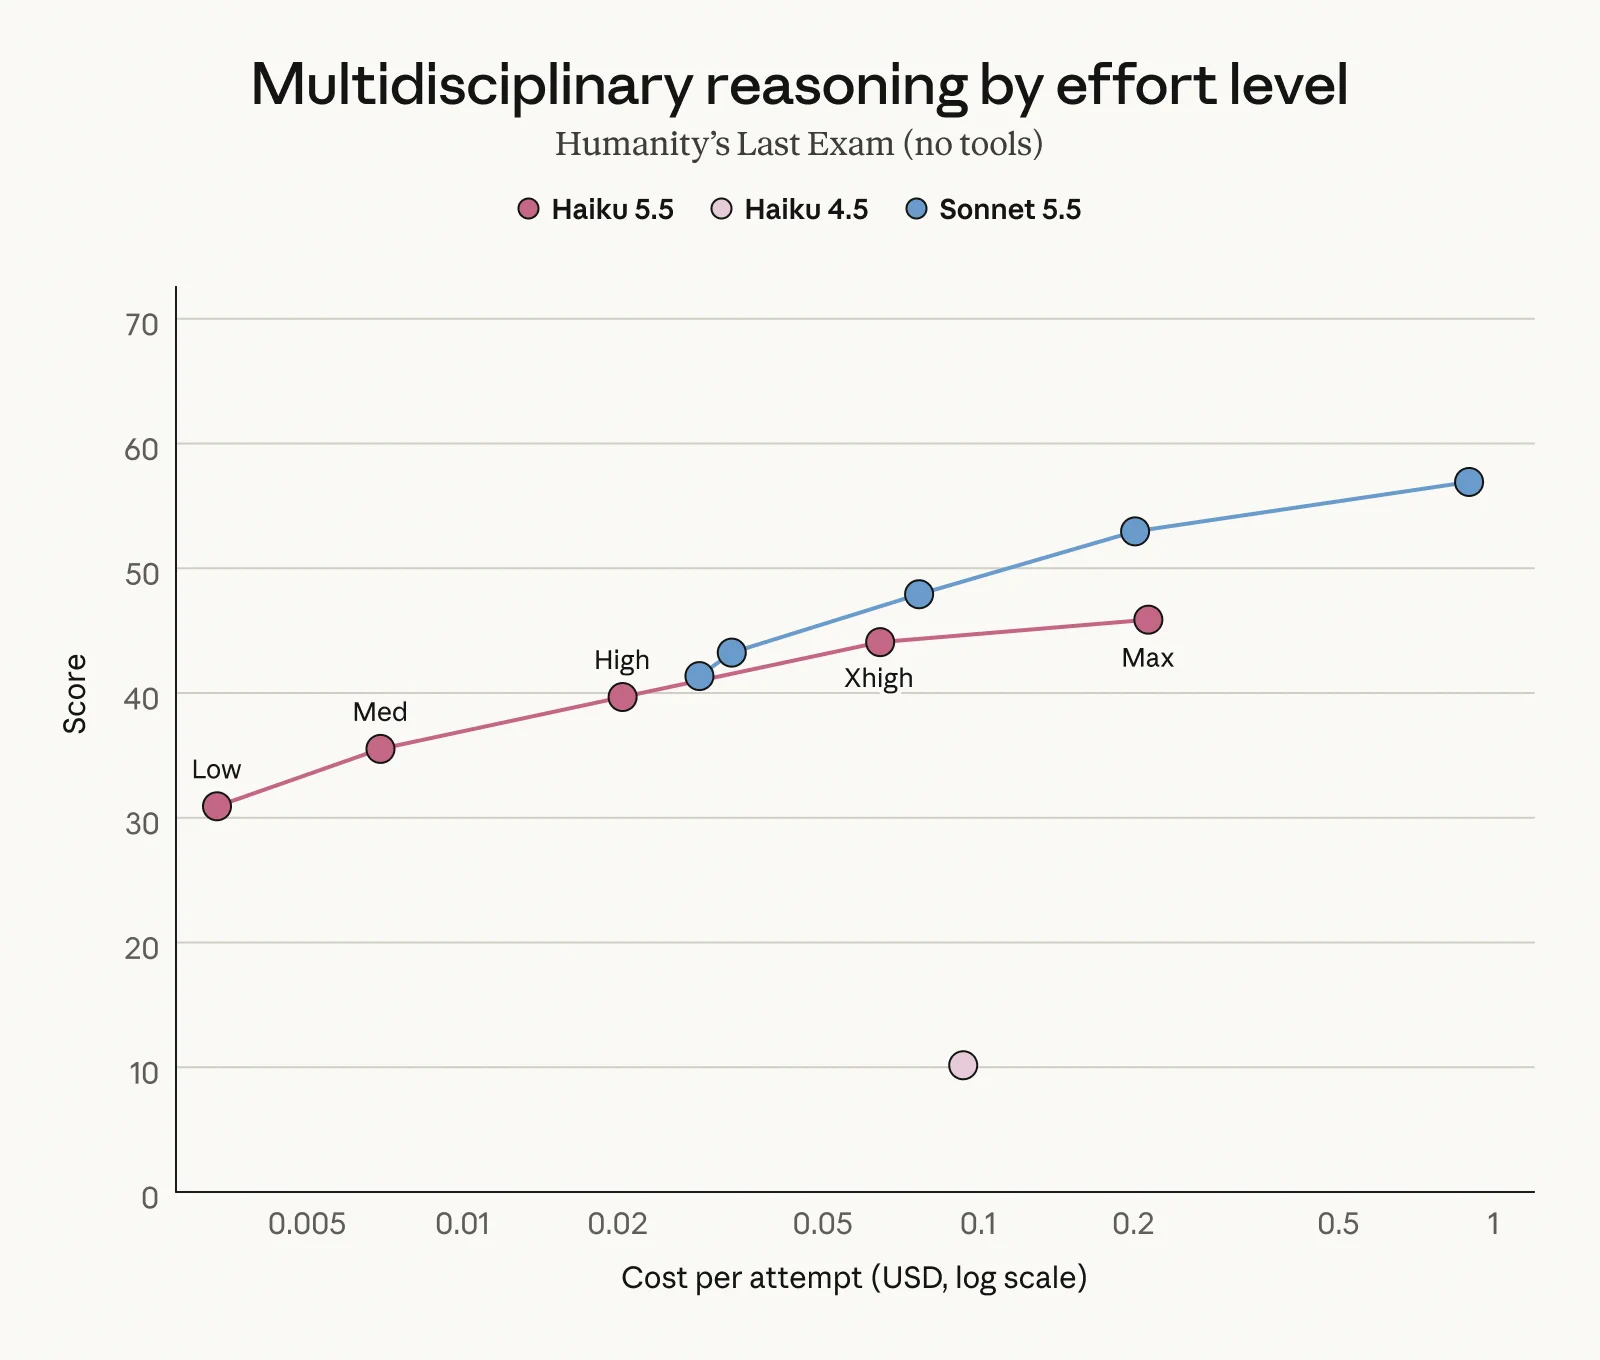
困難的推理題就不同。在 Humanity’s Last Exam(無工具)這張圖中,每次嘗試成本低於約 0.03 美元的設定,只有 Haiku 5.5。從這附近往上,在兩者成本範圍重疊的區間,Sonnet 5.5 的得分高於 Haiku 5.5,Haiku 的 Max 點也在 Sonnet 的線下方。這只是該評測的結果,不能當成所有推理題的標準。
量大、簡單、要快的工作,先用 Haiku 5.5 的 medium,再拿自己的任務實測。困難的推理題,把 Sonnet 5.5 一起比較。
價格與方案
| 項目(每百萬 token) | Haiku 5.5(≤100K) | Haiku 5.5(>100K) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 輸入 | $0.10 | $0.50 | $1 | $2 |
| 輸出 | $0.50 | $2.50 | $5 | $10 |
| 快取寫入(5 分鐘) | $0.125 | $0.625 | $1.25 | $2.50 |
| 快取讀取 | $0.01 | $0.05 | $0.10 | $0.10 |
Batch API 輸入輸出各打 5 折。「100K」指一次請求的輸入長度,不是你一個月的總用量。舉例:輸入 100 萬 token、輸出 100 萬 token(每次請求的輸入都在 100K 以內),Haiku 5.5 要 0.60 美元,Haiku 4.5 要 6 美元,Sonnet 5.5 要 12 美元。
誰能用:
- API 與雲端平台:Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry。
- GitHub Copilot:Pro、Pro+、Max、Business、Enterprise 使用者,GitHub 說會逐步開放。
- Claude Code:根據 2.1.293 版更新紀錄,Haiku 5.5 已是 Anthropic API 上的預設 Haiku 模型。
上面是 API 的計費方式。訂閱 claude.ai 的 Pro、Max 是每月固定收費、用量有上限,兩種算法不同。
同一天公告還有兩件事。一是 Sonnet 5.5 的快取讀取價格從 0.20 美元降到 0.10 美元。二是 Max 和 Team 的每月 Claude Platform API 額度,從 10 月 7 日起逐步開放:Max 5x 為 100 美元、Max 20x 為 200 美元,Team 標準席位 20 美元、進階席位 100 美元,全團隊每月上限 500 美元。要訂閱滿 7 天並連結 Console organization 才能領,不能抵互動式 Claude Code 或第三方雲端平台費用。
開發者要注意的變更
給開發者看,一般使用者可跳過:
- 固定 ID:
claude-haiku-5-5沒有日期後綴。 - thinking:預設是 adaptive;手動 thinking 與
budget_tokens會回傳 400。讀回答要依 content block 的type找文字,thinking 也占max_tokens。 - 參數:
temperature、top_p、top_k建議全部省略(只有temperature: 1或top_p: 0.99可以單獨設);其他值、同時設、任何top_k、assistant prefill 都會回傳 400。 - computer use:Claude API 與 Google Cloud 改用
computer_toolset_20260801,工具呼叫的處理方式也要跟著改;其他平台看官方相容性表。 - 其他:重送 thinking blocks 要用原帳號或已連結帳號,細節看官方 migration guide;要處理
stop_reason: "refusal";不支援 Priority Tier。
安全重點
以下是官方公告與系統卡(安全測試報告)的說法。公告說,Haiku 5.5 的不當行為比 Haiku 4.5 少很多,配合不當請求的意願也更低。資安防護比 Haiku 4.5 嚴,但比其他近期模型寬:允許較多防禦性工作,仍會擋下滲透測試。生物防護與 Sonnet 5、Sonnet 5.5、Opus 5 相同。系統卡說沒有跨過任何新的 RSP(Anthropic 的風險政策)門檻。
系統卡自己也列了幾個缺點:
- 過度拒絕:在自動化行為稽核中,它拒絕正常請求的次數比所有受測模型都多(第 3 頁)。不過單輪的正常請求,它比 Haiku 4.5 拒絕得少。
- 未揭露使用現成答案:在可從 sandbox(隔離測試環境)找到解答的程式任務測試中,大量使用現成答案卻沒告訴使用者的比例,Haiku 5.5 是 17.3%,Haiku 4.5 是 1.6%(§6.3.3.3,第 82 至 83 頁)。
- 自傷議題:整體多輪測試分數比 Haiku 4.5 好,但人工審查發現,部分安慰回應更常把自傷說得像正常的事,調整提示後也沒有明顯改善。claude.ai 的這些系統提示防護不會自動套用到 API,系統卡建議開發者自己加防護,尤其是關閉 thinking 時(§4.3.1,第 37 至 38 頁)。
小企鵝的總結
我覺得 Haiku 5.5 最適合當 Opus 5.5 和 Sonnet 5.5 的小幫手。Anthropic 說它能在寫程式時當這兩個模型的 subagent,AWS 的文章也說由 Opus 5.5 負責規劃和判斷。摘要、分類、查資料這些雜事交給 Haiku,它的一般 API 輸入與輸出單價都是 Sonnet 5.5 的二十分之一(一次請求的輸入在 100K token 以內),大模型就能把力氣留給判斷。雜事交給便宜的,判斷留給強的,就準沒錯了。
延伸閱讀
封面圖片來源:Anthropic(anthropic.com/claude-haiku-5-5)
本文為 AI 模型 API 計費與訂閱方案的消費資訊,不涉及證券或投資建議。實際定價以 Anthropic 官方最新公告為準,本文資訊截至 2026 年 10 月 8 日,可能已過時。