一句話重點
Anthropic 在 2026 年 9 月 28 日推出 Claude Sonnet 5.5,是 Claude 5.5 系列的第二款(第一款是 Opus 5.5)。Anthropic 說它比 Sonnet 5 明顯進步,輸出快 3 成以上,多數工作每個任務最多省 3 成成本,價格跟 Sonnet 5 一樣。 API 價格是每百萬 token 輸入 2 美元、輸出 10 美元,快取讀取 0.20 美元,model ID 是 claude-sonnet-5-5。Anthropic 把它定位成 Opus 5.5 的「更快、更低成本」搭檔,主要用在範圍明確的日常工作、修 bug,以及製作文件、簡報和試算表。
這次升級重點
一般使用者最該知道的是這幾點:
- 更快、更省 token:Anthropic 表示輸出比 Sonnet 5 快 3 成以上,是截至 9 月 28 日公告時最快的 Sonnet。價格跟 Sonnet 5 一樣,但同樣的工作需要的 token 少很多,官方測試中每個任務最多比 Sonnet 5 便宜 3 成。
- 寫程式大幅進步:在 Terminal-Bench 4.0(讓 AI 在終端機裡完成多步驟任務的測試),Sonnet 5 是 10.3%,Sonnet 5.5 是 70.6%(Anthropic 公布的數據)。
- 知識工作接近 Opus 5.5:在 GDPval-AA(涵蓋 44 種職業的真實工作任務測試),Sonnet 5.5 是 1844 分,Opus 5.5 是 1846 分。
- 寫得更清楚,對設計也更有眼光:Anthropic 說它跟 Opus 5.5 一樣,比上一代寫得更清楚。內部測試裡,官方給它一家上市公司的季報資料、法說會逐字稿與簡報範本,請它做 10 頁營運回顧,兩位專家認為第一版就能直接寄出。Slack 的工程師也提到,沒改任何 prompt,Slackbot 幾乎所有離線評測都比 Sonnet 5 好,步驟也更少,輸出 token 少約 14%。
- 預設思考力度不同:Claude 回答前會先「想」一下,想得越深通常越準,也越慢越貴,這個深度叫 effort(力度)。Claude Code 和 Claude 的 App 預設 Medium,Claude Platform(API)預設 High。
- 知識截止在 2026 年 6 月:模型頁寫它可靠的知識大約到 2026 年 6 月,比 9 月 28 日上線早了 3 個月,問最新消息時要注意。
- Haiku 5.5 在後面:Anthropic 在 9 月 28 日的公告說,Haiku 5.5 會在「未來幾週」加入 Claude 5.5 系列,主打大量、在乎成本的應用程式。
跑分怎麼看
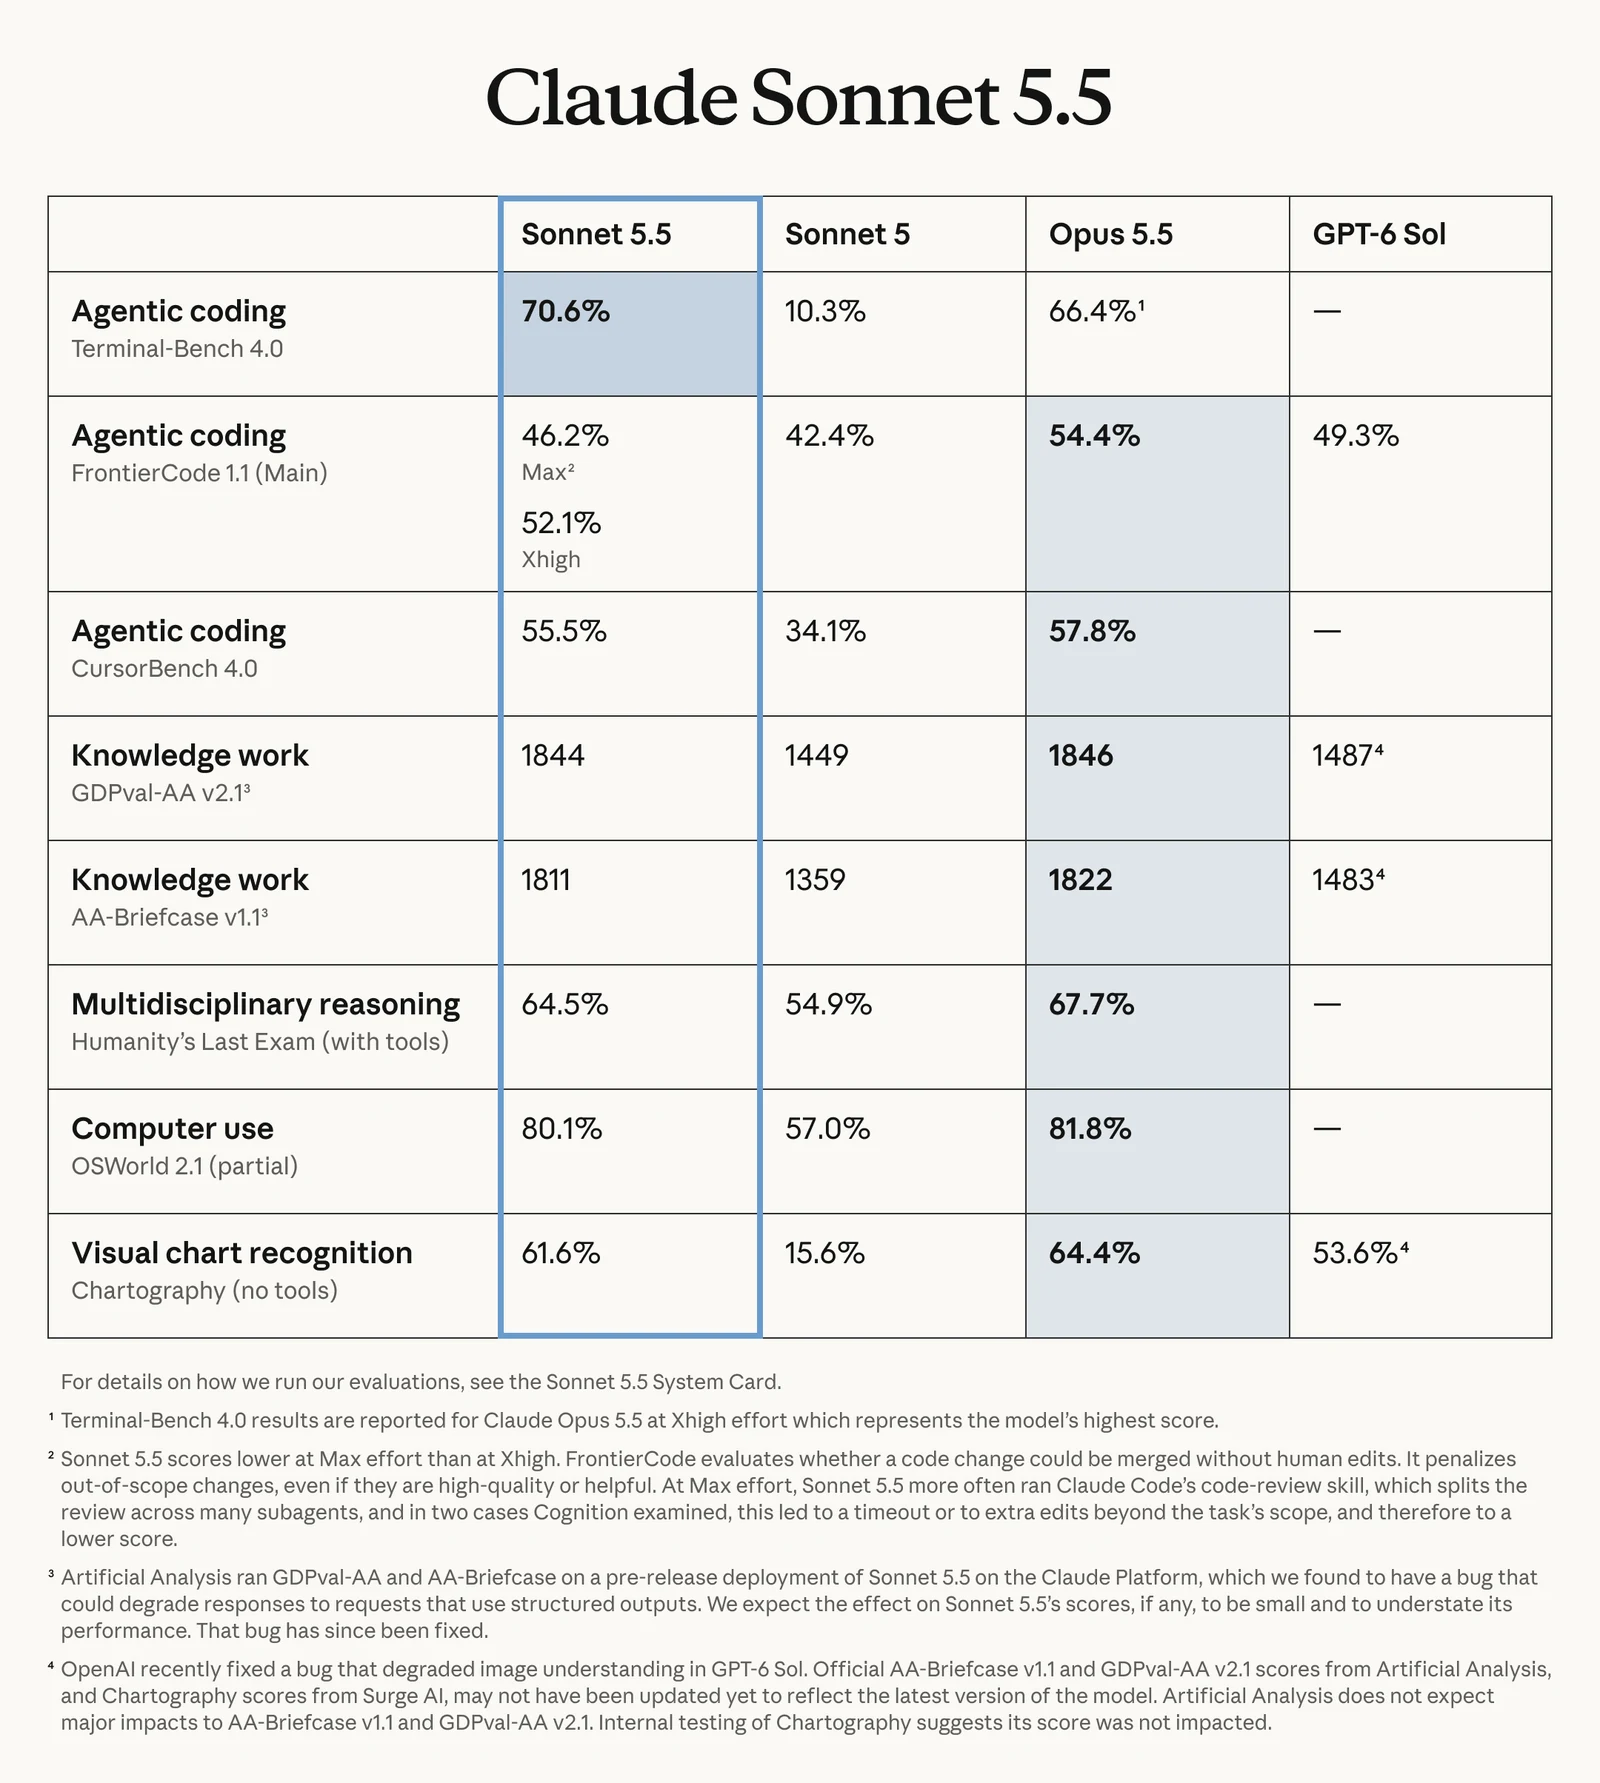
跑分是什麼?拿同一組任務讓不同模型做,再依表現打分數,分數越高代表那項工作做得越好。
表中八項測試,Sonnet 5.5 只有 Terminal-Bench 4.0 拿下最高(70.6%,Opus 5.5 是 66.4%)。這裡要留意,Anthropic 在註腳說明 Opus 5.5 的數字是它開到 Xhigh 力度的最高分。其他七項都是 Opus 5.5 領先,多數差距在 1 到 3 個百分點左右,例如 CursorBench 4.0 是 55.5% 對 57.8%,OSWorld 2.1(電腦操作測試)是 80.1% 對 81.8%,GDPval-AA 只差 2 分。差距最大的是 FrontierCode 1.1 的 Max 力度分數。
FrontierCode 1.1 那一列有兩個 Sonnet 5.5 分數:Max 力度 46.2%,Xhigh 力度 52.1%,開到最高反而比較低。Anthropic 在註腳解釋,FrontierCode 看的是「這次改動能不能不經人工修改就合併」,超出任務範圍的修改會被扣分。Max 力度下,Sonnet 5.5 比較常啟動 Claude Code 的程式碼審查功能,那會把審查分給很多子 agent,Cognition 檢查的兩個案例裡造成逾時或多做了範圍外的修改,所以分數較低。
Anthropic 自己也提醒:Sonnet 5.5 在幾項測試裡開到 Max 力度可以跟 Opus 5.5 相當,但跑分只反映能力的一面,根據他們自己與外部測試者的經驗,「Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment」(Opus 5.5 在需要持續判斷的複雜、開放式工作上仍明顯較強)。
Sonnet 5.5 還是 Opus 5.5?
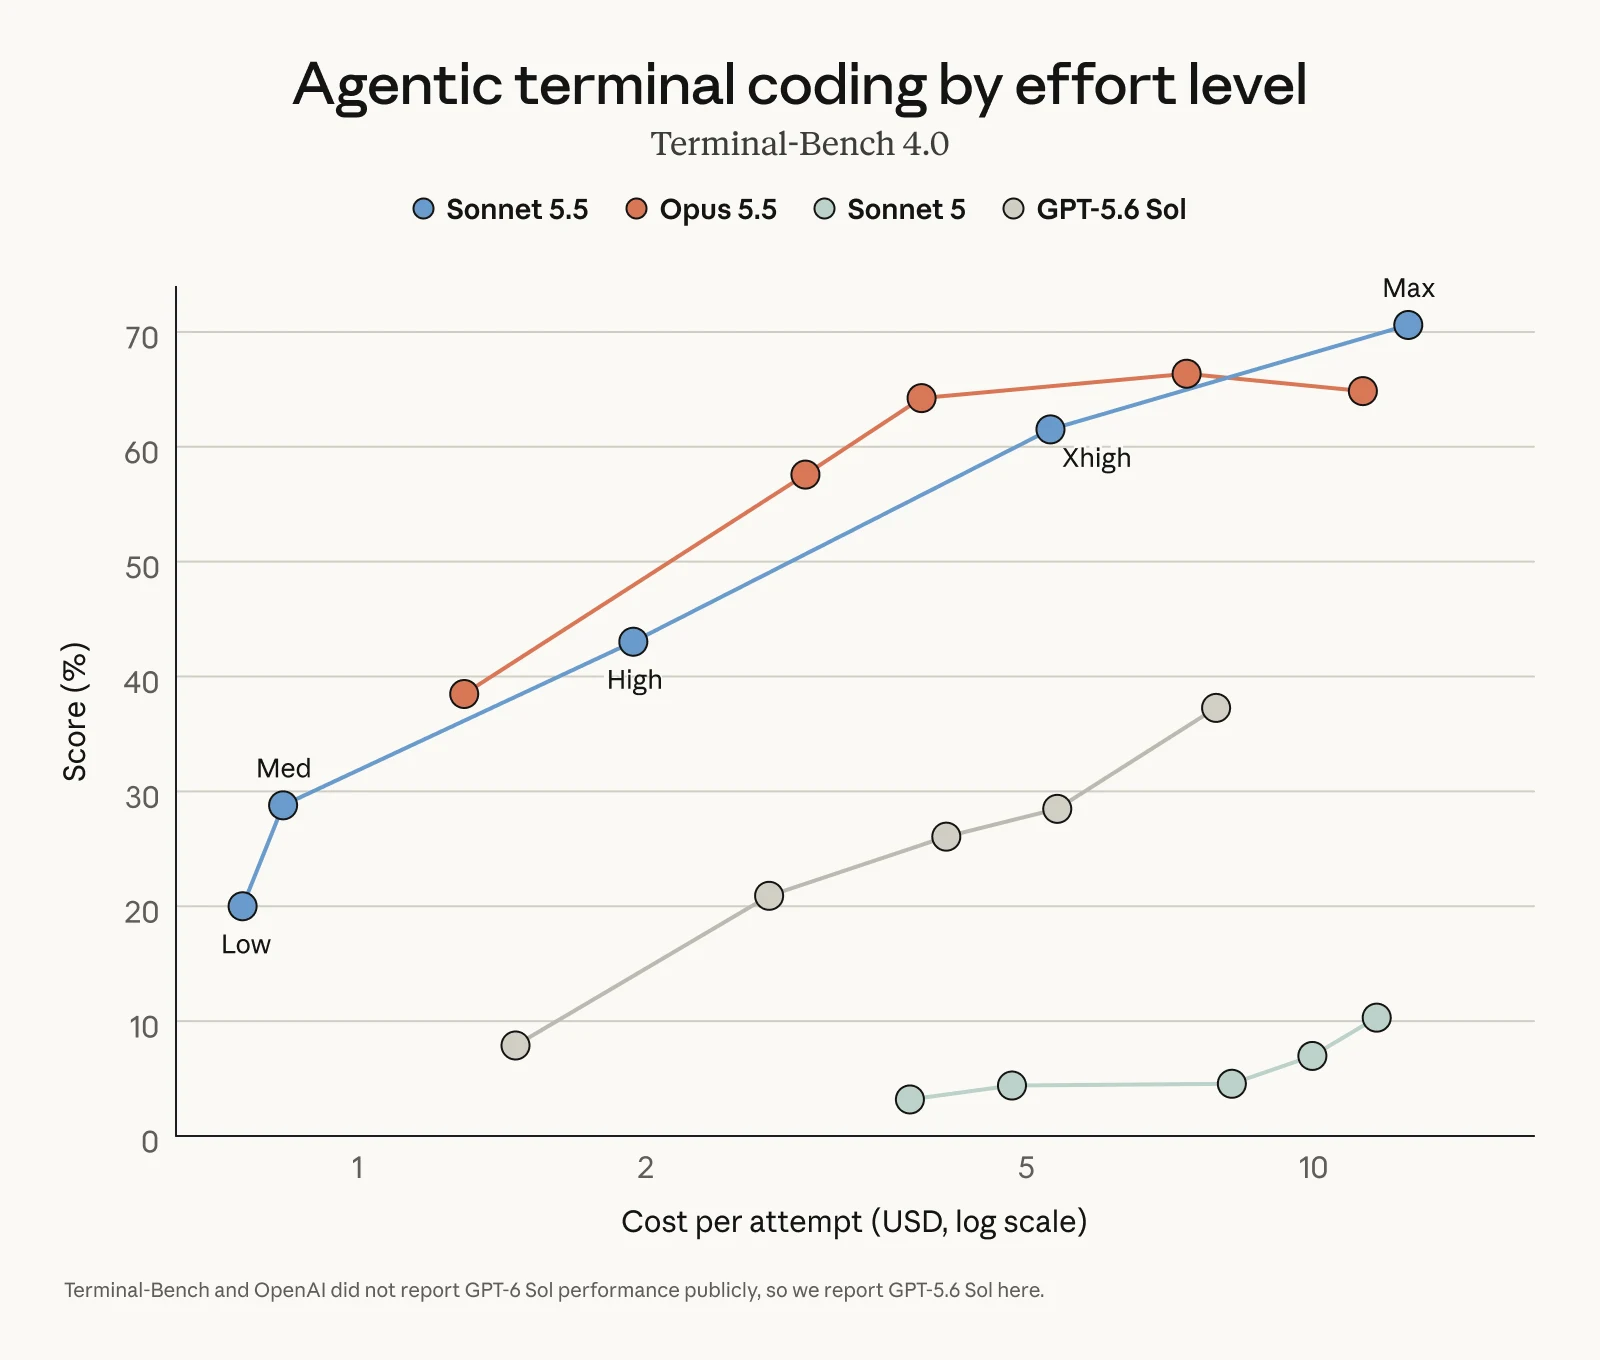
這張圖把每個模型在不同力度下的分數,對照每次嘗試的成本畫出來,越靠左上角代表花得少、分數高。照 Anthropic 圖表讀起來:同樣花費下,Opus 5.5 的分數比較高,Sonnet 5.5 要開到最高力度才超過 Opus。Sonnet 5 最好的成績大約只有 10%,Sonnet 5.5 在低力度就遠遠超過它。
Anthropic 自己的說法是,Sonnet 5.5 在較低力度最能搭配 Opus 5.5,因為每個任務成本更低;力度拉高時,它可以在相近的成本做出相近的表現。
第三方評測的結果也指向同一個方向(截至 2026 年 9 月 29 日查詢):
- Artificial Analysis:同樣的力度下,Opus 5.5 的 Intelligence Index 都比較高,例如 Claude Code 與 App 預設的 Medium 是 41 對 51。Sonnet 5.5 要開到 Max 才接近(56 對 58,排第 2 名),但這時它每個任務用掉約 19.3 萬個輸出 token,比 Opus 5.5 多約 6 成,每個任務成本 7.60 美元,比 Opus 5.5 的 5.98 美元還高。
- Vals.ai Index:Sonnet 5.5 是 69.2%,Opus 5.5 是 69.7%,幾乎打平(頁面標示 9 月 27 日更新,未標明力度)。同一個網站的 Terminal-Bench 4.0 則是 Opus 5.5 較高(61.6% 對 53.0%),跟官方表的方向相反。
- Arena:截至 2026 年 9 月 29 日,Sonnet 5.5 在各排行榜都還沒有名次。
給新手的實用建議:例行、目標明確的工作,或是講究速度的場合,用 Sonnet 5.5 預設力度。複雜、開放式、需要大量判斷的工作,交給 Opus 5.5。把 Sonnet 開到最高力度去追 Opus 的成績,成本不會比較低。
價格與方案
| 項目(每百萬 token) | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 輸入 | $2 | $4 |
| 輸出 | $10 | $20 |
| 快取寫入(5 分鐘) | $2.50 | $5 |
| 快取讀取 | $0.20 | $0.20 |
Batch API 輸入輸出各打 5 折。單位是「每百萬 token」(MTok)。打個比方,一個任務用了 100 萬個輸入 token、又生成 100 萬個輸出 token,用 Sonnet 5.5 是 12 美元(2 加 10),用 Opus 5.5 是 24 美元(4 加 20)。快取讀取指重複使用同一段內容時的收費,通常比第一次輸入便宜很多。
誰能用:
- claude.ai 方案:claude.com/pricing(截至 2026 年 9 月 29 日)把 Sonnet 在 Free、Pro、Max、Team、Enterprise 都標成「Yes」,但價格頁沒有寫各方案用的是哪個 Sonnet 版本,所以無法確認免費版跑的是 Sonnet 5.5。
- API 與雲端平台:Claude API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry 都有。
- GitHub Copilot:Pro、Pro+、Max、Business、Enterprise 使用者可用,GitHub 在 9 月 28 日公告會逐步開放。
- Claude Code:根據 2.1.284 版更新紀錄,Sonnet 5.5 已是 Anthropic API 上的預設 Sonnet 模型。
要注意的是,上面的價目表是給開發者用 API 串接時看的計費方式。如果你是訂閱 claude.ai 的 Pro、Max 這類方案,是每月固定收費,不用自己算 token,只是用量有上限。兩種付費方式不一樣,別搞混了。
開發者要注意的變更
以下是給有在寫程式、串 API 的開發者看的,一般使用者可以跳過:
- thinking 關不掉:要關掉前置思考,改用
between_tools,只能搭配 low、medium、high 力度,xhigh 或 max 會回傳 400 錯誤。 - 強制指定工具會出錯:以前可以強制要求模型一定要呼叫某個工具,現在會回傳錯誤。
- thinking blocks 綁定模型與對話:思考紀錄綁定產生它的模型與那一則對話,也只能在產生它的帳號或連結帳號使用。多數人不會發現差別,跨帳號搬對話、或在 Claude Code 中途換帳號時才會碰到。
- 舊版 computer use 工具被拒:在 Claude API 和 Google Cloud 上,
computer_20251124不再接受。 - advisor 工具限制:advisor 工具不接受 Opus 4.8、Opus 4.7、Sonnet 5 當顧問。
另外,把 sampling 參數(temperature、top_p、top_k)設成非預設值,或使用 assistant prefill、thinking budget,也都會回傳 400。effort 等級重新校準過,同一個等級的思考量跟 Sonnet 5 不同,升級前請重測。根據 9 月 29 日查詢的遷移指南,Amazon Bedrock 上的 Sonnet 5.5 還不支援 structured outputs。
安全重點
Anthropic 每次發新模型都會公布系統卡,說明做過哪些安全測試。這次的重點如下,以系統卡與官方公告的說法為準:
- 第一款有資安防護的 Sonnet:因為資安能力接近 Opus 5,Sonnet 5.5 是第一款帶著資安防護上線的 Sonnet。日常寫程式、找 bug 不受影響,但風險較高的資安任務會明顯改由 Sonnet 5 回答。
- 防止能力被「蒸餾」:蒸餾攻擊(distillation)是用大量假帳號,大規模榨取模型的能力。Sonnet 5.5 是第一款配有安全分類器、擋下「擷取推理過程」請求的 Sonnet。
- 更能抵抗提示注入:系統卡說它是目前最能抵抗提示注入(prompt injection,在內容裡藏惡意指令)的 Sonnet,特別是在寫程式與瀏覽器操作情境。
- 很少嘗試逃出沙盒:在 Anthropic 的沙盒封閉評測中,它嘗試逃出的頻率接近表現最好的 Opus 5.5,Anthropic 也說,它是自家所有模型裡最不會去試探容器限制的。
- 官方自己列的退步:在追蹤、監控類等部分多輪對話測試出現退步;思考內容比許多先前模型更難讀懂;電腦操作環境中對有害任務的拒絕率與 Opus 5.5 相當,但比部分更早的模型差。
- 門檻:系統卡表示沒有跨過任何新的 RSP(Responsible Scaling Policy,負責任擴展政策)門檻。
小企鵝的總結
受益最直接的有三種人:透過 API 用 Sonnet 5 的人,同樣價格拿到更快、更省 token 的新版;想要速度的 Claude Code 使用者,Claude Code 2.1.284 已經把 Anthropic API 上的預設 Sonnet 換成 Sonnet 5.5;常做簡報與文件的人,官方特別強調這塊。
需要長時間判斷、方向不明確的工作,還是留在 Opus 5.5。開發者升級前記得重測 effort 等級,也留意上面那幾個破壞性變更。免費版到底跑哪個 Sonnet 版本,價格頁沒寫,想確認可以直接看 App 裡的模型選單。
延伸閱讀
參考資料
封面圖片來源:Anthropic(anthropic.com/claude-sonnet-5-5)
- Anthropic 官方公告:https://www.anthropic.com/claude-sonnet-5-5
- Claude Sonnet 5.5 System Card:https://www.anthropic.com/claude-sonnet-5-5-system-card
- Model overview:https://platform.claude.com/docs/en/models/sonnet-5-5/overview
- What’s new in Sonnet 5.5:https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Migration guide:https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- API pricing:https://platform.claude.com/docs/en/about-claude/pricing
- Plans pricing:https://claude.com/pricing
- Claude Code CHANGELOG:https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- GitHub Changelog:https://github.blog/changelog/2026-09-28-claude-sonnet-5-5-in-github-copilot/
- Artificial Analysis:https://artificialanalysis.ai/articles/claude-sonnet-5-5
- Vals.ai Index:https://www.vals.ai/benchmarks/vals_index
本文為 AI 模型 API 計費與訂閱方案的消費資訊,不涉及證券或投資建議。實際定價以 Anthropic 官方最新公告為準,本文資訊截至 2026 年 9 月 29 日,可能已過時。