一句話重點
Anthropic 在 2026 年 9 月 22 日推出 Claude Opus 5.5。官方稱它在多數工作上達到 Fable 5.1 的水準,預設設定下比 Opus 5 省約 4 成成本。 Claude 分成 Fable、Opus、Sonnet、Haiku 幾個系列(截至 2026 年 9 月),能力和價格由高到低,Opus 屬於中高階。上線近兩週,它在多個第三方排行榜排名第一;第一週不少評論者給了好評,9 月底之後也出現不少抱怨。
這次升級重點
- 接近 Fable 5.1:Fable 5.1 是更貴的高階模型,官方稱 Opus 5.5 在多數工作上達到它的水準。
- 更便宜、更快:API 輸入、輸出單價比 Opus 5 低 2 成,生成速度快 3 成以上(官方數字)。
- 預設思考力度調低:Claude 回答前會先「想」,想得越深通常越準,也越慢越貴。Opus 5.5 預設用中等力度,需要可以自己調高。
- Claude Code 預設換人:Pro 或 Team Standard 方案的 Claude Code,預設模型從 Sonnet 換成 Opus。
跑分怎麼看
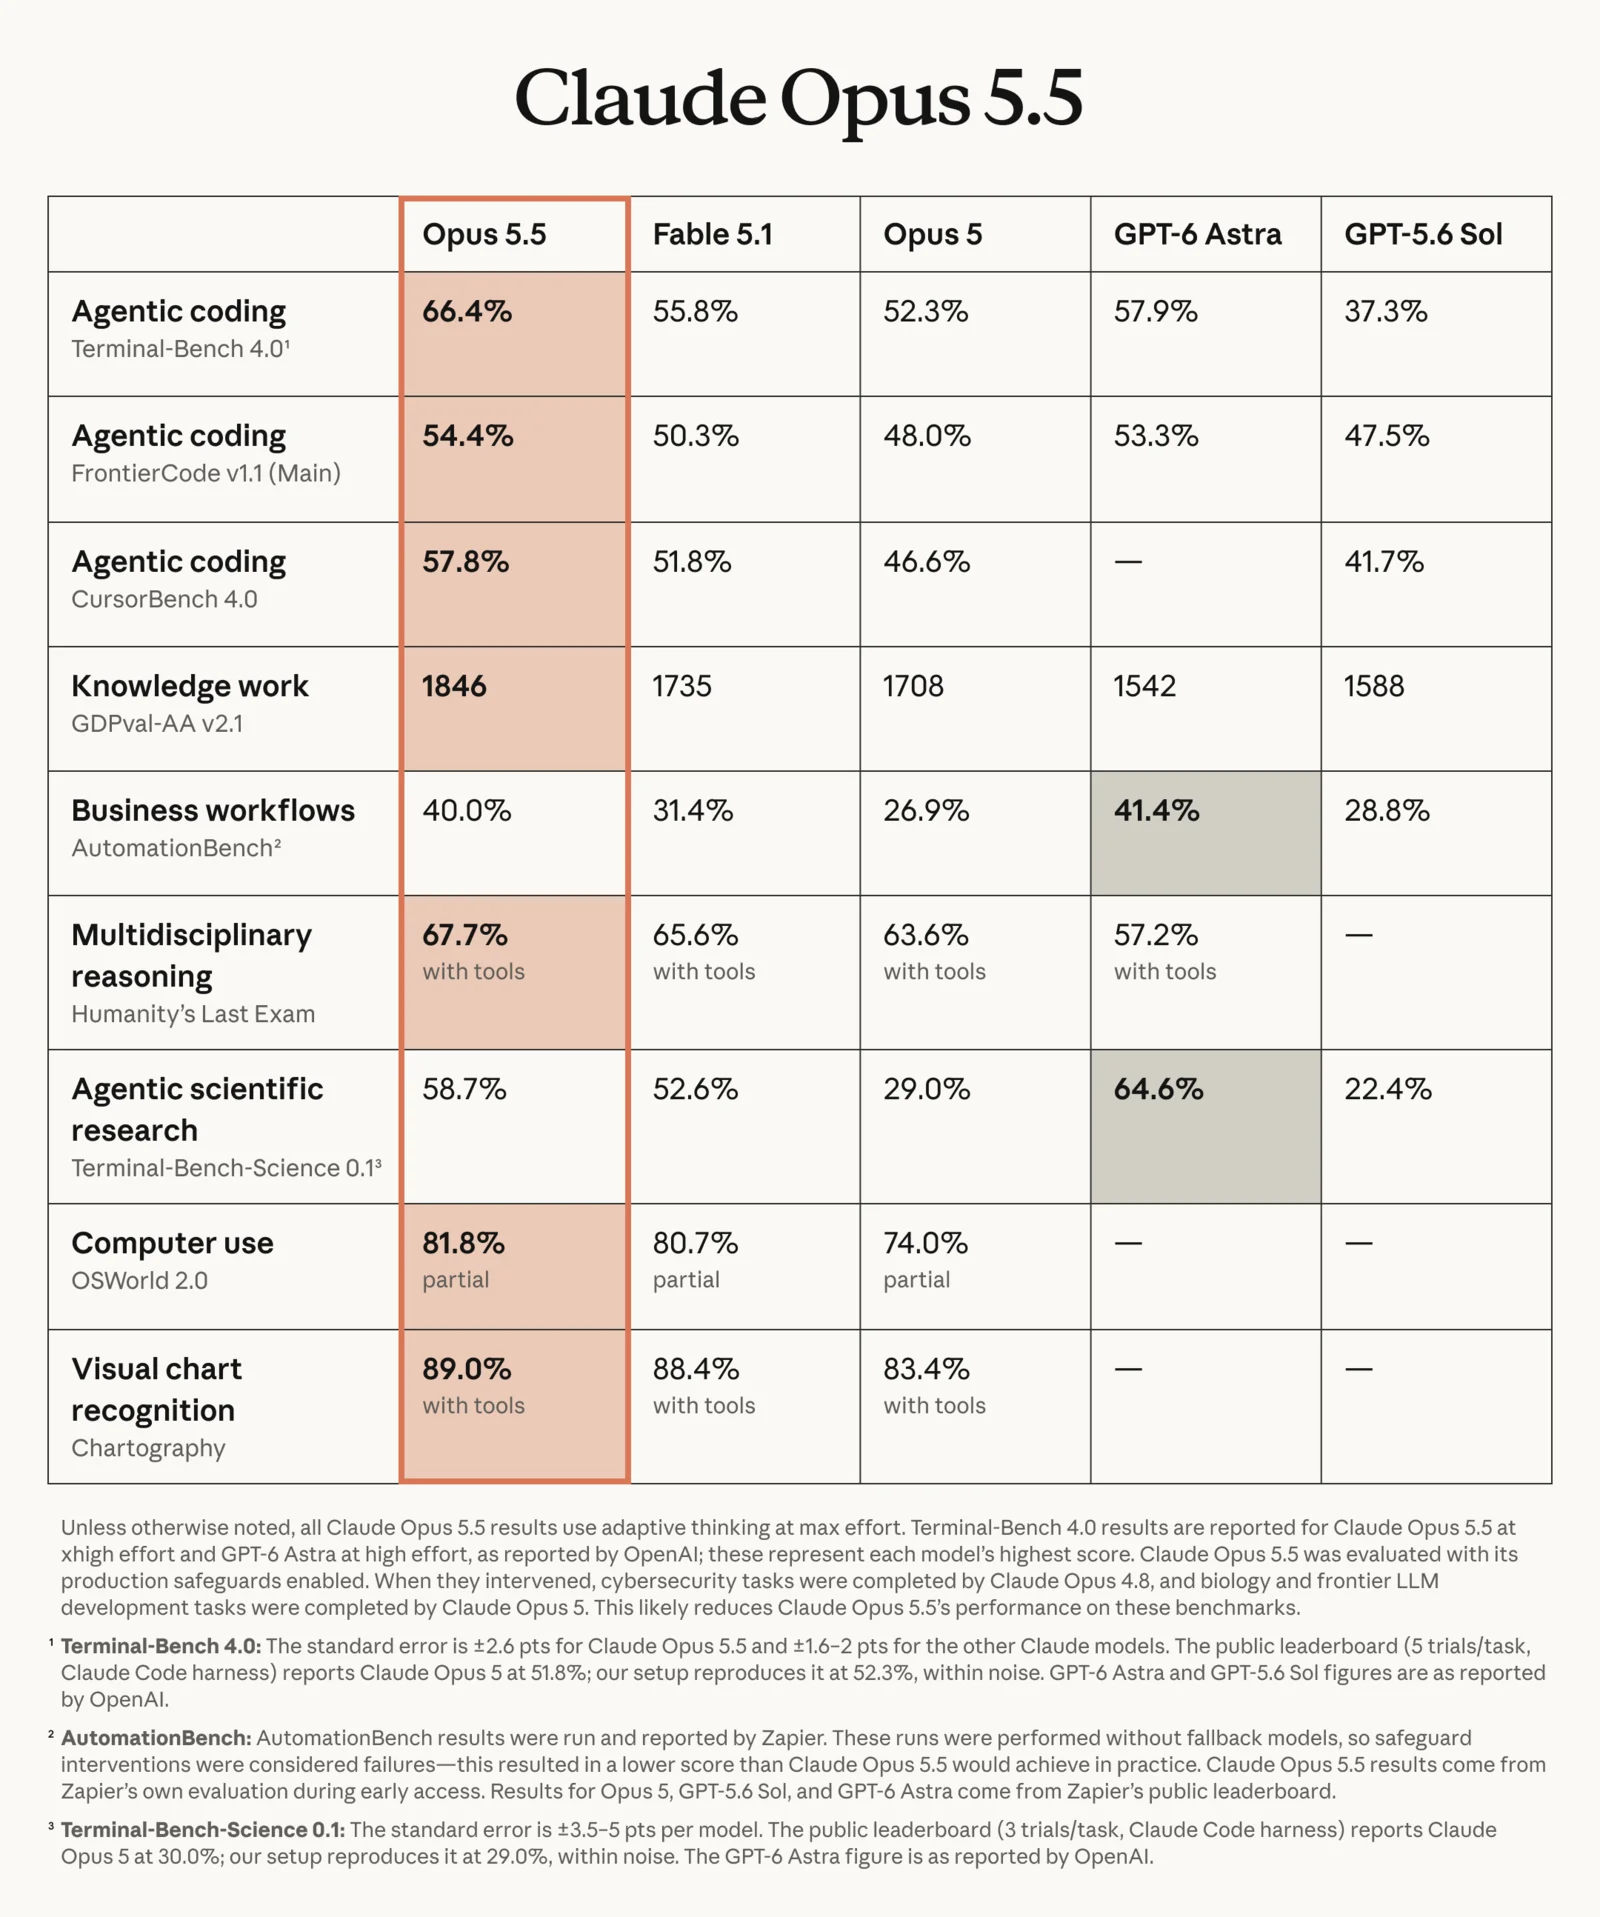
跑分就是讓不同模型做同一組任務,再依表現打分數。官方公布的九項測試裡,Opus 5.5 有七項拿下表中最高分(其中三項 GPT-6 Astra 沒有分數),另外兩項輸給 GPT-6 Astra。Anthropic 也提醒,到了這個能力等級,跑分差距已經不太能反映實際使用的感覺。
上線近兩週:第三方排名
| 榜單 | 測什麼 | Opus 5.5 名次與分數 | 資料日期 |
|---|---|---|---|
| Artificial Analysis | 綜合智力指數 | 第 1 名,58 分(max,允許預設備援模型) | 2026-10-04 查閱 |
| LMArena 文字對戰 | 真人盲測投票 | 第 4 名(high 設定),1504 分,與第 2~3 名差距在誤差內 | 2026-10-02 |
| LMArena WebDev | 做網頁的真人盲測 | 第 1 名(max 設定),1815 分 | 2026-10-01 |
| Vals Index | 金融、法律等實務任務 | 第 3 名(max,含備援模型完成的任務),66.97% | 2026-10-02 |
各榜單的思考力度(effort)與備援規則不同,分數要連同設定一起看。
社群評價:好評在哪、抱怨在哪
Zvi 在 LessWrong(9 月 26 日)形容,這是他見過「反應最一致正面」的一批評價(來源)。
好評:
- 好溝通:比 Opus 5 自然。Simon Willison 說它「看起來解決了大家對 Opus 溝通風格最大的抱怨」(來源)。
- 寫程式與 agent 任務表現好:有數位開發者把它當成預設模型。
- 速度快。
抱怨:
- 安全分類器誤擋:敏感工作會被轉給舊模型(見下方「安全重點」),有人覺得打斷工作。
- 最高 effort 很吃 token,有時做不完:Simon Willison 用 max 設定測試時,曾兩次沒有回傳結果。
- 「變笨了」的疑慮:9 月底開始出現,目前查到的測試還不足以確認退步。
以上是個別心得,不能換算成整體好評比例。
價格與方案
| 項目 | Opus 5.5 | Opus 5 |
|---|---|---|
| 輸入 | $4/MTok | $5/MTok |
| 輸出 | $20/MTok | $25/MTok |
| 快取讀取 | $0.20/MTok | $0.50/MTok |
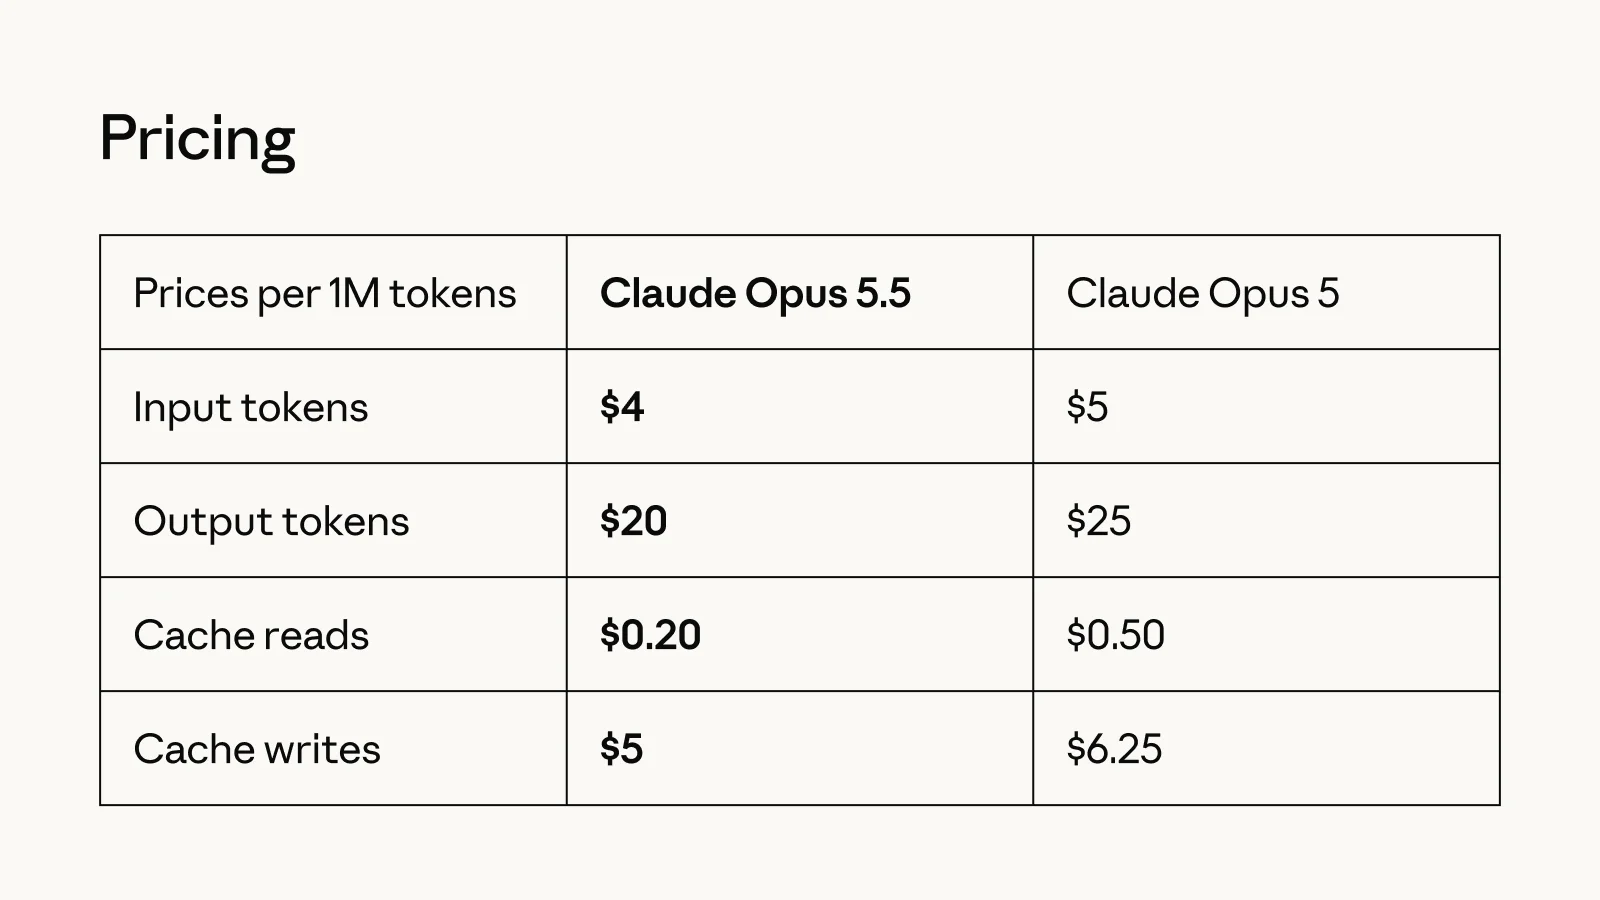
MTok 是「每百萬 token」。100 萬輸入加 100 萬輸出 token,Opus 5.5 約 24 美元,Opus 5 約 30 美元。快取讀取是重複讀同一段內容的收費,跑長任務的人最有感。
這張表是 API 的計費方式。Pro、Max 這類訂閱是月費制,不用算 token,但用量有上限;免費方案還不能用 Opus 5.5(截至 2026 年 9 月)。開發者可以透過 Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundry 取得。
開發者要注意的變更
一般使用者可以跳過。串 API 的開發者換模型前,留意這四點:
- thinking 不能關,硬關會回傳錯誤。
- 強制指定某個工具會出錯,改用自動判斷就正常。
- 讀不懂 Fable 留下的 thinking blocks。
- Claude API 和 Google Cloud 上的舊版 computer use 工具已停用。
安全重點
Anthropic 每次發新模型都會公布「系統卡」,說明做過哪些安全測試。這次的重點:
- 對齊測試表現好:官方行為測試中,多數不對齊指標優於近期 Claude 模型。
- 提示注入退步:貼進對話的文字若藏著惡意指令,Opus 5.5 比以前更容易照做;加上官方防護後,基本上不會照做。
- 敏感問題自動轉模型:在 Claude App 問到資安或生物相關的敏感問題,會轉給 Opus 4.8 或 Opus 5 回答,畫面會提示。
小企鵝的總結
老實說,小企鵝玩了一天 Opus 5.5,有點感動到。它總算回到 Opus 4.6 那種好溝通的感覺,不像 Opus 5 講話跟機器人一樣。拿來指揮其他 agent(orchestration)也特別順,終於可以讓它自己 spawn subagents(派出子 agent)分頭做事,這點 Opus 4.6 就比較笨拙。token 也用得比較省。最有感的是,回覆裡那些奇怪的「—」終於不見了 😭
接下來小企鵝會繼續測試 Opus 5.5,有新心得再發上來。
第一週的評價和第三方排名,大致印證了小企鵝第一天的感覺。要留意的是安全轉模型,以及最高 effort 的成本與穩定性;預算有限的人,可以拿自己的任務比比看輸入、輸出單價只要一半的 Sonnet 5.5。
受益最直接的是透過 API 付 Opus 5 價格的人,以及用 Pro 或 Team Standard 方案 Claude Code 的人。開發者記得重測 effort 等級,不要直接沿用舊設定。
本文為 AI 模型 API 計費與訂閱方案的消費資訊,不涉及證券或投資建議。實際定價以 Anthropic 官方最新公告為準,本文資訊截至 2026 年 10 月 4 日,可能已過時。
延伸閱讀
- Claude Fable 5.1 完整介紹
- Claude Sonnet 5.5 完整介紹
- Claude Opus vs Sonnet:什麼時候該用哪個
- Claude Code 完整教學
- Claude Opus 4.8 介紹
封面圖片來源:Anthropic(anthropic.com/claude-opus-5-5)