ひとことで要点
Anthropicは2026年9月22日、Claude Opus 5.5を発表しました。公式によると、多くの仕事でFable 5.1と同等の水準に達し、デフォルト設定ではOpus 5より約4割コストを抑えられます。Claudeは2026年9月時点で、Fable、Opus、Sonnet、Haikuの各シリーズに分かれており、能力と価格は高い順に並びます。Opusは中上位クラスです。リリースから約2週間で複数の第三者ランキングで1位に入り、最初の週は少なからぬレビュアーが高く評価しましたが、9月末以降には不満の声も多く出ています。
今回のアップグレードの要点
- Fable 5.1に近い性能:Fable 5.1はより高価な上位モデルです。公式によると、Opus 5.5は多くの仕事でその水準に達しています。
- より安く、より速く:APIの入力・出力単価はOpus 5より2割安く、生成速度は3割以上速くなっています(公式発表の数値)。
- デフォルトの思考強度を引き下げ:Claudeは回答前に「考え」ます。深く考えるほど通常は正確になりますが、時間も費用もかかります。Opus 5.5のデフォルトは中程度で、必要に応じて自分で上げられます。
- Claude Codeのデフォルトモデルが変更:ProまたはTeam StandardプランのClaude Codeでは、デフォルトモデルがSonnetからOpusに変わりました。
ベンチマークの見方
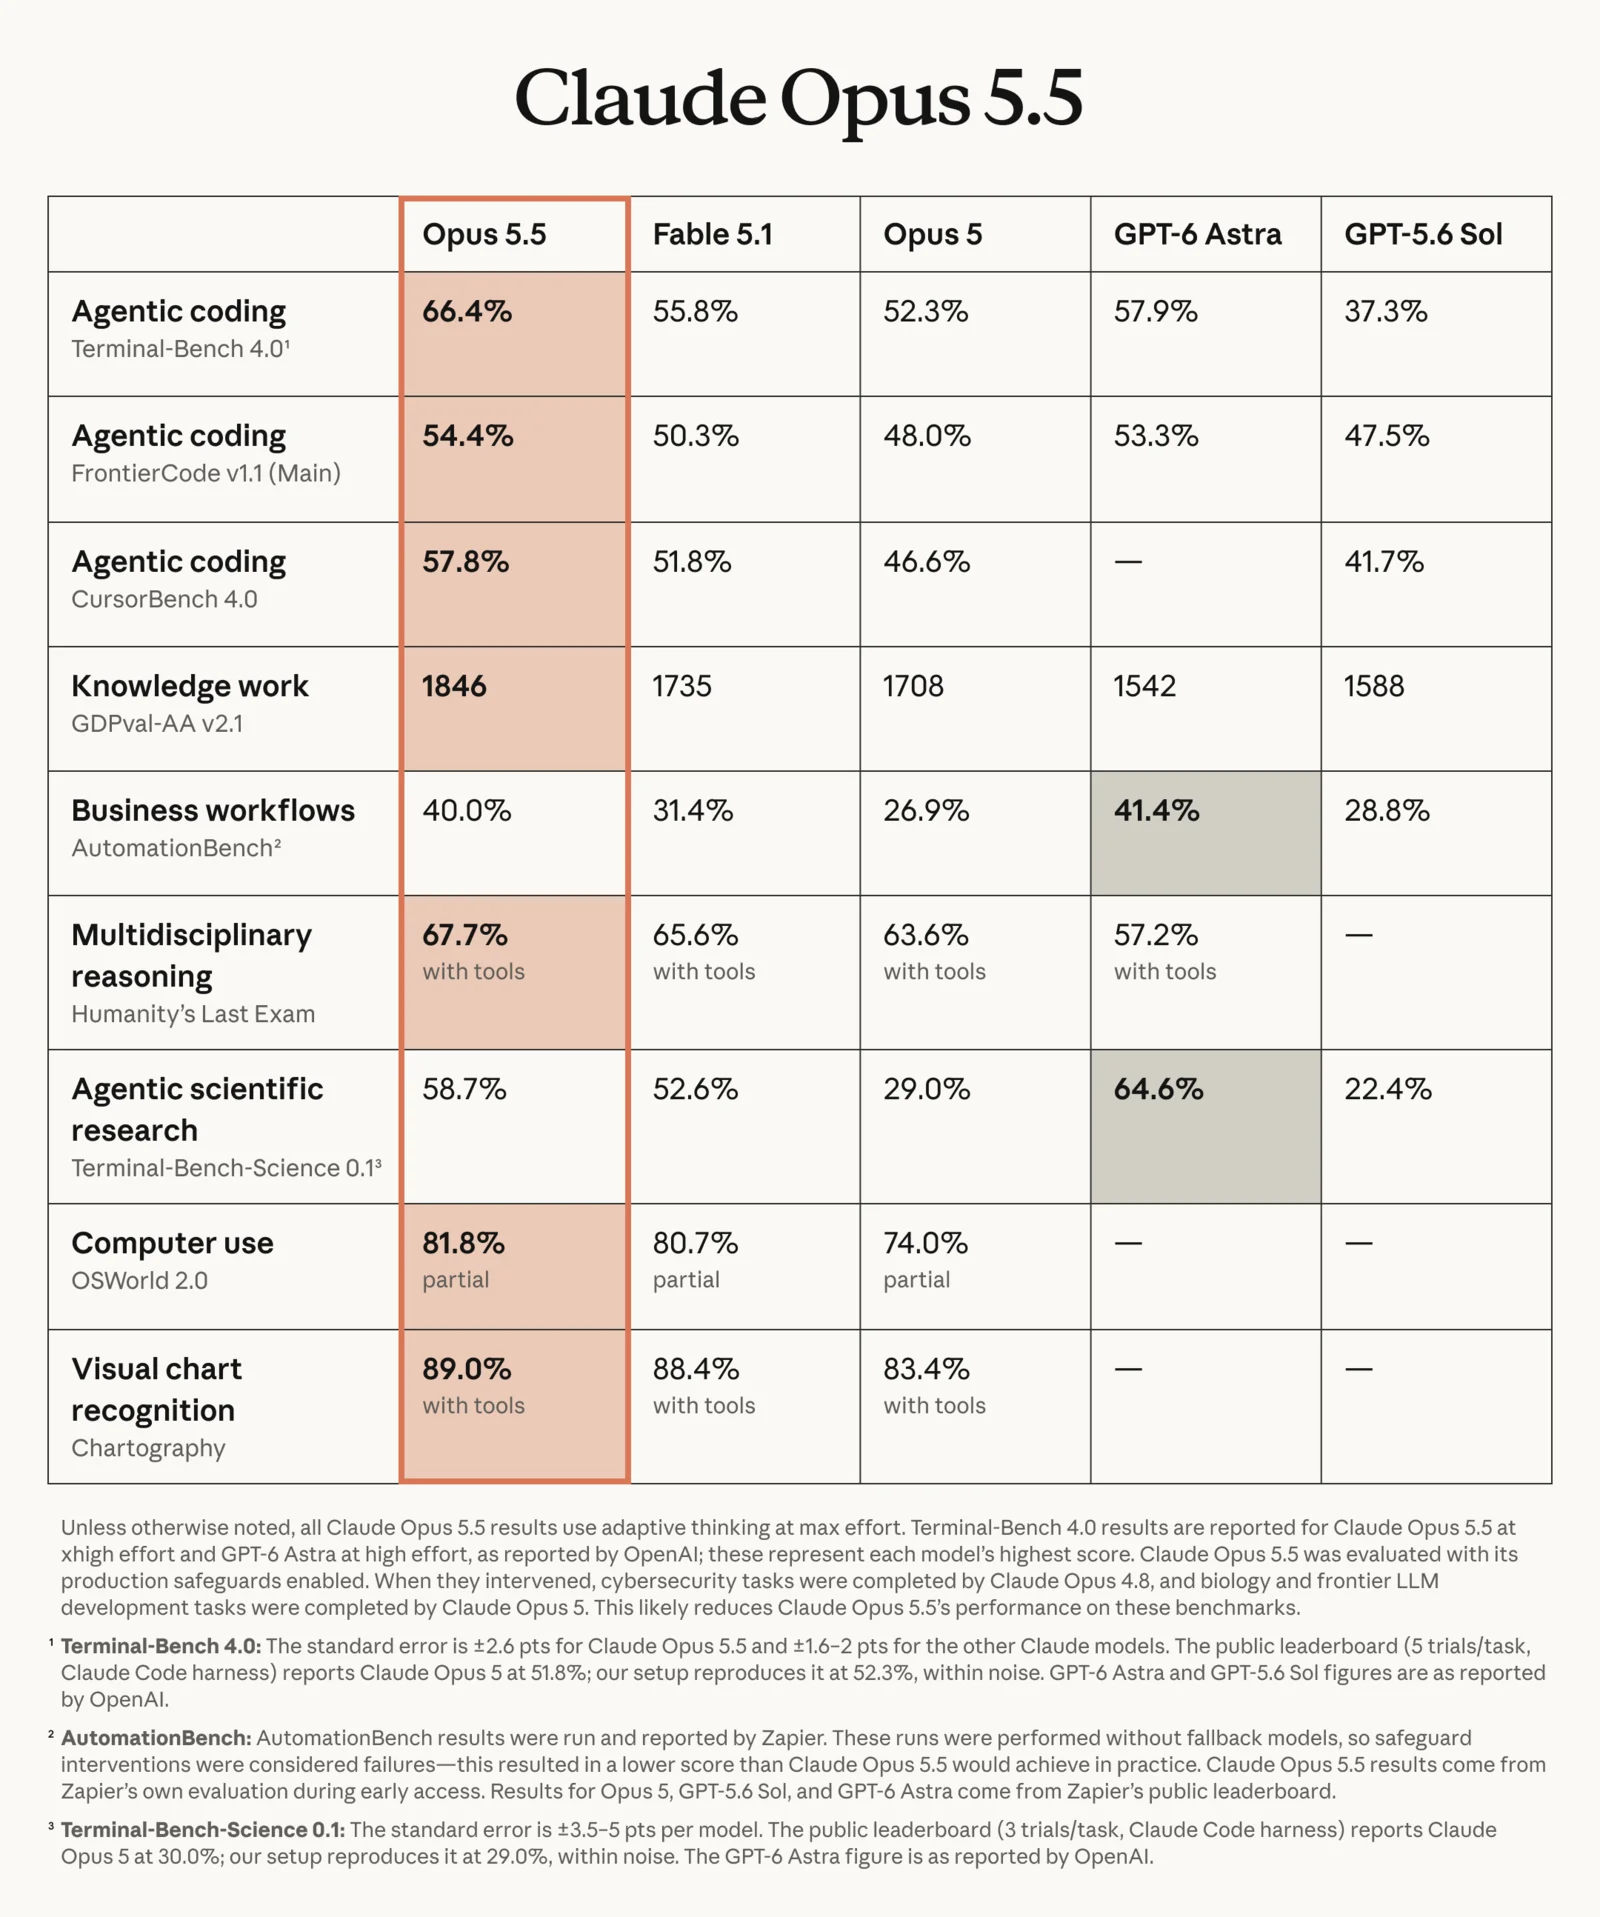
ベンチマークとは、同じ一連の課題を複数のモデルにさせ、結果を点数で比べるものです。公式が発表した9項目のテストでは、Opus 5.5が表中の最高スコアを7項目で獲得しています(そのうち3項目はGPT-6 Astraのスコアがありません)。残り2項目ではGPT-6 Astraに負けています。Anthropicは、この能力水準ではベンチマークの差が実際の使用感をあまり表さないとも注意しています。
リリースから約2週間:第三者ランキング
| ランキング | 測定内容 | Opus 5.5の順位とスコア | データ日付 |
|---|---|---|---|
| Artificial Analysis | 総合知能指数 | 1位、58点(max、デフォルトのフォールバックモデルを許可) | 2026-10-04確認 |
| LMArenaテキスト対戦 | 人によるブラインドテスト投票 | 4位(high設定)、1504点。2位、3位との差は誤差の範囲内 | 2026-10-02 |
| LMArena WebDev | Webページ作成の人によるブラインドテスト | 1位(max設定)、1815点 | 2026-10-01 |
| Vals Index | 金融、法律などの実務タスク | 3位(max、フォールバックモデルで完了したタスクを含む)、66.97% | 2026-10-02 |
各ランキングで思考の強度(effort)やフォールバックのルールが異なるため、設定とあわせてスコアを見る必要があります。
コミュニティの評価:好評な点と不満な点
ZviはLessWrong(9月26日)で、これまで見た中で「最も一貫して好意的」な反応の一群だと表現しています(出典)。
好評な点:
- 話しやすい:Opus 5より自然です。Simon Willisonは「Opusに対する会話スタイルの最大の不満を解消したようです」と書いています(出典)。
- コーディングやagentタスクの性能が良い:複数の開発者がデフォルトモデルとして使っています。
- 速度が速い。
不満な点:
- 安全分類器による誤ブロック:センシティブな作業は旧モデルに切り替わり(下の「安全性の要点」を参照)、作業を中断されると感じる人もいます。
- 最高のeffort設定ではtoken消費が多く、完了できないこともある:Simon Willisonはmax設定で試した際、2回、結果が返らなかったと述べています。
- 「性能が落とされた」との懸念:9月末から出始めましたが、今回確認したテストでは低下を裏付けるには不十分です。
ここでまとめたのは個別の感想であり、全体の好評率を示すものではありません。
料金とプラン
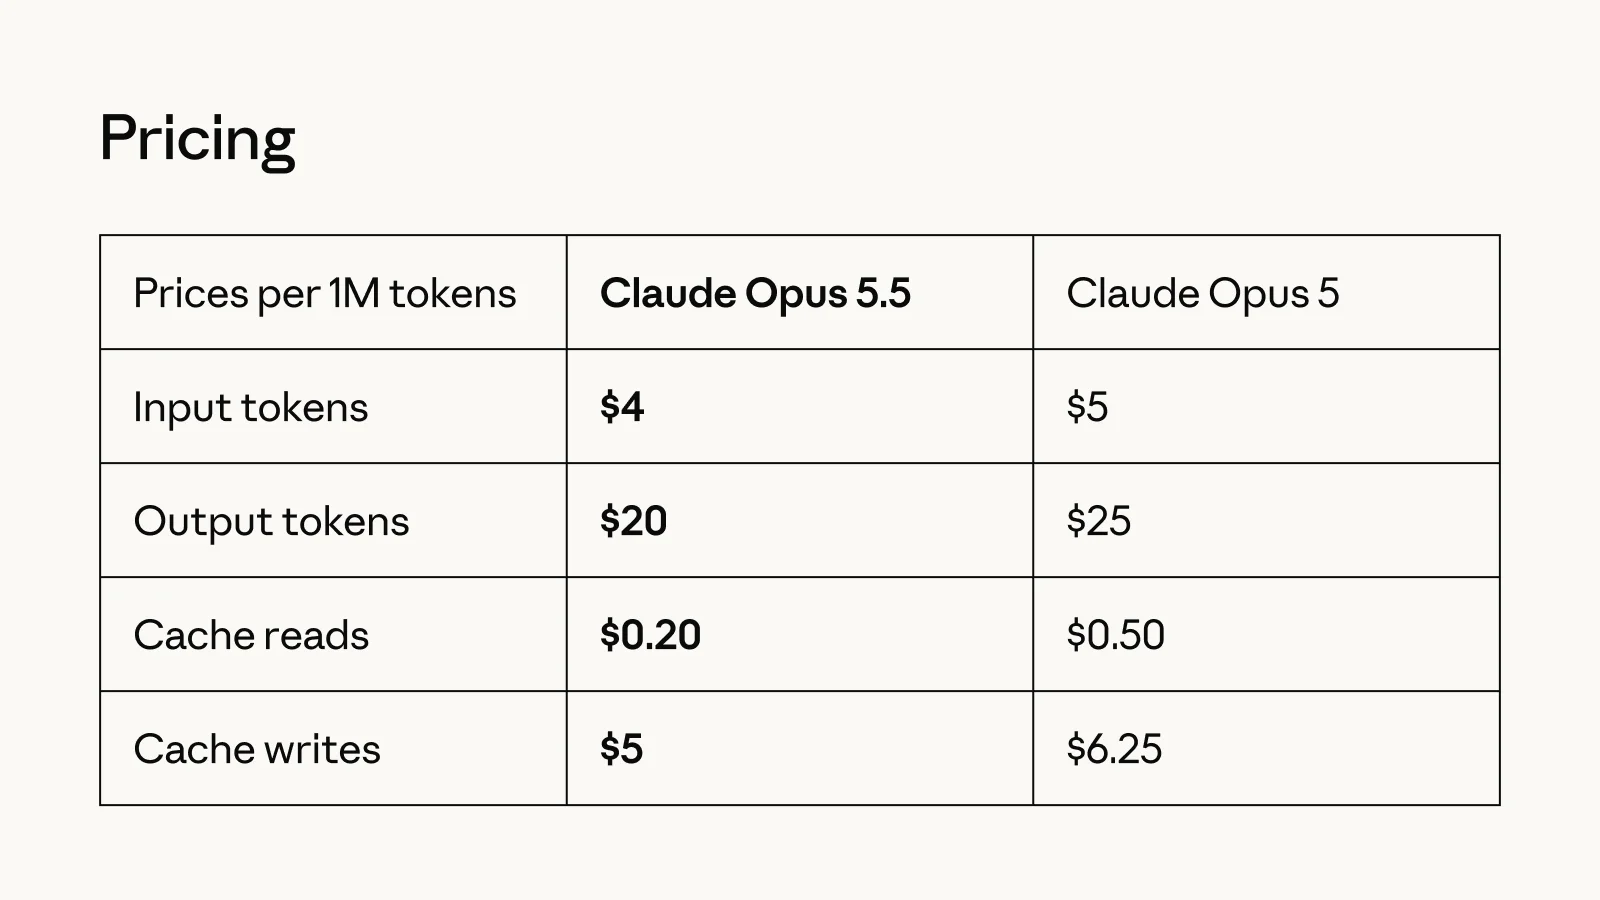
| 項目 | Opus 5.5 | Opus 5 |
|---|---|---|
| 入力 | $4/MTok | $5/MTok |
| 出力 | $20/MTok | $25/MTok |
| キャッシュ読み取り | $0.20/MTok | $0.50/MTok |
MTokは「100万tokenあたり」です。入力100万tokenと出力100万tokenを使うと、Opus 5.5は約24ドル、Opus 5は約30ドルです。キャッシュ読み取りは同じ内容を繰り返し読むときの料金で、長いタスクを実行する人ほど違いを感じるでしょう。
この表はAPIの料金です。Pro、Maxなどのサブスクリプションは月額制で、token数を計算する必要はありませんが、利用量には上限があります。無料プランではOpus 5.5を使えません(2026年9月時点)。開発者はClaude API、Amazon Bedrock、Google Cloud、Microsoft Foundryから利用できます。
開発者が注意すべき変更
開発者向けの情報です。一般ユーザーは読み飛ばして構いません。APIでモデルを切り替える前に、次の4点を確認してください。
- thinkingを無効にできず、無理に無効化するとエラーが返ります。
- ツールを強制指定するとエラーになります。自動判断を使えば正常に動きます。
- Fableが残したthinking blocksを読み取れません。
- Claude APIとGoogle Cloudの旧版computer useツールは停止されています。
安全性の要点
Anthropicは新しいモデルを発表するたびに「システムカード」を公開し、実施した安全性テストを説明しています。今回の要点は次のとおりです。
- アラインメントテストで良好な結果:公式の行動テストでは、多くの非アラインメント指標が最近のClaudeモデルより良い結果でした。
- プロンプトインジェクションは悪化:会話に貼り付けた文章に悪意のある指示が隠されていると、Opus 5.5は以前より指示に従いやすくなっています。公式の防御策を加えれば、基本的には従いません。
- センシティブな質問では自動的にモデルを切り替え:Claudeアプリでサイバーセキュリティや生物学に関するセンシティブな質問をすると、Opus 4.8またはOpus 5に切り替えて回答します。画面には切り替えが表示されます。
小企鵝のまとめ
正直に言うと、小企鵝はOpus 5.5を1日使って、ちょっと感動しました。ようやくOpus 4.6のような話しやすさに戻った感じです。Opus 5のように、ロボットと話している感じではありません。ほかのagentに指示するオーケストレーションも特にスムーズで、ついに自分でsubagents(子agent)をspawnして、分担して作業させられるようになりました。この点はOpus 4.6のほうが少し不器用でした。tokenの消費も少なめです。いちばん実感したのは、返信にあったあの変な「—」が、ついに消えたことです 😭
これからも小企鵝はOpus 5.5を試し続け、新しい感想があればまた書きます。
最初の週の評価と第三者ランキングは、小企鵝が初日に感じたことをおおむね裏付けています。安全上のモデル切り替えと、最高のeffort設定でのコストや安定性には注意が必要です。予算に限りがある人は、自分のタスクで入力・出力単価が半額のSonnet 5.5と比べてみるとよいでしょう。
直接メリットを受けるのは、APIでOpus 5の料金を払っている人と、ProまたはTeam StandardプランでClaude Codeを使っている人です。開発者はeffortレベルをもう一度テストし、古い設定をそのまま使わないようにしましょう。
この記事は、AIモデルのAPI料金とサブスクリプションプランに関する消費者向け情報であり、証券や投資の助言ではありません。実際の料金はAnthropic公式の最新発表を確認してください。この記事の情報は2026年10月4日時点のもので、古くなっている可能性があります。
関連記事
- Claude Fable 5.1の完全ガイド
- Claude Sonnet 5.5の完全ガイド
- Claude OpusとSonnet:いつどちらを使うべきか
- Claude Code完全ガイド
- Claude Opus 4.8の紹介
カバー画像出典:Anthropic(anthropic.com/claude-opus-5-5)