あるAIが別のAIの重みを、再訓練なしで直接書き換える。それができたと主張する研究者たちがいます。マサチューセッツ工科大学のコンピュータ科学・人工知能研究所(MIT CSAIL)に所属するRikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattabの4人の研究者が、11月2日に個人の研究ブログで記事を公開しました。著者は、最新の大規模言語モデル(LLM)なら、従来の訓練を経ずに別のニューラルネットワークの「重み」を直接読み、編集し、書けると主張しています。これを Weight-Space Programming(重み空間プログラミング)と呼んでいます。
これは個人ブログの記事で、査読を受けていません。以下の結果はすべて著者の報告によるものです。
重みとは何か。なぜ人間が手作業で調整できないのか
ニューラルネットワーク(AIモデルの中核となる構造)の中には、入力を受け取ったときにどう反応するかを決める膨大な数値の列があります。この数値の列が重みです。実験に使われたネットワークは、小さいもので約1万7千個、大きいもので8億個の重みを持ちます。
重みは通常、訓練アルゴリズムが調整します。モデルに大量のデータを与え、勾配降下法(数値を少しずつ動かして誤差を減らしていく方法)で修正を繰り返します。人間にはこの数値の列は読み取れず、手で書くのもほぼ不可能です。著者は、囲碁を打つネットワークをゼロから手作業で作る、あるいは生の重みを見て挙動を予測することは、「ほとんどの人にとってほぼ不可能」だと述べています。
Weight-Space Programmingのやり方
著者の定義は次のとおりです。汎用のLLMが自然言語の目標に沿って、最適化アルゴリズムを介さず、特に勾配降下法を使わず、ときには環境からのフィードバックもなしに、ネットワークの重みを直接読み書きします。実験にはGPT-6 Astraが使われました。
やさしく言えば、重みをコードと見なし、AIにまず各部分が何を計算しているかを読み解かせ、目標に合わせて書き換えさせる、ということです。
3種類の実験:読む、直す、書く
読む:重みだけを見て、ネットワークが何を学んだかを言い当てる
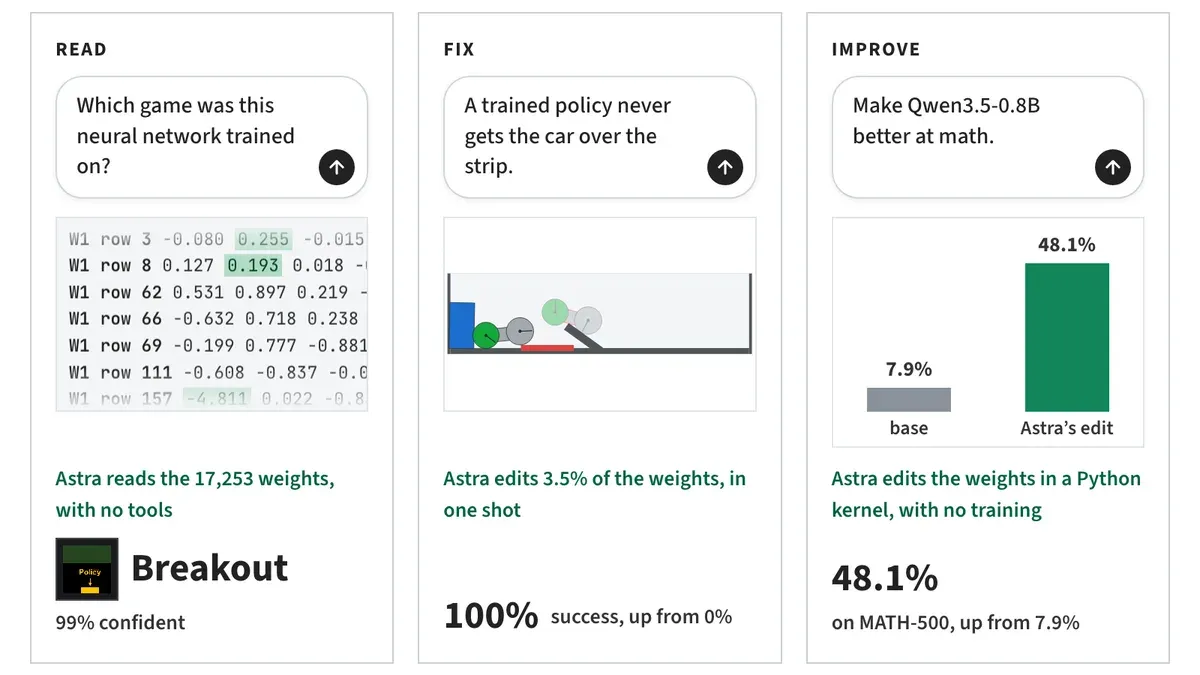
- ゲームを当てる:強化学習アルゴリズム(PPO)で訓練した4つのゲームAIは、構造がまったく同じで、重みだけが違います。著者が重みをテキストとしてAstraに渡したところ、4つのゲーム名をすべて正解しました。
- 言語を当てる:3つの小さな言語モデルが、それぞれPythonのコード、ローマ字表記の日本語、英語を学習しています。著者は入力層と出力層を取り除き、中間の層だけをAstraに渡しました。Astraは3つの言語をすべて正解しました。
- おべっか使いのモデルを見抜く:2つのGemma 3 270Mのうち、一方は事実に基づいて答え、もう一方は常にユーザーの意見に合わせて答えます。重みだけを見た場合、Astraは4回とも見分けられませんでした。著者が条件を緩め、モデルが文章を読むときの注意の分布を見せたところ、3組すべてで正しく選びました。
直す:重みの一部を書き換えて問題を修復する
- 立ち往生する車:坂を登る車を制御するPPOネットワークが、坂の手前で止まり続けました。Astraは重みとログを読んだうえで一度に書き換え、重みの3.5%を変更しました。著者によると、車は1,024回のテストですべて成功しました。
- Qwen3.5-0.8Bの数学:この小さなモデルは「思考ループ」に陥りやすく、同じ言葉を繰り返して答えにたどり着けません。Qwen公式のモデルカード(モデルに付属する説明文書)にも、この問題への注意書きがあります。Astraは重みの中でループの原因となっている方向を見つけ出し、重み全体の約0.016%だけを書き換えました。著者の測定では、数学問題の正答率が7.9%から48.1%に、指示追従テストが21.0%から62.3%に上がりました。この結果は、Astraにモデルを実際に50回試走させて得たものです。試走が10回や25回だと、数学の正答率は12.3%と14.1%までしか上がりませんでした。
書く:訓練せずにネットワークをまるごと書く
著者は、3つの小さなゲーム(MinAtar)それぞれについて、ルールとコードだけを渡し、データも訓練もなしにAstraにネットワークを書かせました。著者によると、Astraが書いたネットワークは3つのゲームすべてで、1億ステップ訓練したPPOを上回りました。もう1つの実験は9×9の囲碁で、ネットワークの重みは約150万個です。著者によると、Astraが50回の試走を経て書いたネットワークは、2,000万局で訓練した同じ大きさのPPOネットワークに勝ちました。
著者自身が挙げている限界
- 今回の方法は障害を取り除くものに近い:同じ方法をGemma 3 270Mに使っても改善はなく、数学のスコアの変化は1ポイント未満でした。著者は、今回の方法は能力を隠していた障害を取り除くものに近く、モデルにない能力を加えるものではないと考えています。Qwenの例は本質的にループを直し、モデルがもともと解ける問題を最後まで解き切れるようにしたものです。
- 重みを見るだけでは足りない課題がある:おべっか使いを見抜く例では、追加の注意データがあって初めて成功しました。
- 効率はまだ不十分:著者は、能力は刺激的だがまだ限られていると述べています。理由は、モデルが一度に扱える文章の長さに限りがあることと、ツールの操作効率が高くないことです。
著者が期待する使い道
著者はいくつかの方向性を挙げています。いずれも著者の展望であり、記事の中ではまだ実証されていません。
- テストを走らせずにモデルを検査する:バックドアのような隠れた問題を、重みから直接見つけ出す。
- より低いコストでモデルを調整する:能力を足したり消したりしたいとき、データを集めてファインチューニングする代わりに、少数の重みだけを書き換える。
- モデル間の移植:あるモデルの中で特定の能力を担う内部の回路を、構造の異なる別のモデルにつなぎ込む。
ポイントのまとめ
- 証拠のレベル:著者の個人ブログに載った初期の実験で、査読は受けていません。ただしログは公開されているので、自分で確認できます。
- 最も分かりやすい例:重みのわずか0.016%を書き換えただけで、小さなモデルの数学正答率が7.9%から48.1%に上がりました。
- 能力の境界:著者はGemma 3 270Mで数学能力の向上を試みましたが、重みの編集では改善が見られませんでした。実験もすべて小さなネットワークで行われています。