让一个 AI 直接改写另一个 AI 的权重,不用重新训练,有一组研究者说他们做到了。麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 四位研究者,11月2日在个人研究博客发表文章,主张最新的大语言模型(LLM)能直接读、改、写另一个神经网络的“权重”,不用经过传统训练。他们把这件事叫做 Weight-Space Programming(权重空间编程)。
这是一篇个人博客文章,尚未经过同行评审,以下结果均为作者所述。
权重是什么?为什么人类无法手动调整
神经网络(AI 模型的核心结构)里有一大串数字,决定它收到输入后怎么反应,这串数字就叫权重。文中实验的网络,小的约一万七千个权重,大的有 8 亿个。
权重平常由训练算法调出来:给模型大量数据,用梯度下降(一种一点一点微调数字、让错误变少的方法)反复修正。人类看不懂这串数字,也很难手写。作者形容,要人类凭空手写一个会下围棋的网络,或看着原始权重预测它的行为,“对绝大多数人来说几乎不可能”。
Weight-Space Programming 的做法
作者的定义是:通用的 LLM 依自然语言目标,直接读写网络的权重,不通过优化器,尤其不用梯度下降,有时连环境反馈都没有。实验用的是 GPT-6 Astra。
白话说,就是把权重当成代码,请 AI 先读懂每一块在算什么,再照目标改写。
三类实验:读、修、写
读:只看权重就说出网络学了什么
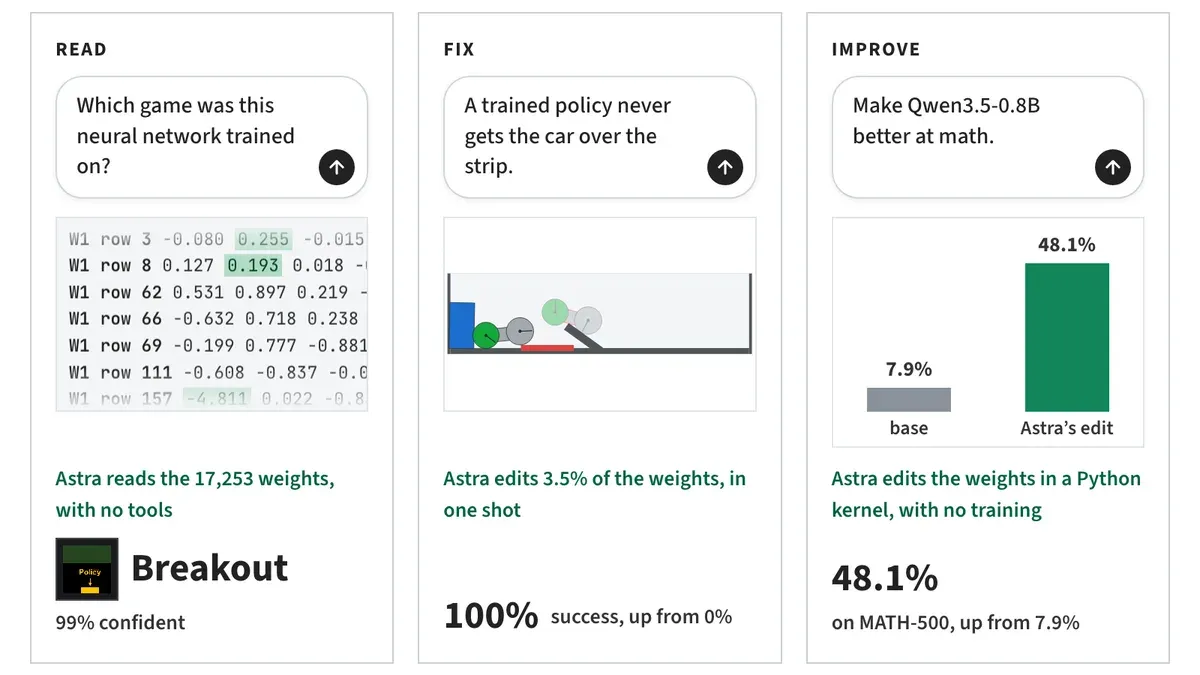
- 猜游戏:四个用强化学习算法(PPO)训练的游戏 AI,结构完全相同,只有权重不同。作者把权重当文本交给 Astra,它四个都答对了游戏名称。
- 猜语言:三个小型语言模型分别学了 Python 代码、日文罗马字和英文。作者拿掉输入层与输出层,只给中间层,Astra 三个都答对了语言。
- 抓谄媚模型:两个 Gemma 3 270M,一个依事实作答,另一个永远顺着用户的意见答。只看权重时,Astra 四次都没分出来。作者放宽条件,让它看模型读文本时的注意力分布后,三组都挑对了。
修:改一小部分权重修好问题
- 卡住的小车:一个 PPO 网络控制小车爬坡,一直卡在坡前。Astra 读完权重与一段日志后一次改写,改动 3.5% 的权重,作者说小车在 1,024 次测试中全部成功。
- Qwen3.5-0.8B 的数学:这个小模型容易陷入“思考循环”,一直重复同样的话,答不出来。Qwen 官方的模型卡(附在模型旁的说明文档)也有提醒这个问题。Astra 找出权重里造成循环的方向,只改动约 0.016% 的权重。作者测得数学题正确率从 7.9% 升到 48.1%,指令遵循测试从 21.0% 升到 62.3%。这个结果是让 Astra 实际试跑模型 50 次后得到的,只试 10 次或 25 次,数学正确率只升到 12.3% 和 14.1%。
写:不训练,直接写出整个网络
作者请 Astra 为三款小游戏(MinAtar)各写一个网络,只给规则与代码,没有数据也不训练。作者表示,Astra 写出的网络在三款游戏都赢过训练 1 亿步的 PPO。另一个实验是 9×9 围棋,网络有约 150 万个权重。作者表示,Astra 试跑 50 次后写出的网络赢过同样大小、对局 2,000 万盘训练出来的 PPO 网络。
作者自己提到的局限
- 这次的改法更像排除障碍:同样的做法用在 Gemma 3 270M 上没有进步,改动带来的数学成绩变化不到一个百分点。作者据此认为,这次的改法更像移除遮住能力的障碍,而不是加入模型原本没有的能力。Qwen 的例子本质上是修好循环,让模型把原本做得出来的题目答完。
- 有些任务光看权重不够:抓谄媚模型一例,要靠额外的注意力数据才成功。
- 效率还不够:作者说目前能力令人兴奋但仍有限,原因是模型一次能处理的文字长度有限,加上操作工具的效率不高。
作者期待的用途
作者列了几个方向,都属于他们的展望,文中尚未证明:
- 不跑测试也能检查模型:直接从权重找出隐藏问题,例如后门。
- 用更少成本调整模型:想加或删一种能力时,不必收集数据再微调,只改少量权重。
- 跨模型嫁接:把一个模型里负责某项能力的内部回路,接进另一个结构不同的模型。
重点整理
- 证据层级:作者个人博客的早期实验,尚未经过同行评审,但日志公开,可以自行检查。
- 最直观的例子:只改 0.016% 的权重,小模型数学正确率从 7.9% 升到 48.1%。
- 能力边界:作者在 Gemma 3 270M 上试着提升数学能力,改权重没有带来进步,实验也都在小网络上。