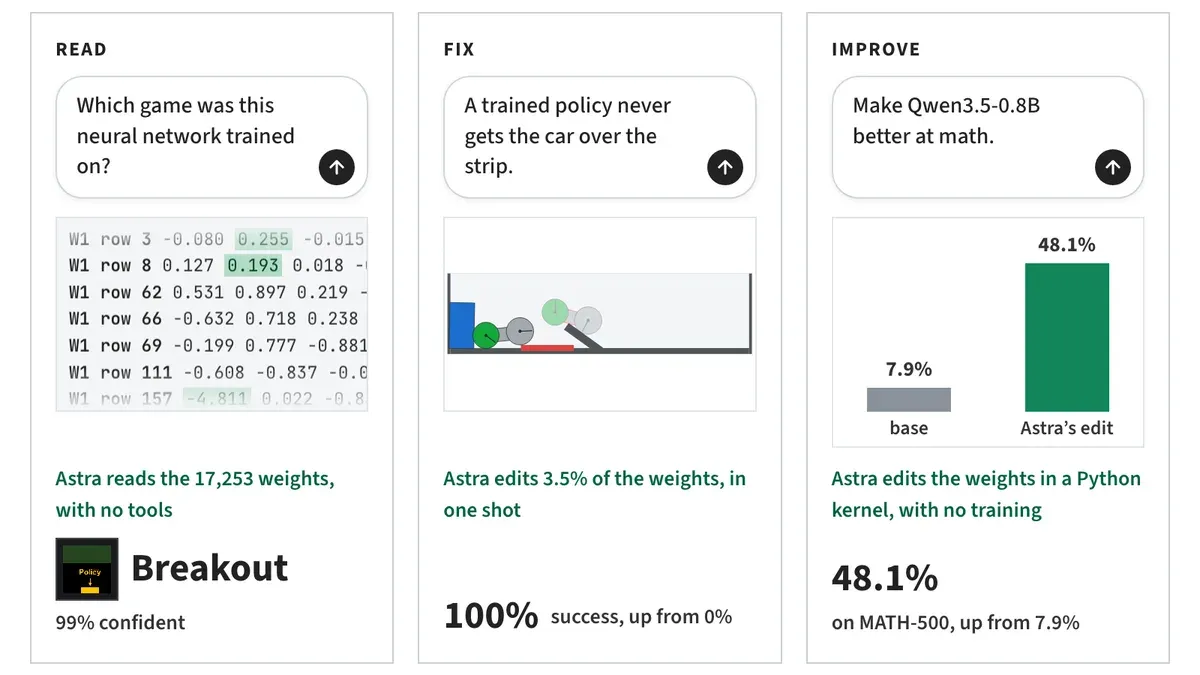
讓一個 AI 直接改寫另一個 AI 的權重,不用重新訓練,有一組研究者說他們做到了。麻省理工學院電腦科學與人工智慧實驗室(MIT CSAIL)的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 四位研究者,11 月 2 日在個人研究部落格發表文章,主張最新的大型語言模型(LLM)能直接讀、改、寫另一個神經網路的「權重」,不用經過傳統訓練。他們把這件事叫做 Weight-Space Programming(權重空間程式設計)。
這是一篇個人部落格文章,尚未經過同行審查,以下結果皆為作者所述。
權重是什麼?為什麼人類無法手動調整
神經網路(AI 模型的核心結構)裡有一大串數字,決定它收到輸入後怎麼反應,這串數字就叫權重。文中實驗的網路,小的約一萬七千個權重,大的有 8 億個。
權重平常由訓練演算法調出來:給模型大量資料,用梯度下降(一種一點一點微調數字、讓錯誤變少的方法)反覆修正。人類看不懂這串數字,也很難手寫。作者形容,要人類憑空手寫一個會下圍棋的網路,或看著原始權重預測它的行為,「對絕大多數人來說幾乎不可能」。
Weight-Space Programming 的做法
作者的定義是:通用的 LLM 依自然語言目標,直接讀寫網路的權重,不透過最佳化器,尤其不用梯度下降,有時連環境回饋都沒有。實驗用的是 GPT-6 Astra。
白話說,就是把權重當成程式碼,請 AI 先讀懂每一塊在算什麼,再照目標改寫。
三類實驗:讀、修、寫
讀:只看權重就說出網路學了什麼
- 猜遊戲:四個用強化學習演算法(PPO)訓練的遊戲 AI,結構完全相同,只有權重不同。作者把權重當文字交給 Astra,它四個都答對遊戲名稱。
- 猜語言:三個小型語言模型分別學了 Python 程式碼、日文羅馬拼音和英文。作者拿掉輸入層與輸出層,只給中間層,Astra 三個都答對語言。
- 抓諂媚模型:兩個 Gemma 3 270M,一個依事實作答,另一個永遠順著使用者的意見答。只看權重時,Astra 四次都沒分出來。作者放寬條件,讓它看模型讀文字時的注意力分佈後,三組都挑對。
修:改一小部分權重修好問題
- 卡住的車:一個 PPO 網路控制小車爬坡,一直卡在坡前。Astra 讀完權重與一段紀錄後一次改寫,改動 3.5% 的權重,作者說小車在 1,024 次測試中全部成功。
- Qwen3.5-0.8B 的數學:這個小模型容易陷入「思考迴圈」,一直重複同樣的話,答不出來。Qwen 官方的模型卡(附在模型旁的說明文件)也有提醒這個問題。Astra 找出權重裡造成迴圈的方向,只改動約 0.016% 的權重。作者測得數學題正確率從 7.9% 升到 48.1%,指令遵循測試從 21.0% 升到 62.3%。這個結果是讓 Astra 實際試跑模型 50 次後得到的,只試 10 次或 25 次,數學正確率只升到 12.3% 和 14.1%。
寫:不訓練,直接寫出整個網路
作者請 Astra 為三款小遊戲(MinAtar)各寫一個網路,只給規則與程式碼,沒有資料也不訓練。作者表示,Astra 寫出的網路在三款遊戲都贏過訓練 1 億步的 PPO。另一個實驗是 9×9 圍棋,網路有約 150 萬個權重。作者表示,Astra 試跑 50 次後寫出的網路贏過同樣大小、對局 2,000 萬盤訓練出來的 PPO 網路。
作者自己提到的限制
- 這次的改法比較像排除障礙:同樣的做法用在 Gemma 3 270M 上沒有進步,改動帶來的數學成績變化不到一個百分點。作者據此認為,這次的改法比較像移除遮住能力的障礙,而不是加入模型原本沒有的能力。Qwen 的例子本質上是修好迴圈,讓模型把原本做得出來的題目答完。
- 有些任務光看權重不夠:抓諂媚模型一例,要靠額外的注意力資料才成功。
- 效率還不夠:作者說目前能力令人興奮但仍有限,原因是模型一次能處理的文字長度有限,加上操作工具的效率不高。
作者期待的用途
作者列了幾個方向,都屬於他們的展望,文中尚未證明:
- 不跑測試也能檢查模型:直接從權重找出隱藏問題,例如後門。
- 用更少成本調整模型:想加或刪一種能力時,不必蒐集資料再微調,只改少量權重。
- 跨模型嫁接:把一個模型裡負責某項能力的內部迴路,接進另一個結構不同的模型。
重點整理
- 證據層級:作者個人部落格的早期實驗,尚未經過同行審查,但日誌公開,可以自行檢查。
- 最直觀的例子:只改 0.016% 的權重,小模型數學正確率從 7.9% 升到 48.1%。
- 能力邊界:作者在 Gemma 3 270M 上試著提升數學能力,改權重沒有帶來進步,實驗也都在小網路上。