AI ハードウェアの話をすると、必ず一つの疑問に行き当たる。コンピューターにはとっくに CPU があるのに、なぜ AI を動かすのにわざわざ GPU を使うのか?
この記事では、両者の違いと、大規模な AI 学習がほぼすべて GPU に頼る理由を噛み砕いて説明する。GPU の関 の対照編であり、AI ハードウェアサプライチェーン総まとめ の入門の土台でもある。
一言でいう違い:質 vs 量
CPU(中央処理装置)と GPU(画像処理装置)の最も肝心な違いは、コアの「数」と「分業」にある。
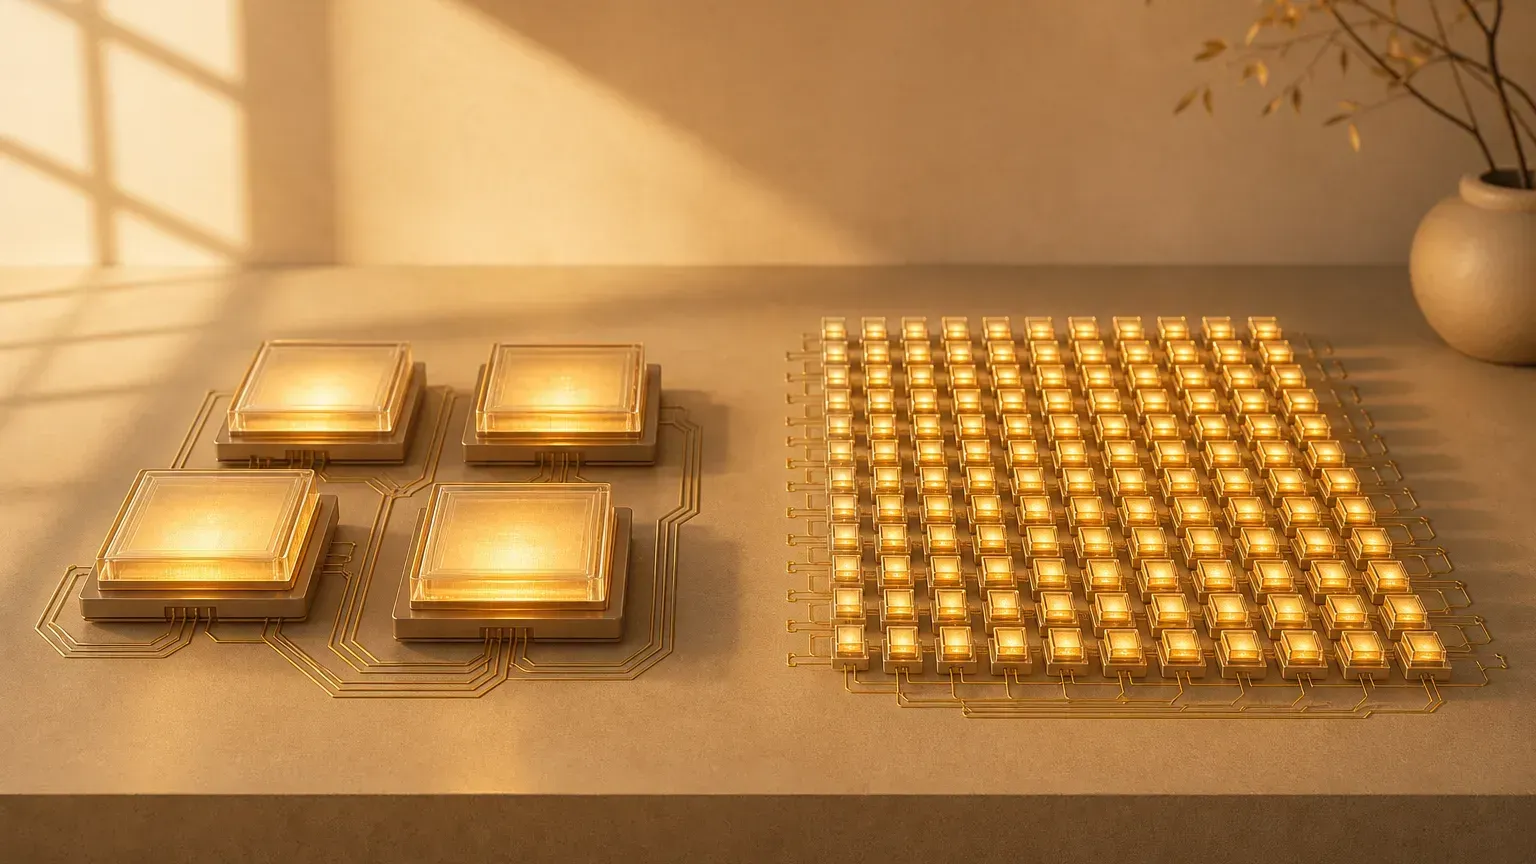
CPU は数個から数十個の非常に強力なコアを持ち、複雑で多様なタスクを順番に処理するのが得意だ。GPU は数千〜数万の比較的単純なコアを持ち、大量の同種の演算を同時に処理するのが得意だ。
たとえるなら、CPU は数人の博士課程の学生だ。一人ひとりが難問を解けるが、人数は少ない。GPU は数千人の小学生だ。一人ひとりは簡単な四則演算しかできないが、人数がとても多い。「同じ種類の問題を数百万回解く」ような仕事では、小学生が一斉に取りかかるほうが驚くほど速い。
なぜ AI 学習に GPU を使うのか
鍵は AI 学習の「仕事の型」にある。
AI モデルの学習は、その根底では膨大で反復的、しかも同時に進められる行列演算(大量の数字の乗加算)だ。この「同じ技を数百万回やる」仕事は、GPU の大量のコアがそろって計算する強みそのものだ。GPU は一度に大きな塊を計算できるが、CPU の少数のコアは一バッチずつ順番に並ぶしかなく、ずっと遅い。
CPU が悪いのではなく、この仕事が CPU の得意分野ではないだけだ。だから大規模モデルの学習と推論は、ほぼすべて GPU か、より専用のチップの上で動いている。
CPU は取って代わられたのではなく、分業している
実際の AI システムでは、CPU と GPU が分業して協力している。
CPU は調整、フロー制御、論理判断とデータ準備を担い、GPU は大量の並列演算をこなす。CPU はプロジェクトマネージャーのように、誰が何をいつやるかを段取りする。GPU は生産ラインに並ぶ大勢の作業員のように、任された同種の仕事を高速で片づける。どちらが欠けても、システム全体がうまく回らない。
GPU よりさらに専用:TPU と ASIC
GPU は並列演算が得意だが、それでもまだ「汎用的」で、いろいろな演算が動く。もっと省エネで速くしたい企業は、さらに専用のチップを作る。
TPU(Google のテンソル処理装置)と AI ASIC は、特定の AI 作業に合わせて作られたチップだ。その作業では GPU より効率的だが、代償として汎用性は劣る。GPU とはどちらかが淘汰する関係ではなく、共存して分業する関係だ。これらのチップの分類は AI チップとは を読んでほしい。
小企鵝(Penchan)のまとめ
CPU と GPU には、それぞれ得意な仕事がある。AI 学習はちょうど GPU が最も得意とする「大量の同種の演算」なので、大規模な学習は主に GPU か専用アクセラレータに頼り、CPU はシステムの中で調整役を担い続ける。