先给答案
effort 是你告诉 Claude“这件事值得花多少精力”的设置。这篇的数据和图表来自 Anthropic 的 Thariq 的文章《Using Claude Code: Spending your effort》(X 原文、claude.dev 互动版),选法和例子则是小企鹅按新手常遇到的工作重新整理的。Anthropic 的服务目前不直接对中国大陆开放。
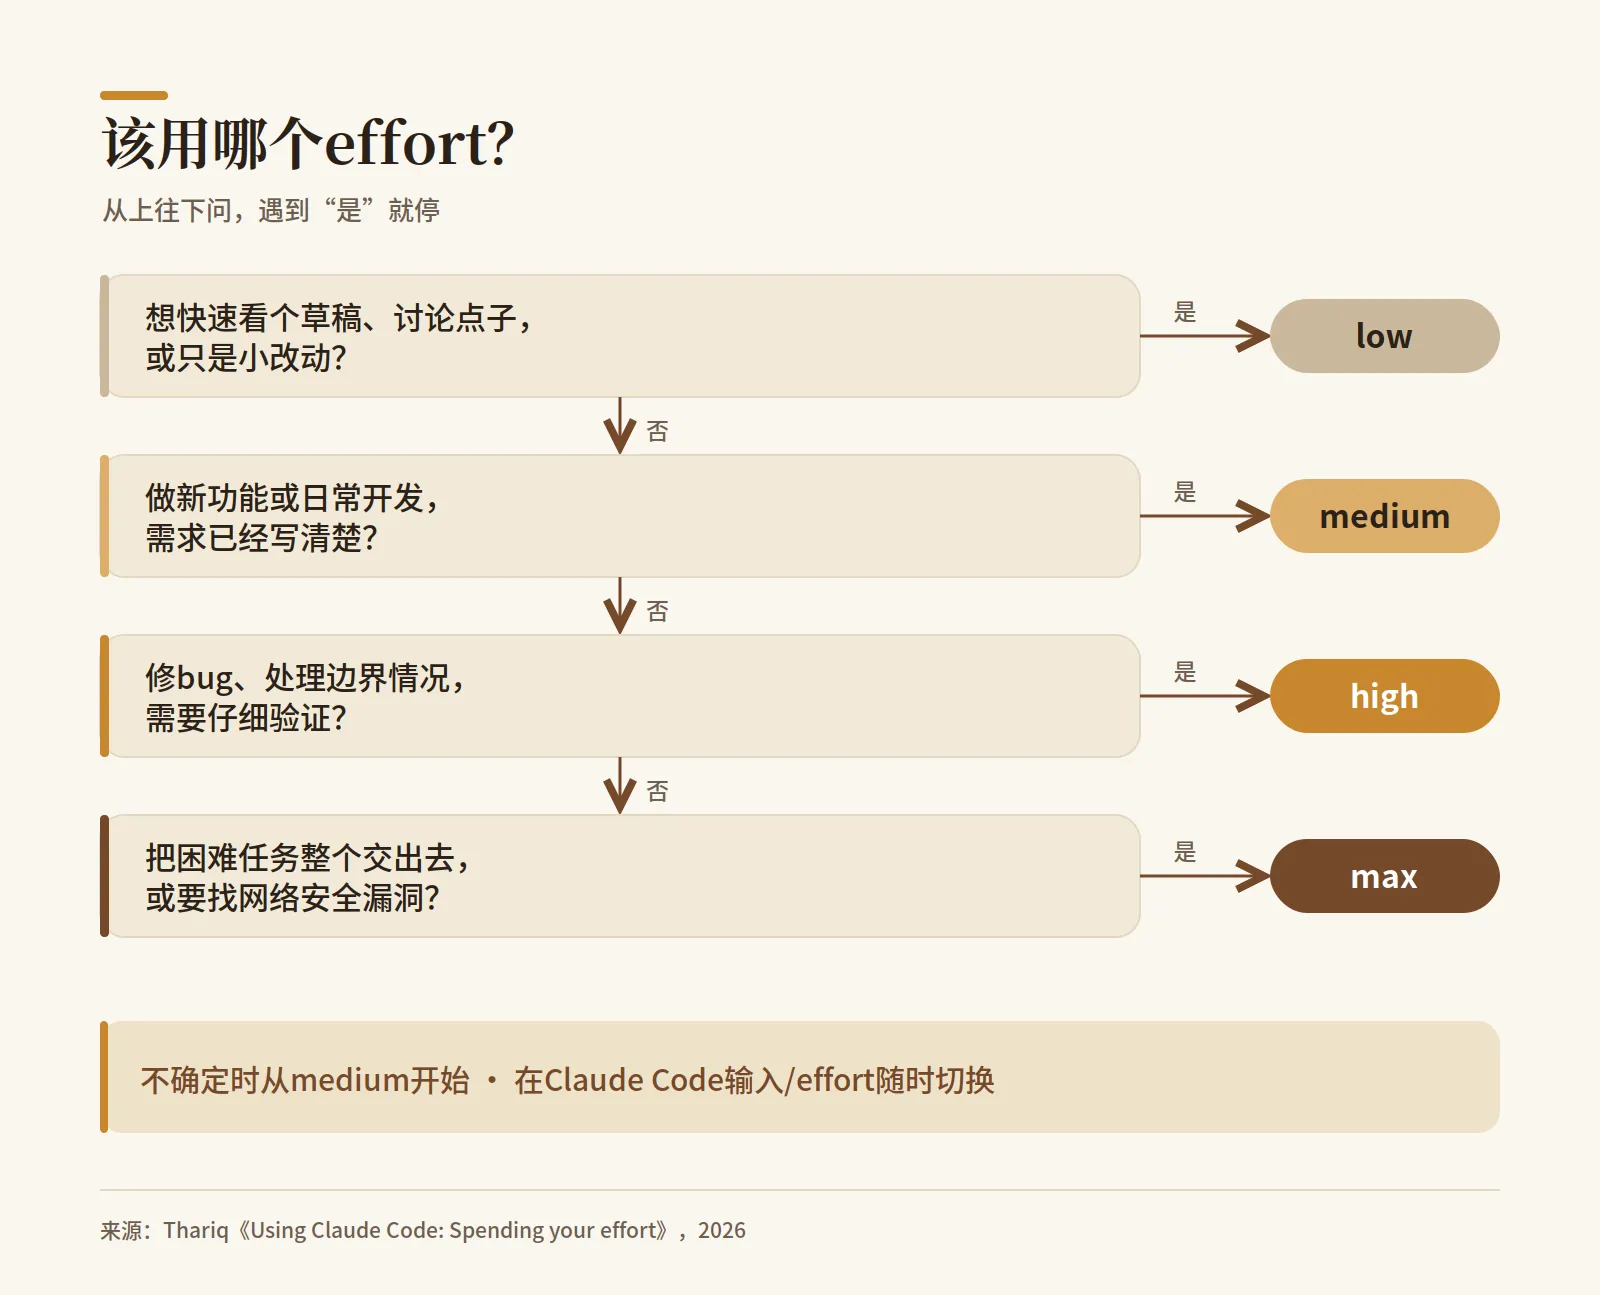
赶时间的话,看这张图就够了:
effort 在调什么
想象你请朋友帮忙看一份文档。跟他说“帮我扫一眼”,他会看完大意就还给你;跟他说“明天要付印,拜托仔细看”,他会逐字核对,顺便帮你改掉几个他觉得不顺的地方。effort 就是这句交代。按 Thariq 的观察,它调整的是 Claude 自己做多少验证、测多少边界情况,以及替你做多少判断。
边界情况(edge case)指的是平常不会遇到、一遇到就出错的特殊状况,比如空白输入、超大文件、奇怪的符号。
所以 effort 开高会带来两件事。Claude 会自己多检查几轮,也会替你多做几个决定。 前者通常是好事,后者要看你想不想自己掌舵。
对照你的任务
先想想你手上的工作比较像下面哪一种:
| 等级 | 你的任务是这样 | 代价 |
|---|---|---|
| low | 改错字、改一段文案、丢几个点子来回讨论 | 等待较短,token 用量相对少 |
| medium | 照着写好的规格,帮现有工具加一个功能 | 等待和 token 用量都在中间 |
| high | 修一个只在特定情况下才出现的 bug | 等待明显变长,token 明显变多 |
| max | 把一个完整的小工具交给 Claude,自己不在旁边盯 | 等待较久,token 用量相对多 |
表上没列的 xhigh 介于 high 和 max 之间,想比 high 再仔细一点、又不想等 max 那么久时可以用。
token 是 AI 处理文本的计算单位,可以粗略理解成字数,用量越多越花钱,也越快用完套餐的额度。等级不用一开始就决定好,在 Claude Code 里输入 /effort,对话到一半也能随时切换。
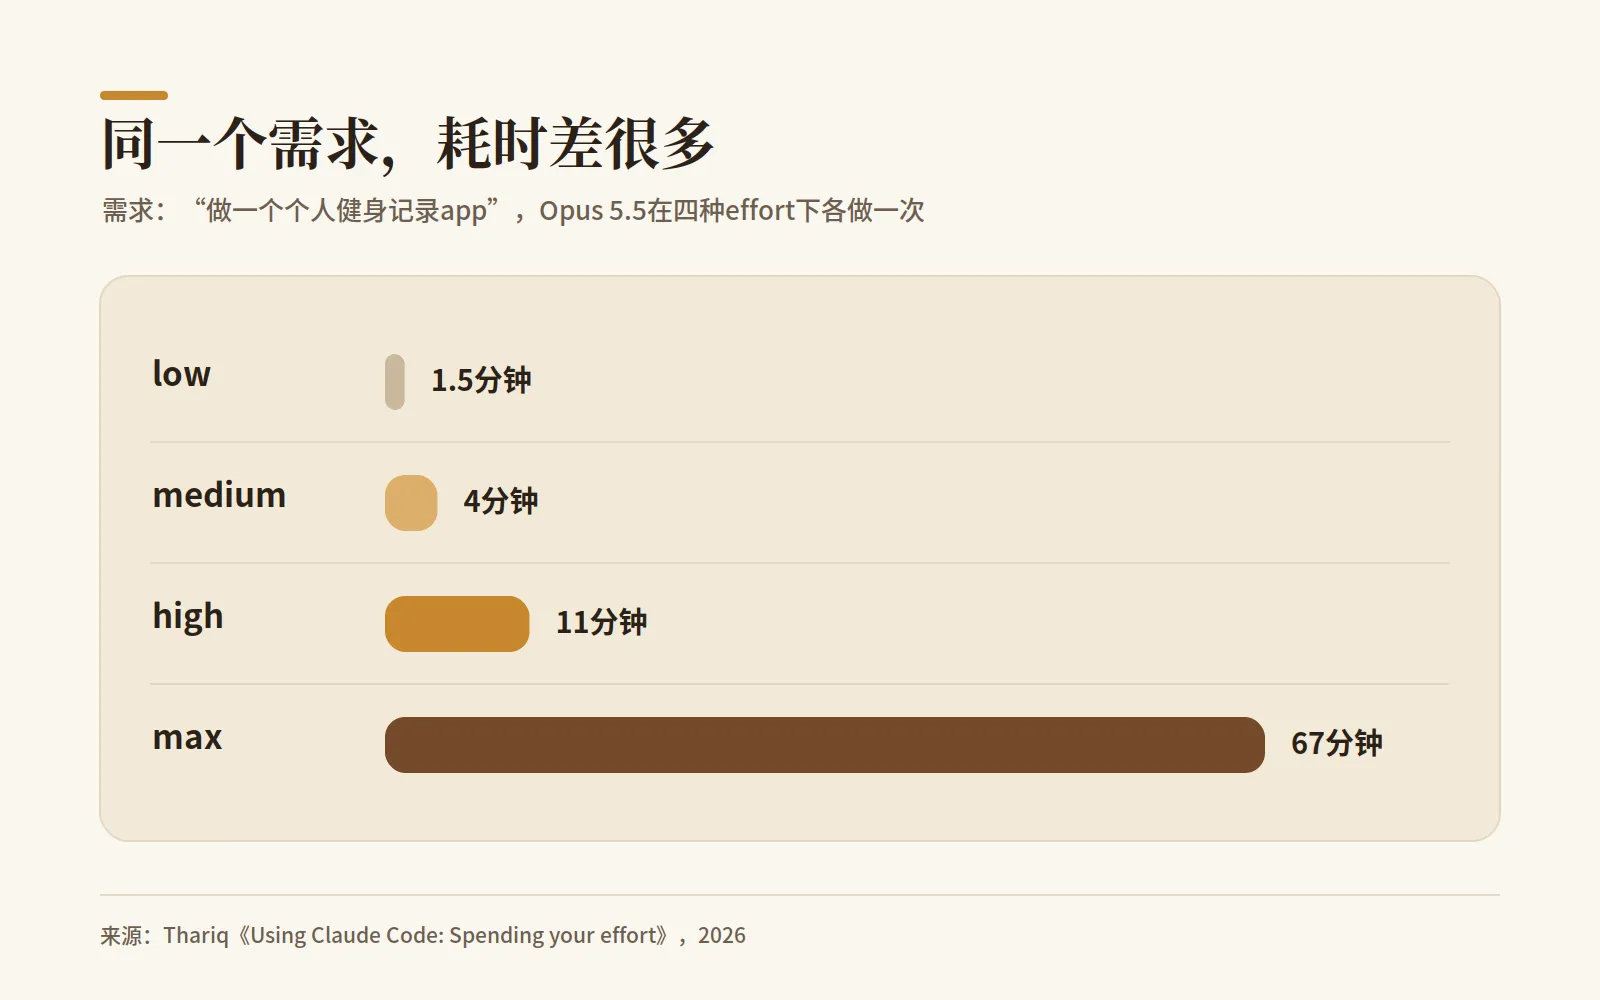
代价差多少?Thariq 拿同一句“做一个个人健身记录 app”测试,low 约 1.5 分钟,max 约 67 分钟,max 版本多了不少 Claude 自己决定添加的功能。
什么时候适合开高
判断方法很简单,问自己三件事:
- 做错了代价大不大?
- 这件事藏着多少特殊情况?
- 你会不会在旁边看着、随时纠正?
前两题回答“大”“多”、第三题回答“不会”,就值得开高。反过来,简单、好检查、你会一路盯着的事,low 或 medium 就够了,多等的时间换不到什么。
Thariq 分析了 Terminal-Bench 3.0(一套由社区出题的测试集)的结果,数据也体现了这个方向。例如有一道题要写 HTML 过滤器,挡掉所有偷偷塞入 JavaScript 的写法,Fable 5.1 在 low 只通过了 5 次里的 1 次,开到 xhigh 则 5 次全通过。按领域看 Fable 5.1 从 low 开到最高 effort 的通过率:
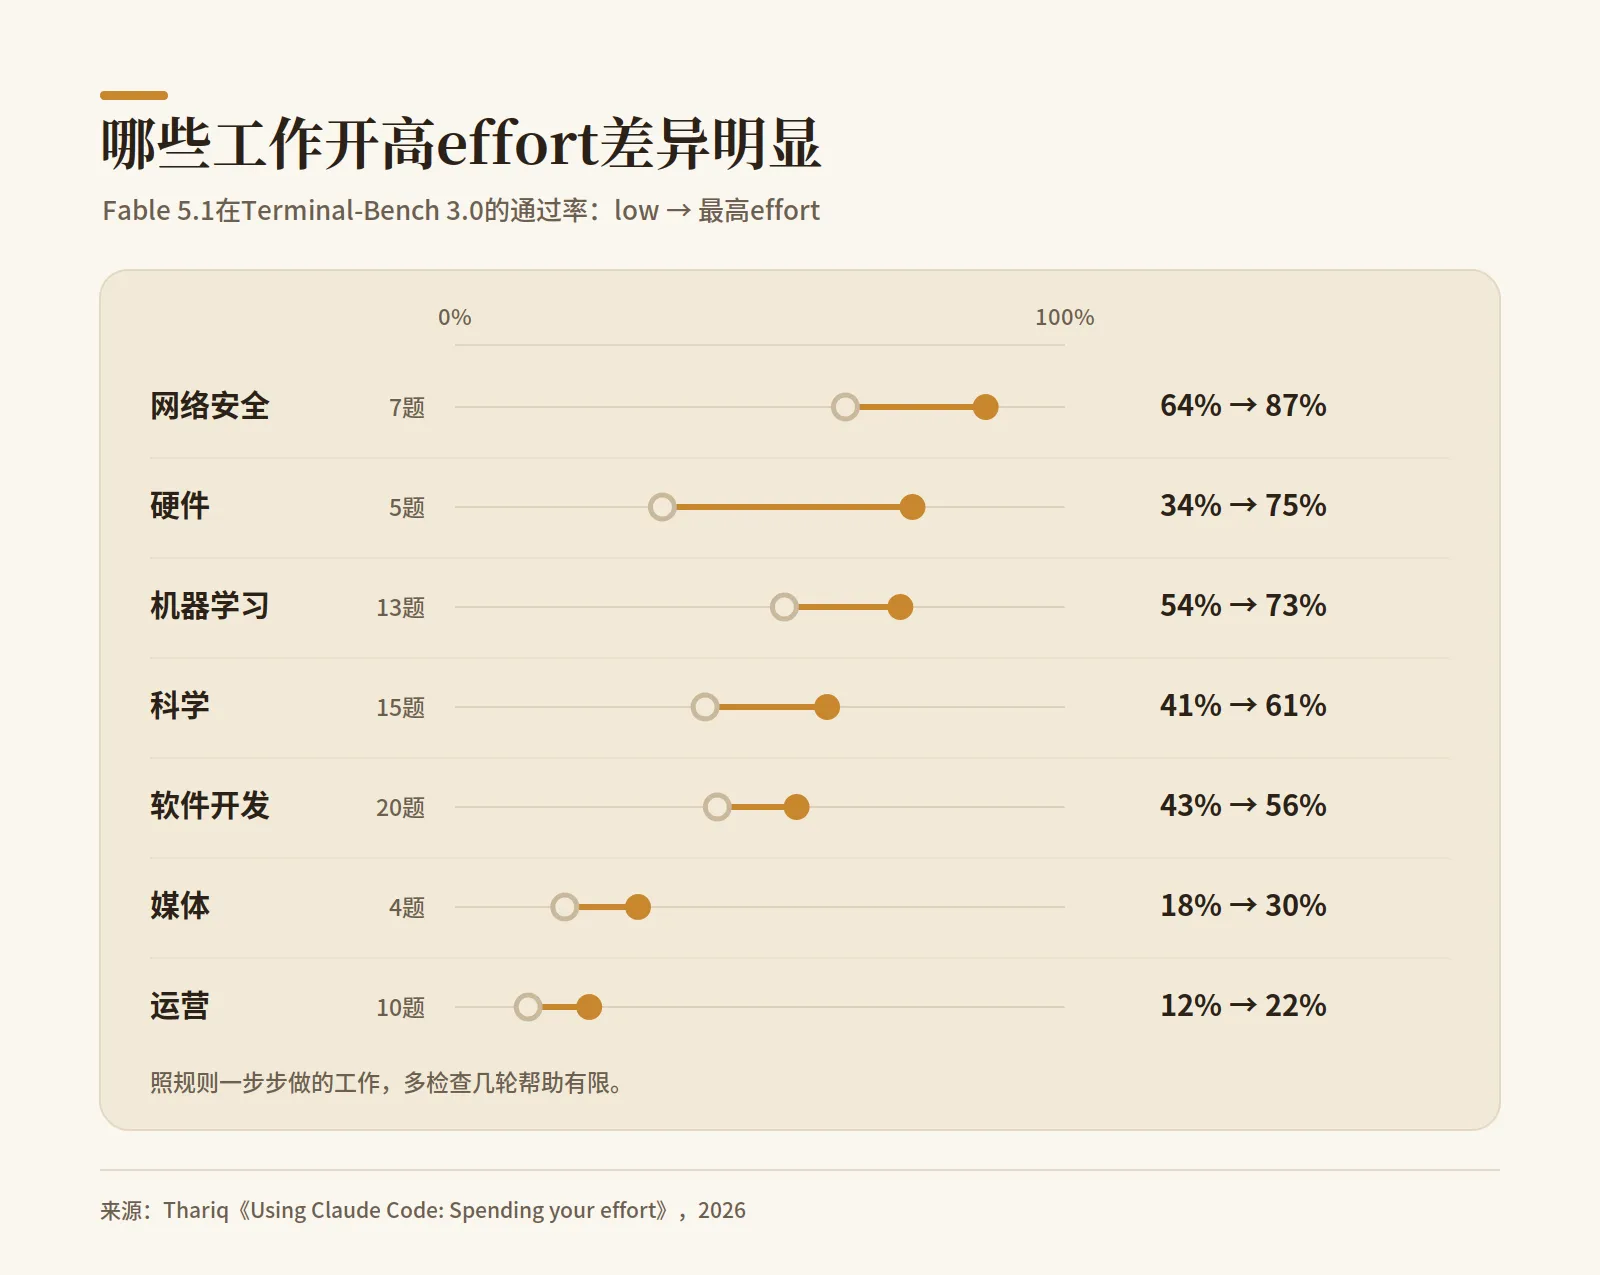
网络安全(64% → 87%)和硬件(34% → 75%)涨幅明显,这两种工作都很依赖反复验证。运营(12% → 22%)和媒体(18% → 30%)的涨幅就小得多。测试里的运营题,是按规定完成一家公司的月底贸易统计申报。小企鹅的理解是,这种照规则一步步做的工作,多检查几轮帮助比较有限。
开高也解决不了的情况
effort 加强的主要是检查,不保证能修正方向。Thariq 在帖子回复里说,除非需求非常模糊,不同 effort 下 Claude 几乎都走同一条路。他的分析也指出,开高能减少因漏掉边界情况造成的失败,但一开始选错方法的话,开高也救不回来。
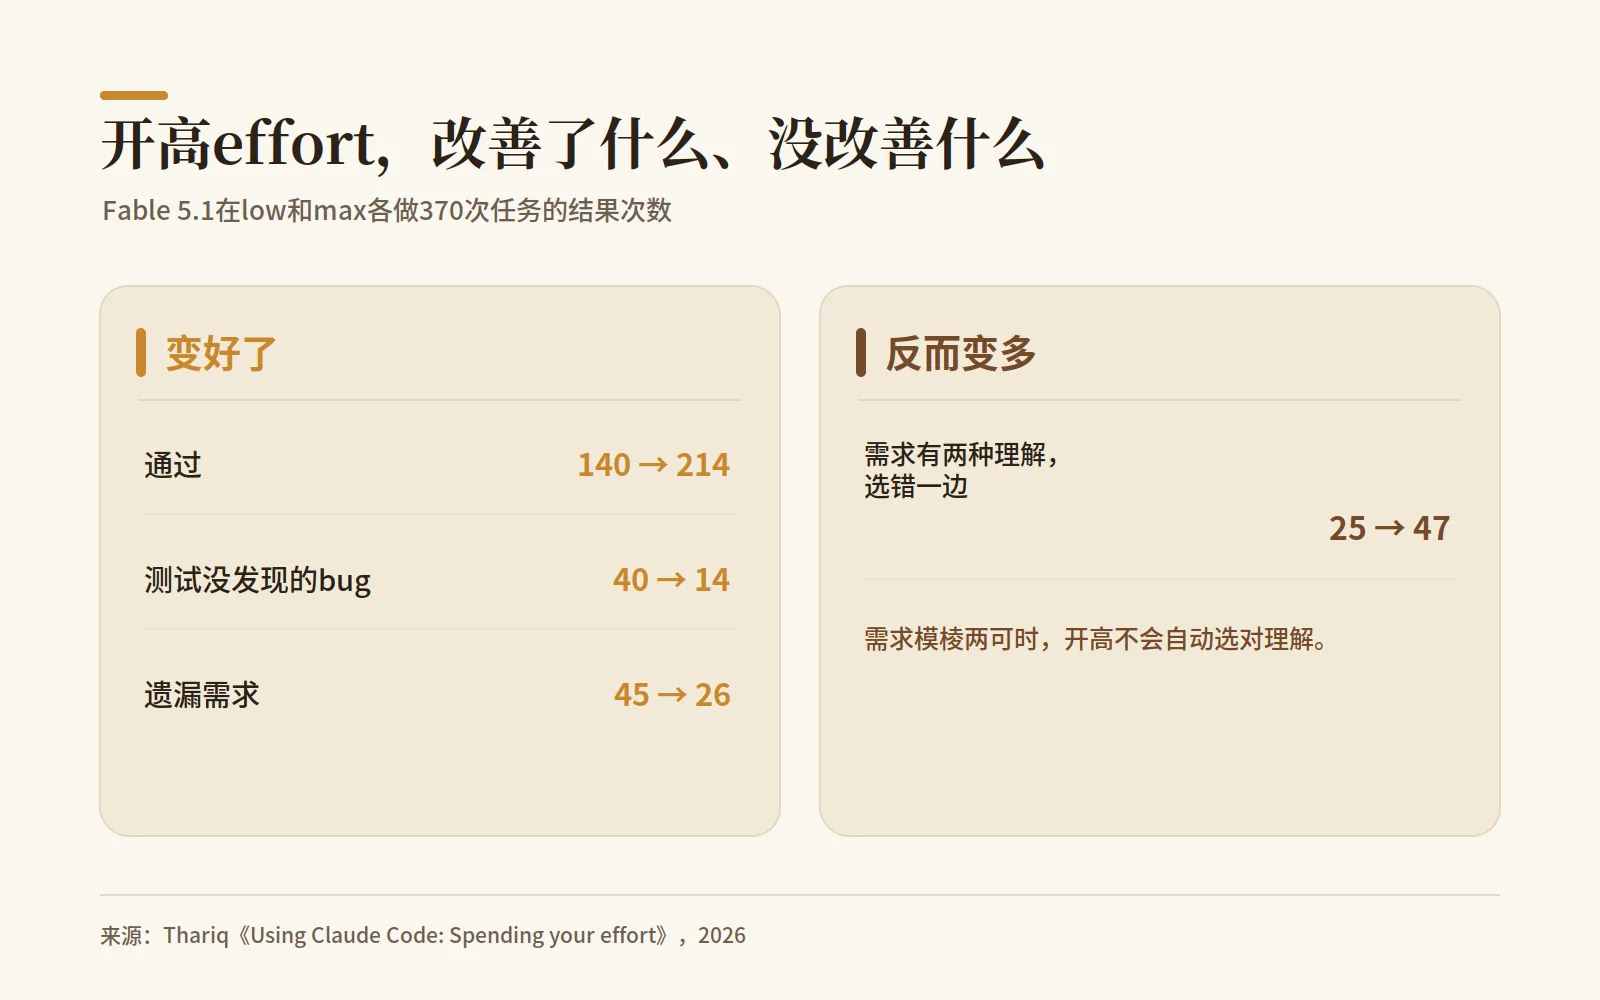
Fable 5.1 在 low 和 max 各做 370 次,通过数、测试没发现的 bug、遗漏需求都变少了,唯独“需求有两种理解,选错一边”从 25 次增加到 47 次。effort 越高,Claude 越会替你做假设。需求模棱两可时,开高不会自动选对理解。 选错了,就是花更多时间做错的东西。
解决办法在你这边:
- 写出“做完是什么样子”,例如要有哪几个界面、数据存在哪里。
- 列出不要做的事,免得 Claude 自己加内容。
- 发现一句话有两种理解,自己先选一种写进去。
- 先用 low 或 medium 做出第一版,确认方向对了,最后再切到 high 做完整验证(Thariq 自己做新功能也是这样切换)。
Thariq 还发现,先把需求写成一份详细的规格(spec)再交给不同模型、不同 effort 去做,这次各版本就很接近。先写清楚需求,再决定 effort。
小企鹅的总结
小企鹅自己有一支 AI 团队在分工,effort 大概是这样分配的:
- 每天的调度和分派工作:high
- 照着写好的规格做例行开发:medium
- 策略和系统架构的决定:xhigh
这是读完 Thariq 这篇之后重新分配的。effort 买到的是检查,方向要靠清楚的需求。规格写清楚的工作,medium 就很够用;真正需要开高的,是那些做错代价很大、又藏着很多特殊情况的事。
延伸阅读
参考资料
- Thariq,《Using Claude Code: Spending your effort》,X Article,2026-09-25:https://x.com/trq212/status/2103576349499855160
- 互动版:https://claude.dev/blog/spending-your-effort/
- Thariq 的帖子回复,2026-09-25:https://x.com/trq212/status/2103580172498927714