ひとことで要点
Meta Superintelligence Labsは2026年10月12日(米国時間)、Muse Wonderシリーズを発表しました。モデルは二つあり、Muse WonderはAPIとMuse Codeで使え、より高性能なMuse Wonder FullはMuse Codeのサブスクリプション利用者だけに提供されます。Metaは、どちらも個人と専門的なagentタスクでstate-of-the-artに達したとしています。Metaが10月12日に引用したArtificial Analysisのグラフでは、Fullは56で、Claude Opus 5.5の58を下回ります。また、Muse WonderのAPI料金はOpus 5.5と同じです。ここでいうMuse Wonderはモデルで、Muse appではありません。アプリの機能と利用制限はMeta Museとはをご覧ください。 Metaによると、これは14か月前にAIの立て直しを始めてからの成果で、法律、金融、健康などの専門的な仕事と、長時間自分で作業を進めるagentに重点を置いています。これらはMeta自身の説明です。
Muse WonderとMuse Wonder Fullの違い
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| model ID | muse-wonder-1.0 | muse-wonder-full-1.0 |
| 使い方 | Meta Model API、Muse Code | Muse CodeのPower、Maximumプランのみ |
| 料金 | API入力4ドル/出力20ドル(100万tokenあたり) | API料金なし、サブスクリプション制 |
| AA総合指数 | 52 | 56 |
| context | 1M tokens | 1M tokens |
Muse appについては、Muse appについては、MetaはWonderが「soon」にMuseで使われるようになり、サブスクリプション利用者を優先するとしていますが、日付は示していません。reasoning effortをmaxにしてもFullには切り替わりません。両者は別々のモデルです。Muse Wonderは現在もpreviewと表示されており、入力はテキスト、画像、動画、音声、PDFに対応し、出力はテキストです。
ベンチマークの見方
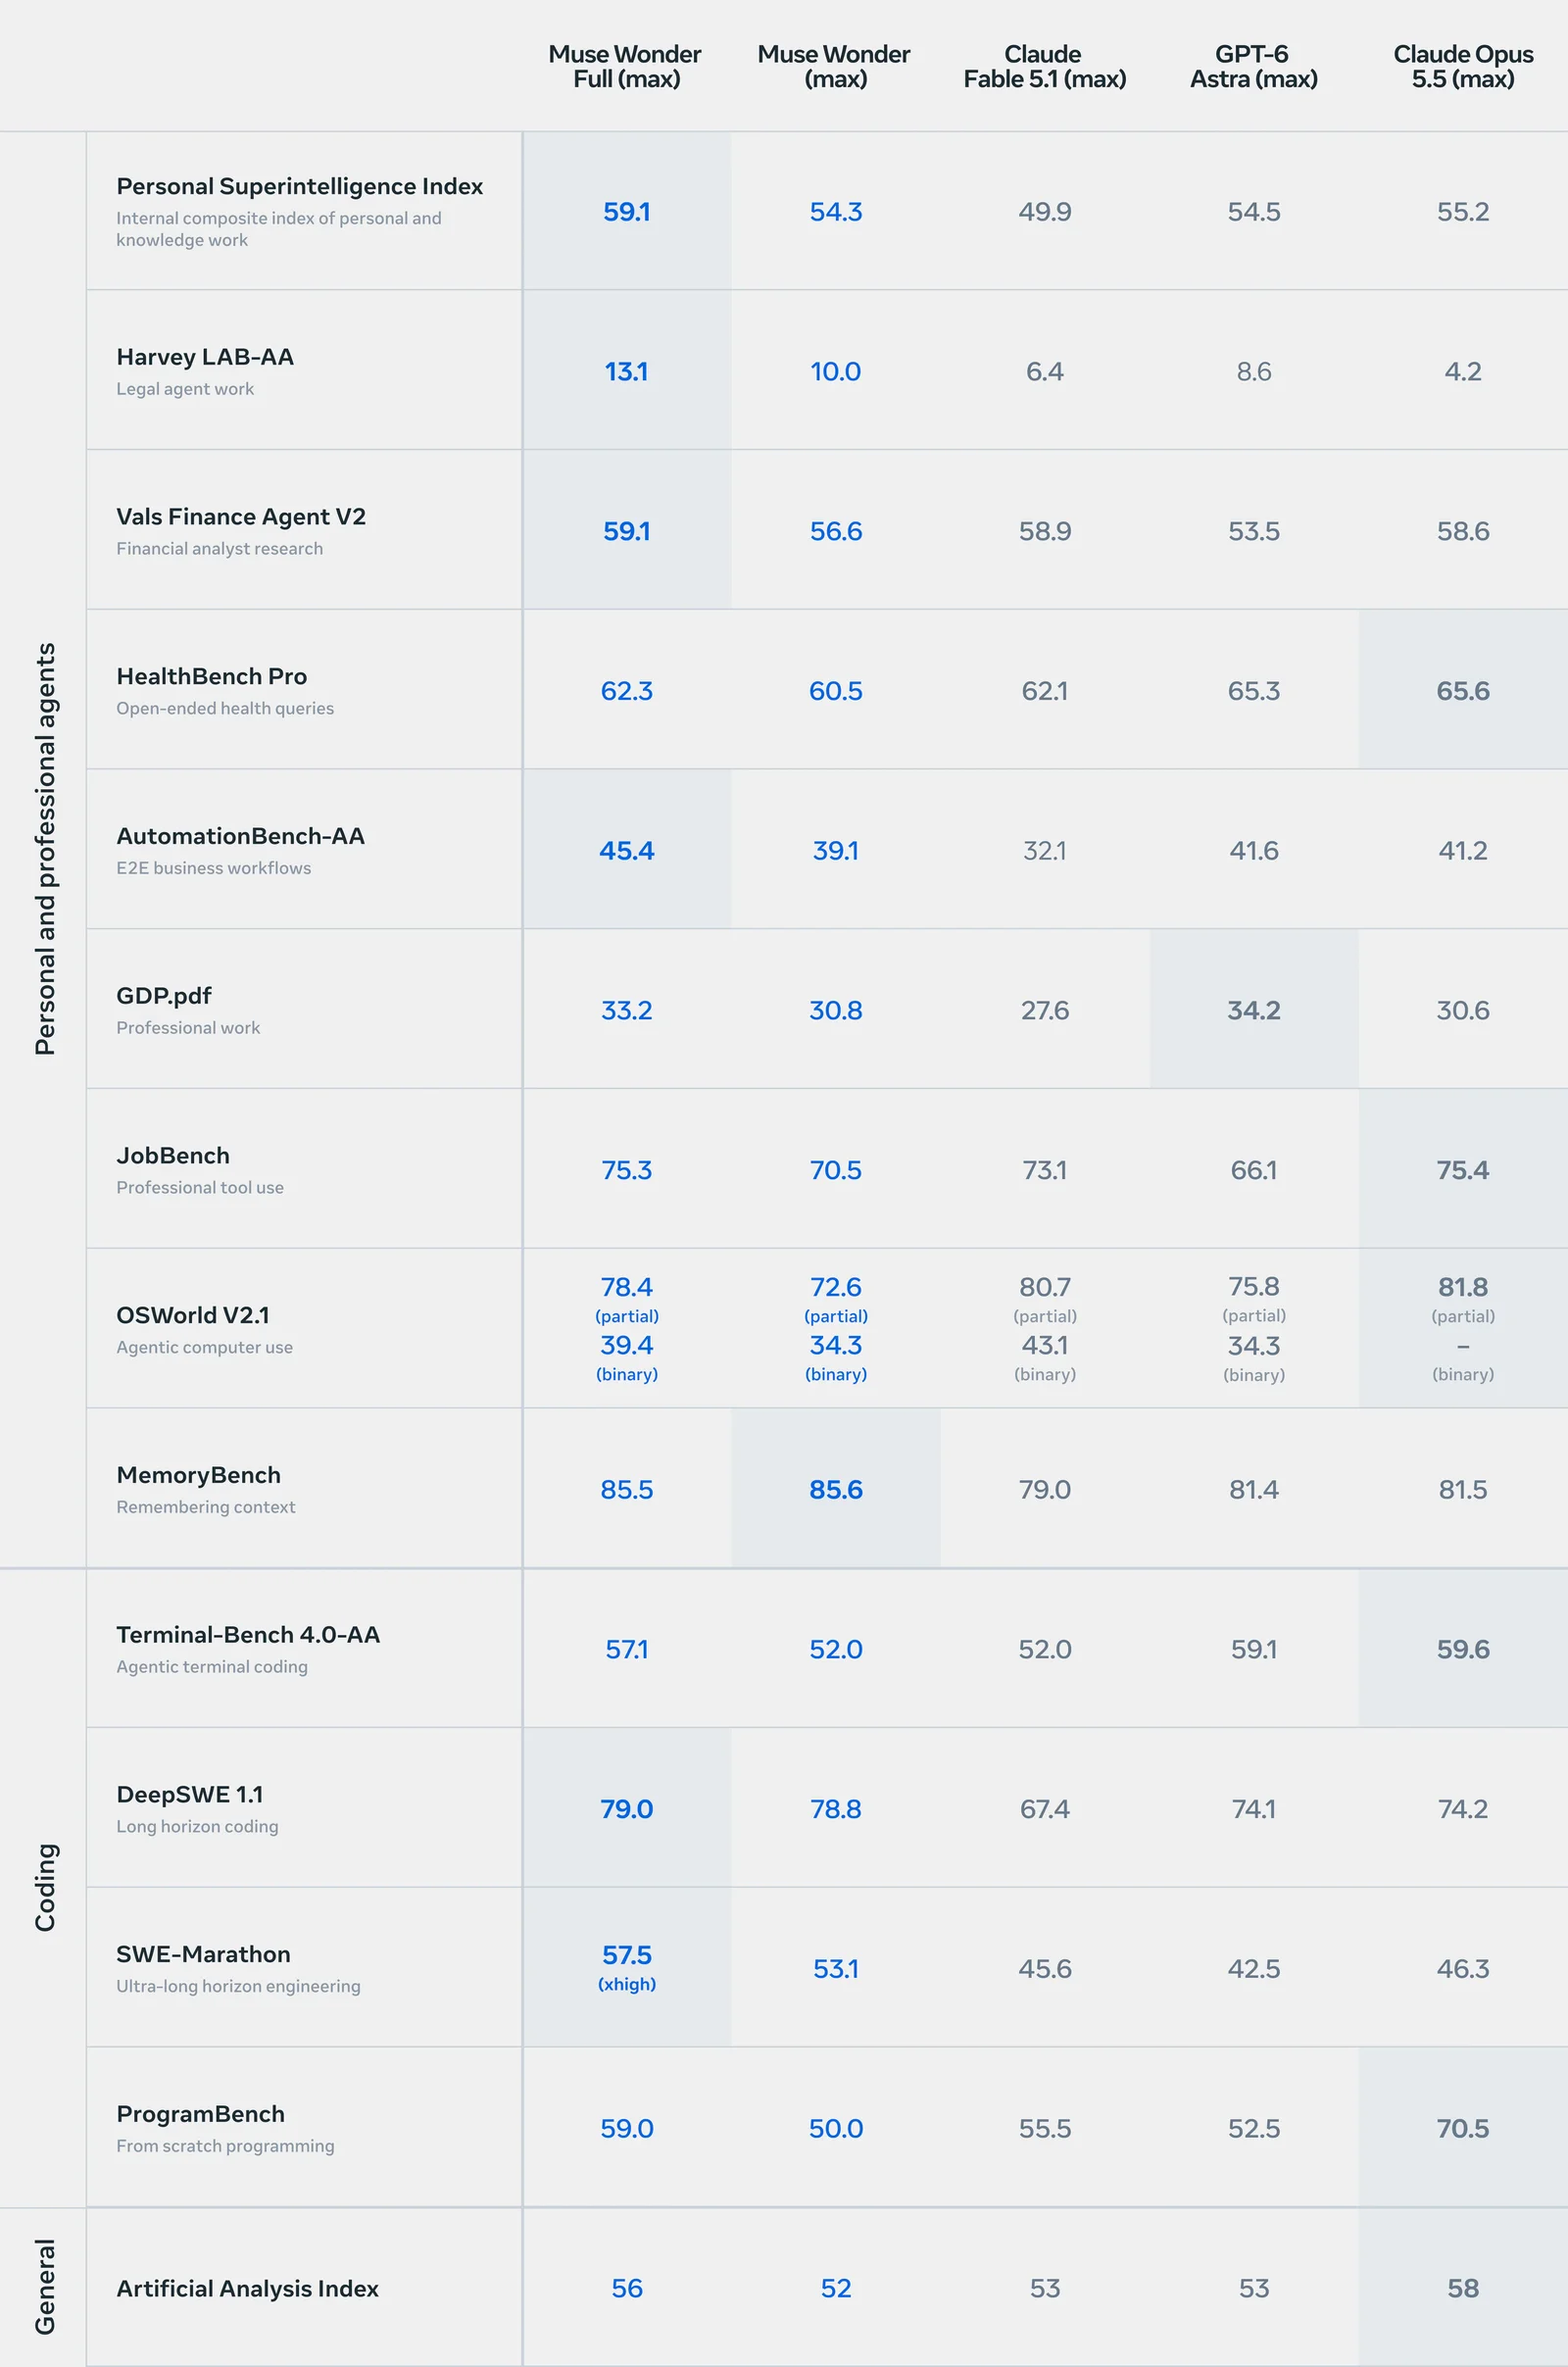
ベンチマークとは、モデルに一連の課題をこなさせ、各テストのルールに沿って点数をつけるものです。この表は大半がmax設定と表示されていますが、SWE-MarathonのFullはxhighです。また、モデルが違えば、同じ名前の設定でも同じ時間や計算量を使うとは限りません。スコアだけでなく、誰が問題を作り、誰が実行したか、比較条件がそろっているかも確認しましょう。
第三者が実行した評価には、Harvey LAB-AA、AutomationBench-AA、Vals Finance Agent V2があります。Metaの表によると、Harvey LAB-AA v1.1ではFullが13.1、Opus 5.5が4.2で、完全に合格し、かつ重大なハルシネーションがない割合はまだ低い水準です。AutomationBench-AAではFullが45.4、GPT-6 Astraが41.6です。model cardによると、ここではタスク全体での厳格な合格率を使っており、AAのサイトに別途掲載されている目標達成スコアとは異なります。Vals Finance Agent V2はVals AIが実行したもので、Fullが59.1、Fable 5.1が58.9と、差はごくわずかです。これらの比較は表に載っているモデルに限られ、ランキング全体での1位を意味するものではありません。
もう一方のグループでは、社内評価かどうかと比較条件を分けて見る必要があります。Personal Superintelligence IndexはMetaの社内総合指数で、7項目のテストで構成されていますが、model cardは計算式を開示していません。MemoryBenchとFocusBenchもMetaの社内テストです。DeepSWE 1.1は、Datacurveによる第三者の結果とベンダーの自己申告スコアが混ざっています。SWE-Marathonの結果はAbundant AIによるものですが、他のモデルは別のagentを使い、Fullもxhighを使っているため、同じ実行環境での比較とはみなせません。Metaは、自社で実行した他社モデルのテストはあくまでベストエフォートの比較で、プロンプト、ツール、実行環境が最適に調整されているとは限らないとも注意しています。
Metaのこの表では、Opus 5.5はHealthBench ProとTerminal-Bench 4.0-AAでリードし、OSWorld V2.1のpartialスコア(81.8)でもリードしています。JobBenchでは75.4で、Fullの75.3とほぼ同じです。GDP.pdfではGPT-6 Astraがリードしています(34.2)。ProgramBenchでは表内のモデルがすべてmini-swe-agentを使っており、Opus 5.5が70.5、Fullが59.0です。ここで数えているのは、テストの95%以上に合格した実行の割合で、完全な再構築に成功した割合ではありません。このテストはMetaと学術チームが共同で構築したものです。Terminal-Bench 4.0-AAもmini-swe-agentを使っています。
一つの数字だけを見たいなら、まずArtificial Analysisの総合指数を見るとよいでしょう。10項目のテストで構成され、すべてのモデルを同じ第三者が統一して評価しています(Metaが引用、日付は2026-10-12、スコアは指数のポイントで、パーセントではありません):
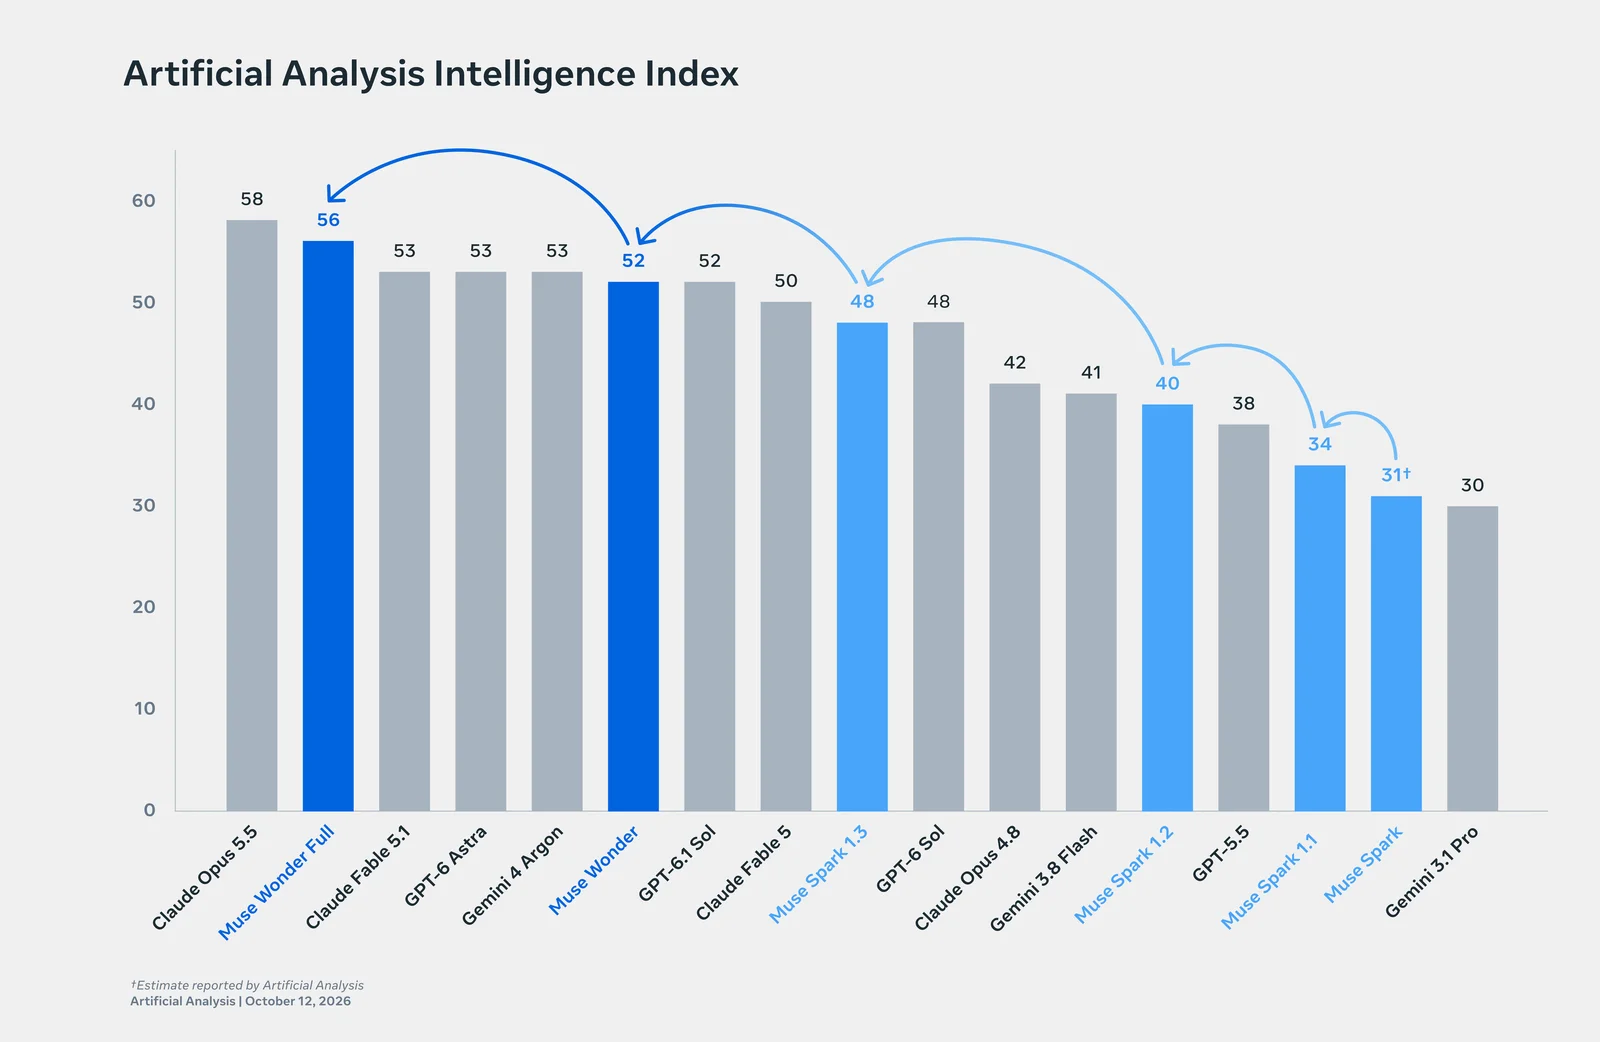
Metaの10月12日のこのグラフでは、Fullは56で、Opus 5.5の58を下回ります。グラフ中のFable 5.1、GPT-6 Astra、Gemini 4 Argonはいずれも53で、Muse Wonderより1ポイント高くなっています。API版のMuse Wonderは52で、基本のtoken単価はOpus 5.5と同じですが、指数は6ポイント低くなります。これはグラフに載っているモデルどうしの比較で、現在のランキング全体での順位を示すものではありません。
2026年10月13日時点で、Artificial AnalysisはMuse WonderとFullの評価ページを公開しており、スコアは同じく52と56、FullはAAの全体ランキングで4位です。ValsのFinance Agent V2にも両モデルが掲載されています。上のグラフはあくまでMetaが10月12日に公開したスナップショットで、第三者サイトの最新の全体ランキングとして見ることはできません。
料金と使い方
| API、100万tokenあたり | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
Muse Wonder(muse-wonder-1.0) | 4ドル | 20ドル | 0.20ドル |
| Claude Opus 5.5 | 4ドル | 20ドル | 0.20ドル |
入力と出力をそれぞれ100万token使うと、どちらも24ドルです。Muse Wonderのweb search groundingは、1,000回の検索ごとに2.50ドルが別途かかります。OpenRouterにも掲載されており(meta/muse-wonder)、価格は同じです。公式ドキュメントには、長いcontextでも追加料金はなく、reasoning tokensは出力tokenと同じ単価だと明記されています。そのため、effortをmaxにするとtokenを多く使い、請求額もそれだけ増えます。
Muse Codeは、ターミナルやCIで動くMetaのcoding agentで、計画を立て、コードを修正し、コマンドを実行できます。サブスクリプションには四つのプランがあり、いずれも月額です:
| プラン | 月額料金 | Muse Wonder Fullの利用 |
|---|---|---|
| Everyday Usage | 5ドル | 不可 |
| High Usage | 15ドル | 不可 |
| Power Usage | 50ドル | 可 |
| Maximum Usage | 200ドル | 可 |
先に知っておきたいことが二つあります:
- Contributor mode:Muse CodeのサブスクリプションではContributor modeがデフォルトでオンになっています。利用量が多くなる代わりに、送信したプロンプト、コード、ファイル、コンテキスト、モデルの回答を、Metaが今後のモデルの学習に使うことを許可することになります。設定でオフにでき、オフにした後の新しい内容は学習に使われません。Muse WonderのAPIにはStandard modeしかなく、内容はMetaのモデルの学習に使われません。
- 台湾:Metaは国ごとのリストを公開しておらず、APIは「Meta AIが利用でき、支払いに対応しているほとんどの国と地域」で提供されるとだけ説明しています。台湾は利用可能な地域として明記されておらず、制限リストにも入っていません(中国は香港・マカオを含めて入っています)。そのため、必ず使えるとは言えません。登録時に確認してください。
Active MemoryとActive Focus
Metaが強調している二つの機能です。Active Memoryは会話をまたいで重要な情報を覚え、必要なときに今のタスクに関係する詳細を自ら取り出します。Active Focusは、行き詰まったときに方法を変えて作業を続け、必要なら質問し、重要な操作の前にはユーザーに確認します。MetaはMemoryBenchとFocusBenchでこの二つの能力を示しており、どちらもMetaの社内テストです。これらはすべてMeta自身の説明とテストで、現時点では独立したテストによる検証はありません。実際に宣伝どおりに使えるかは、ユーザーの報告を待つ必要があります。
安全性とオープンソース
model cardによると、安全対策がない状態では、Fullが化学・生物分野でhighリスクのしきい値に達する可能性をMetaは排除できません。サイバーセキュリティと制御喪失のリスクはmoderate以下です。安全対策を加えると、すべての分野がmoderate以下になり、Metaはこれを根拠にリリースを決めました。Metaはさらに、許可なく個人情報を共有することを防ぐ対策があり、悪意のある指示にも抵抗するとしています。別の完全版安全性レポートについて、Metaは「available soon」としていますが、10月13日時点ではまだ確認できていません。
Muse Wonderシリーズのウェイトを公開するかどうか、Metaはまだ発表していません。Meta Model APIのモデル一覧では、オープンウェイトのモデルはMuse Glimmer(30B)です。Axiosによると、Meta Superintelligence Labsの責任者Alexandr Wangは、今後もオープンソースを支持し続けると述べています。
小企鵝のまとめ
AAの総合指数を見ると、Muse Wonderシリーズはトップクラスのモデルに近づいていますが、Fullの56はOpus 5.5の58をまだ下回っています。Metaの発表した表では、Fullは法律と自動化のテストで表内の他モデルを上回っていますが、これはランキング全体での1位を意味せず、API版のMuse Wonderにそのまま当てはめることもできません。各テストの出典と比較条件は、引き続き分けて見る必要があります。
API利用者にとって、Muse Wonderの基本のtoken単価はOpus 5.5と同じで、AA指数は52対58です。Fullがリードした成績は、API版にそのまま当てはめられません。まずAAとValsが公開した評価を参考にし、自分のワークフローで小規模にテストするとよいでしょう。単価が同じでも、同じタスクを終えるまでの総費用が同じとは限りません。Muse CodeでFullを使うなら、Power(月50ドル)またはMaximum(月200ドル)プランを選べます。使う前にContributor modeの設定を確認しておきましょう。
関連記事
カバー画像出典:Meta(research.meta.ai/blog/muse-wonder)
本記事はAIツールの機能紹介とサブスクリプションプランの消費者向け比較であり、証券や投資に関する助言ではありません。実際の料金は各プラットフォームの最新の公式発表に従います。本記事の情報は古くなっている可能性があります(2026年10月13日時点の情報)。