一句話重點
Meta Superintelligence Labs 在 2026 年 10 月 12 日(美國時間)發表 Muse Wonder 系列,包含兩款模型:Muse Wonder 可用 API 與 Muse Code,能力更強的 Muse Wonder Full 只開放給 Muse Code 訂閱者。Meta 稱兩款在個人與專業 agent 任務上達到 state-of-the-art;Meta 在 10 月 12 日引用的 Artificial Analysis 圖表中,Full 是 56,低於 Claude Opus 5.5 的 58,而 Muse Wonder 的 API 價格跟 Opus 5.5 一樣。 這裡的 Muse Wonder 是模型,不是 Muse app,app 的功能與使用限制請看 Meta Muse 是什麼。 Meta 說,這是它在 14 個月前開始重建 AI 之後的成果,重點放在法律、金融、健康等專業工作,以及長時間自己做事的 agent。這些是 Meta 自己的說法。
Muse Wonder 跟 Muse Wonder Full 差在哪
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| model ID | muse-wonder-1.0 | muse-wonder-full-1.0 |
| 怎麼用 | Meta Model API、Muse Code | 只有 Muse Code 的 Power、Maximum 方案 |
| 價格 | API 輸入 4 美元/輸出 20 美元(每百萬 token) | 無 API 價格,訂閱制 |
| AA 綜合指數 | 52 | 56 |
| context | 1M tokens | 1M tokens |
Muse app 方面,Meta 說 Wonder「soon」會用在 Muse 上,訂閱者優先,沒有給日期。把 reasoning effort 設成 max,也不會切換成 Full,它們是兩個不同的模型。Muse Wonder 目前還標示為 preview,輸入可以是文字、圖片、影片、音訊與 PDF,輸出是文字。
跑分怎麼看
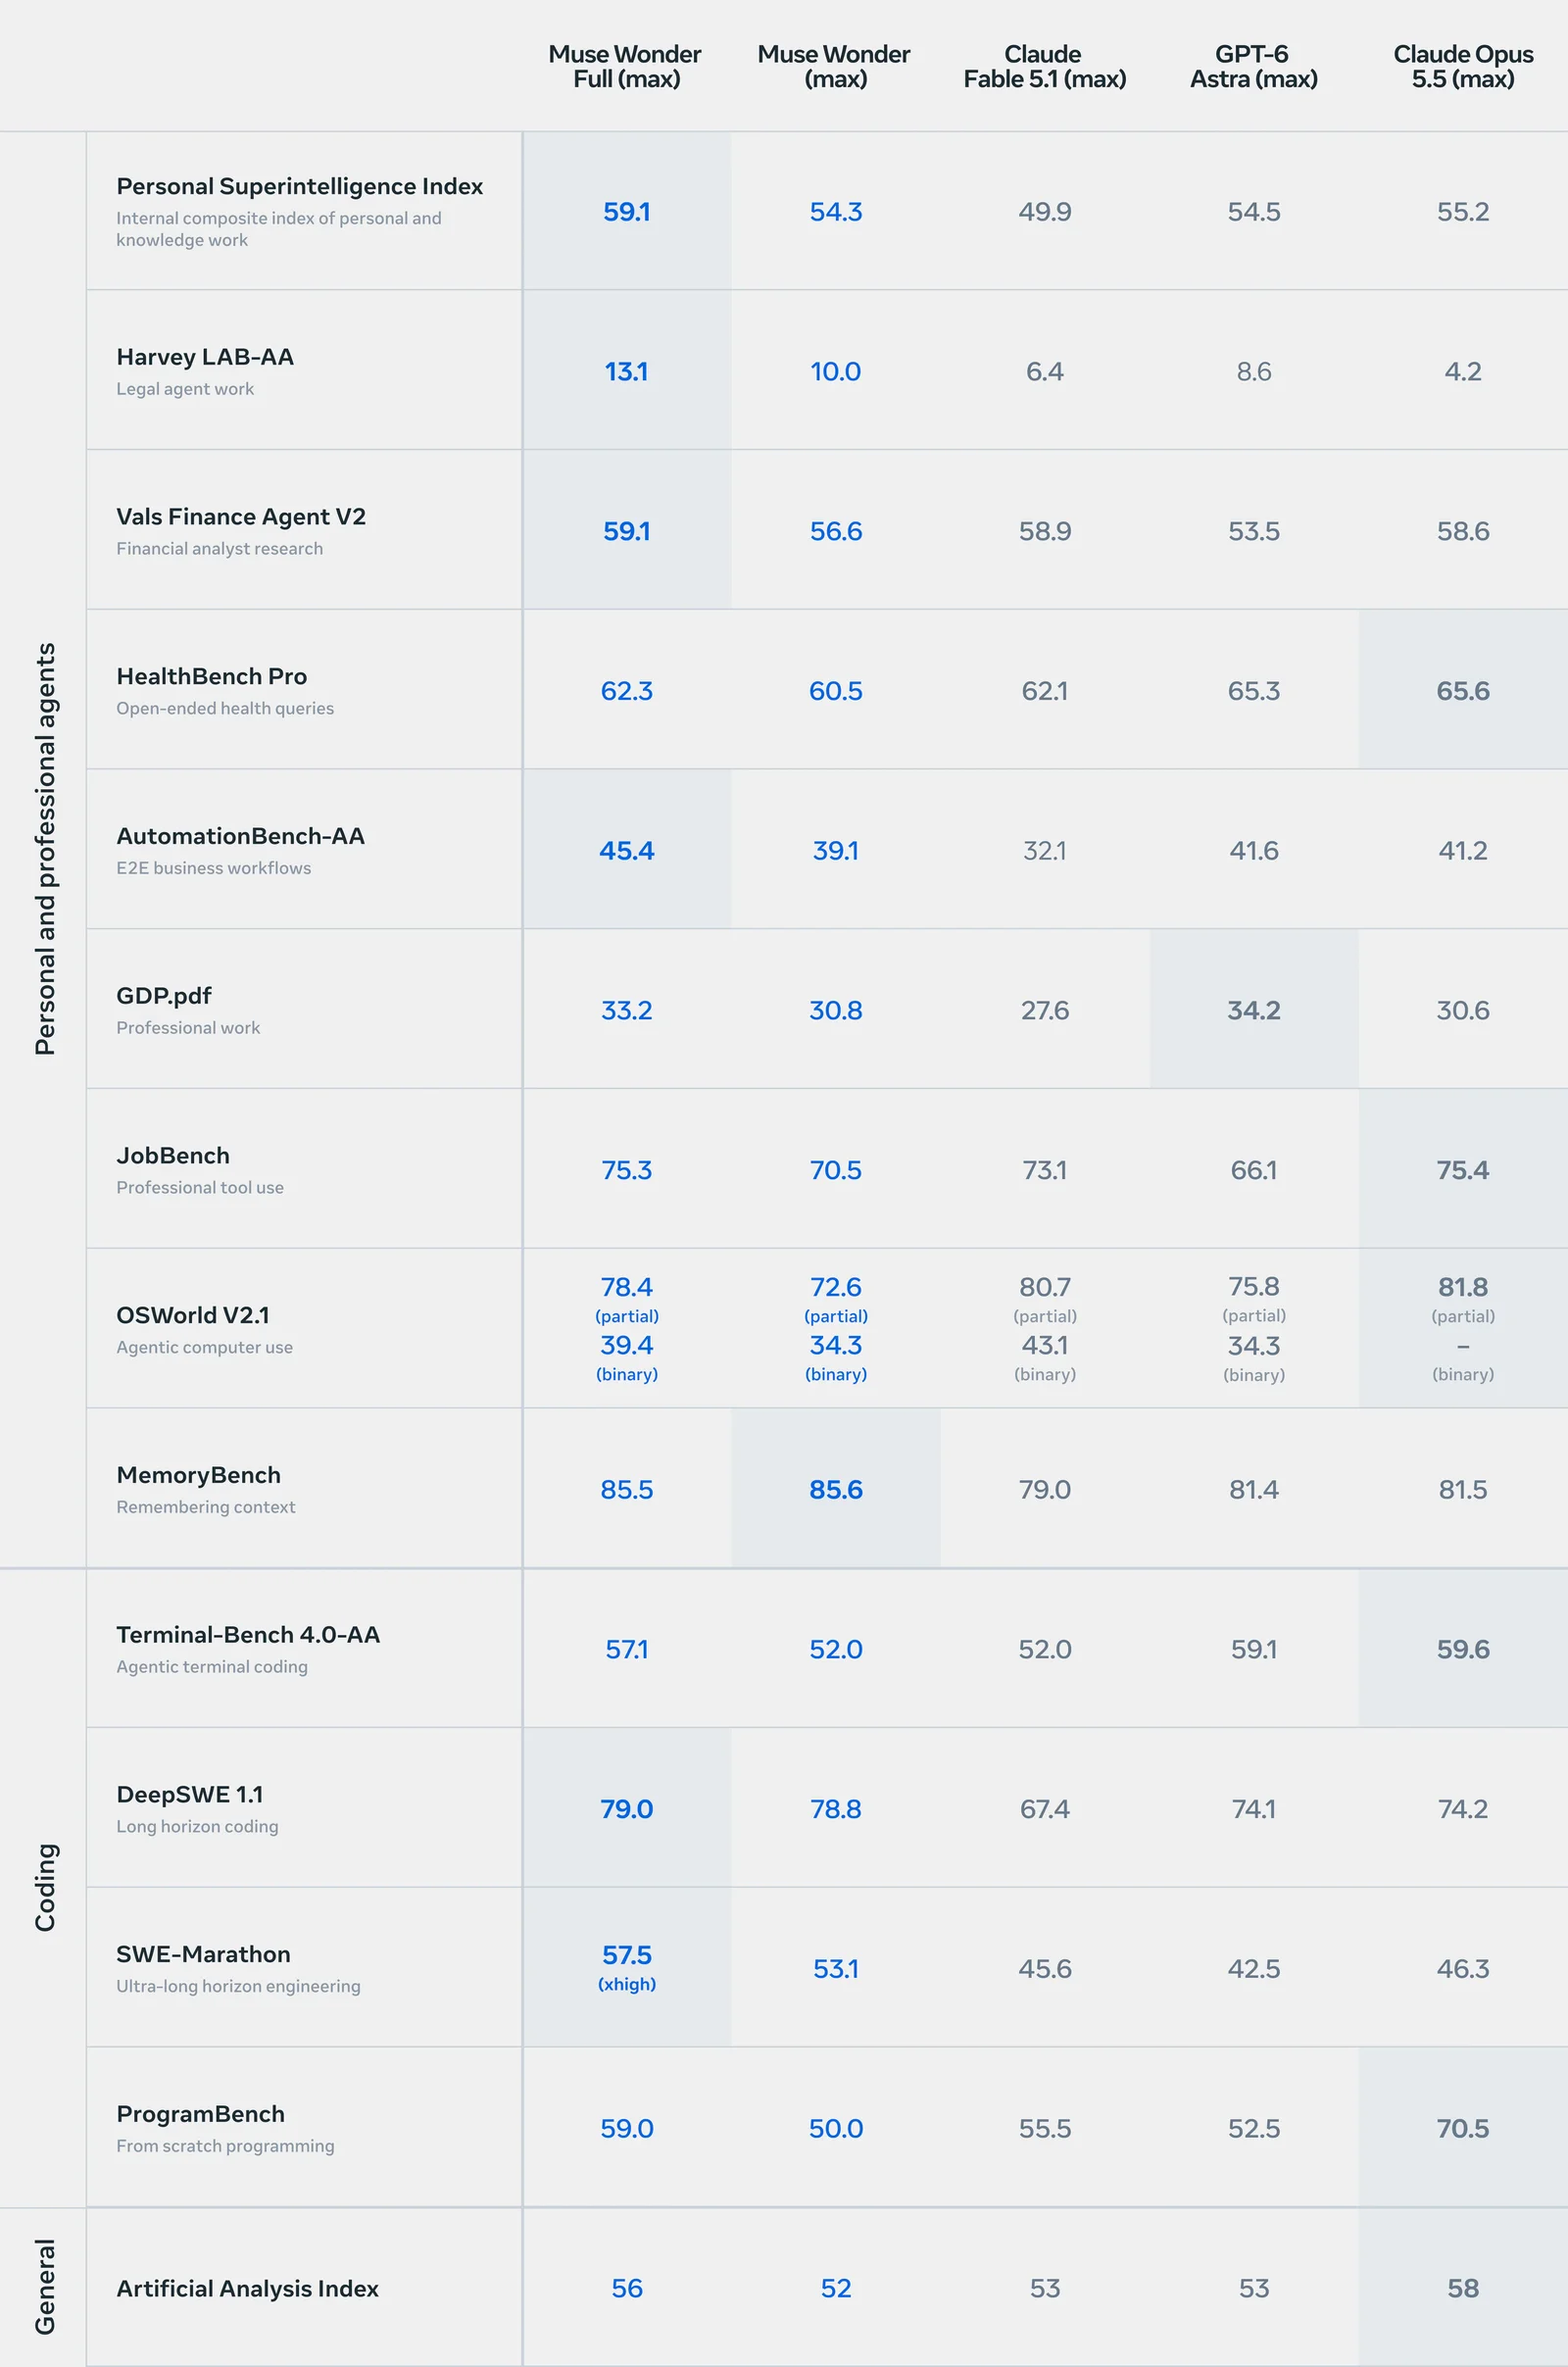
跑分就是讓模型完成一組任務,再依各測試的規則打分數。這張表大多標示為 max 力度,但 SWE-Marathon 的 Full 用的是 xhigh;不同模型即使使用同名設定,也不代表花費相同時間或運算量。除了分數,還要看誰出的題、誰來跑,以及比較條件是否一致。
第三方執行的評測包括 Harvey LAB-AA、AutomationBench-AA 與 Vals Finance Agent V2。依 Meta 公布的表,Harvey LAB-AA v1.1 的 Full 是 13.1、Opus 5.5 是 4.2,完整通過且沒有重大幻覺的比例仍低。AutomationBench-AA 的 Full 是 45.4、GPT-6 Astra 是 41.6;model card 說這裡採嚴格的整項任務通過率,與 AA 網站另列的目標完成分數不同。Vals Finance Agent V2 由 Vals AI 執行,Full 59.1、Fable 5.1 58.9,差距很小。這些比較限於表內所列模型,不代表完整排行榜第一。
另一類要分清楚內部評測與比較條件。Personal Superintelligence Index 是 Meta 的內部綜合指數,由 7 項測試組成,model card 沒有揭露計算公式;MemoryBench 與 FocusBench 也是 Meta 內部測試。DeepSWE 1.1 混合 Datacurve 的第三方結果與廠商自報分數。SWE-Marathon 的結果來自 Abundant AI,但對手使用不同的 agent,Full 也用 xhigh,不能當成同一套執行環境的比較。Meta 另提醒,它自行執行的對手測試只是盡力比較,提示詞、工具與執行環境未必調到最好。
在 Meta 這張表中,Opus 5.5 領先 HealthBench Pro、Terminal-Bench 4.0-AA 與 OSWorld V2.1 的 partial 分數(81.8);JobBench 的 75.4 與 Full 的 75.3 很接近,GPT-6 Astra 則領先 GDP.pdf(34.2)。ProgramBench 的表內模型都用 mini-swe-agent,Opus 5.5 是 70.5、Full 是 59.0;這裡算的是通過至少 95% 測試的執行比例,不是完全重建成功率。這項測試由 Meta 與學術團隊共同建置。Terminal-Bench 4.0-AA 也採用 mini-swe-agent。
如果只想看一個數字,可以先看 Artificial Analysis 的綜合指數,它由 10 項測試組成,所有模型由同一家第三方統一評測(Meta 引用、標註日期為 2026-10-12,分數是指數點數,不是百分比):
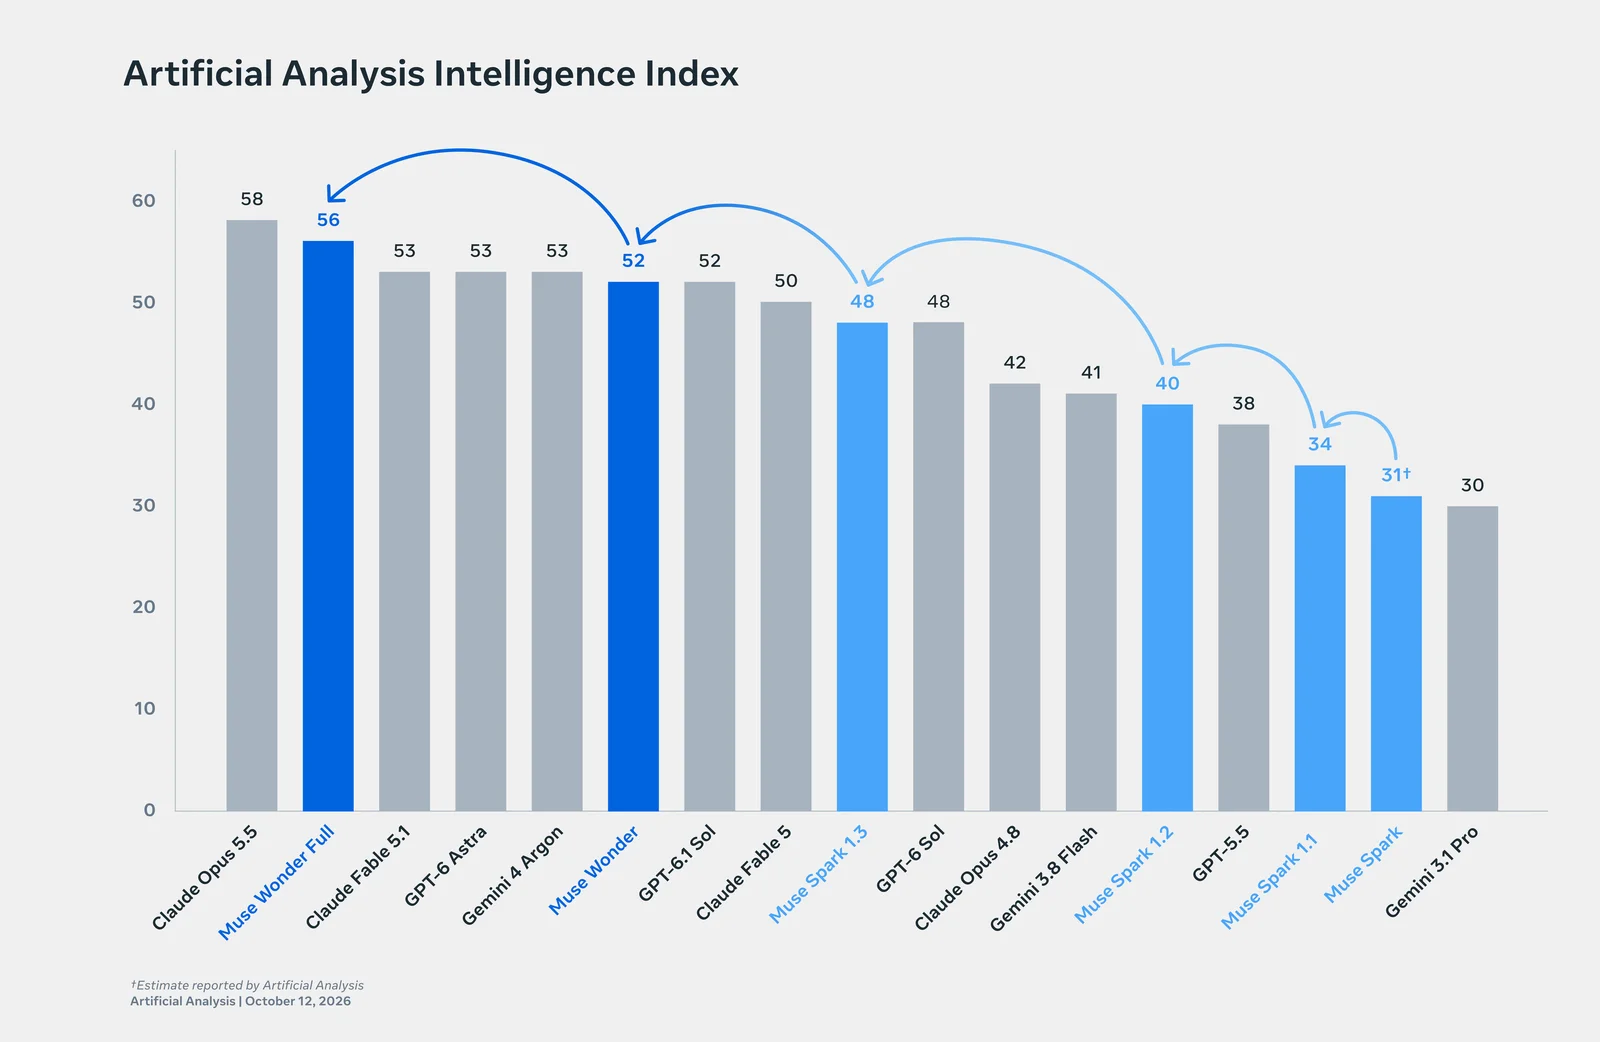
在 Meta 這張 10 月 12 日的圖中,Full 是 56,低於 Opus 5.5 的 58。圖中的 Fable 5.1、GPT-6 Astra 與 Gemini 4 Argon 都是 53,比 Muse Wonder 高 1 點。API 版 Muse Wonder 是 52,基本 token 單價跟 Opus 5.5 一樣,指數低 6 點。這是圖中所列模型的比較,不代表目前完整排行榜的名次。
截至 2026 年 10 月 13 日,Artificial Analysis 已公布 Muse Wonder 與 Full 的評測頁,分數同樣是 52 與 56,Full 在 AA 完整排行中列第 4;Vals 的 Finance Agent V2 也已列出兩款模型。上面的圖仍是 Meta 在 10 月 12 日公布的快照,不能當成第三方網站的最新完整排名。
價格與怎麼用
| API,每百萬 token | 輸入 | 輸出 | 快取輸入 |
|---|---|---|---|
Muse Wonder(muse-wonder-1.0) | 4 美元 | 20 美元 | 0.20 美元 |
| Claude Opus 5.5 | 4 美元 | 20 美元 | 0.20 美元 |
輸入、輸出各 100 萬 token,兩邊都是 24 美元。Muse Wonder 的 web search grounding 另收每 1,000 次查詢 2.50 美元,OpenRouter 也有上架(meta/muse-wonder),價格相同。官方文件另外寫明,長 context 沒有加價,reasoning tokens 跟輸出 token 同價,所以把力度調到 max 會用掉更多 token,帳單也會跟著變高。
Muse Code 是 Meta 在終端機與 CI 執行的 coding agent,能規劃、修改程式並執行指令。訂閱分四個方案,皆為每月:
| 方案 | 月費 | 可用 Muse Wonder Full |
|---|---|---|
| Everyday Usage | 5 美元 | 否 |
| High Usage | 15 美元 | 否 |
| Power Usage | 50 美元 | 是 |
| Maximum Usage | 200 美元 | 是 |
兩件事要先知道:
- Contributor mode:Muse Code 訂閱預設開啟 Contributor mode,提供較多用量,代價是允許 Meta 用你送出的提示詞、程式碼、檔案、上下文與模型回覆訓練未來模型。可在設定中關閉,關閉後的新內容不會用來訓練。Muse Wonder 的 API 只有 Standard mode,內容不會用來訓練 Meta 模型。
- 台灣:Meta 沒有公布逐國名單,只說 API 開放在「多數有 Meta AI 且支援付款的國家與地區」。台灣沒有被列為可用,也不在限制名單上(中國含港澳在內),所以不能說一定能用,請在註冊時確認。
Active Memory 與 Active Focus
這是 Meta 主打的兩個功能。Active Memory 是跨對話記住重要資訊,需要時主動取回跟當前任務有關的細節。Active Focus 是遇到困難時換方法繼續做,必要時會提問,重要動作前先跟你確認。Meta 用 MemoryBench 與 FocusBench 來呈現這兩項能力,兩者都是 Meta 內部測試。這些都是 Meta 自己的說法與測試,目前沒有獨立測試驗證,實際用起來是否如宣傳,要等使用者的回報。
安全與開源
根據 model card,在沒有防護措施的情況下,Meta 無法排除 Full 在化學與生物領域達到 high 風險門檻;網路安全與失控風險則是 moderate 或以下。加上防護後,所有領域都在 moderate 或以下,Meta 據此決定上線。Meta 另外說,模型具備防止在未經許可下分享私人資訊的防護,並會抵抗惡意指令。另一份完整安全報告,Meta 說「available soon」,截至 10 月 13 日還沒有看到。
Muse Wonder 系列是否會開放權重,Meta 尚未公布。在 Meta Model API 這份模型總覽中,開放權重的模型是 Muse Glimmer(30B)。Axios 報導,Meta Superintelligence Labs 負責人 Alexandr Wang 仍表示會持續支持開源。
小企鵝的總結
AA 的綜合指數顯示,Muse Wonder 系列已接近前段模型,但 Full 的 56 仍低於 Opus 5.5 的 58。Meta 發表表格中,Full 在法律與自動化測試高於所列對手;這不代表完整排行榜第一,也不能直接套用到 API 版 Muse Wonder。各項測試的來源與比較條件仍要分開看。
對 API 使用者來說,Muse Wonder 的基本 token 單價與 Opus 5.5 相同,AA 指數是 52 對 58;Full 的領先成績不能直接套用到 API 版。可以先參考 AA 與 Vals 已公布的評測,再用自己的工作流程小量測試;單價相同,也不代表完成同一個任務的總費用相同。要在 Muse Code 使用 Full,可選 Power(每月 50 美元)或 Maximum(每月 200 美元)方案,使用前先確認 Contributor mode 的設定。
延伸閱讀
封面圖片來源:Meta(research.meta.ai/blog/muse-wonder)
本文為 AI 工具功能介紹及訂閱方案消費比較,不涉及證券或投資建議。實際定價以各平台官方最新公告為準,本文資訊可能已過時(資料截至 2026 年 10 月 13 日)。