一句话重点
Meta Superintelligence Labs 在 2026 年 10 月 12 日(美国时间)发布 Muse Wonder 系列,包含两款模型:Muse Wonder 可通过 API 与 Muse Code 使用,能力更强的 Muse Wonder Full 只开放给 Muse Code 订阅用户。Meta 称两款在个人与专业 agent 任务上达到 state-of-the-art;Meta 在 10 月 12 日引用的 Artificial Analysis 图表中,Full 是 56,低于 Claude Opus 5.5 的 58,而 Muse Wonder 的 API 价格跟 Opus 5.5 一样。 这里的 Muse Wonder 是模型,不是 Muse app,app 的功能与使用限制请看 Meta Muse 是什么。 Meta 说,这是它在 14 个月前开始重建 AI 之后的成果,重点放在法律、金融、健康等专业工作,以及长时间自主完成任务的 agent。这些是 Meta 自己的说法。
Muse Wonder 跟 Muse Wonder Full 有什么区别
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| model ID | muse-wonder-1.0 | muse-wonder-full-1.0 |
| 怎么用 | Meta Model API、Muse Code | 只有 Muse Code 的 Power、Maximum 方案 |
| 价格 | API 输入 4 美元/输出 20 美元(每百万 token) | 无 API 价格,订阅制 |
| AA 综合指数 | 52 | 56 |
| context | 1M tokens | 1M tokens |
Muse app 方面,Meta 说 Wonder “soon” 会用在 Muse 上,订阅用户优先,没有给出日期。把 reasoning effort 设成 max,也不会切换成 Full,它们是两个不同的模型。Muse Wonder 目前仍标示为 preview,输入可以是文字、图片、视频、音频与 PDF,输出是文字。
跑分怎么看
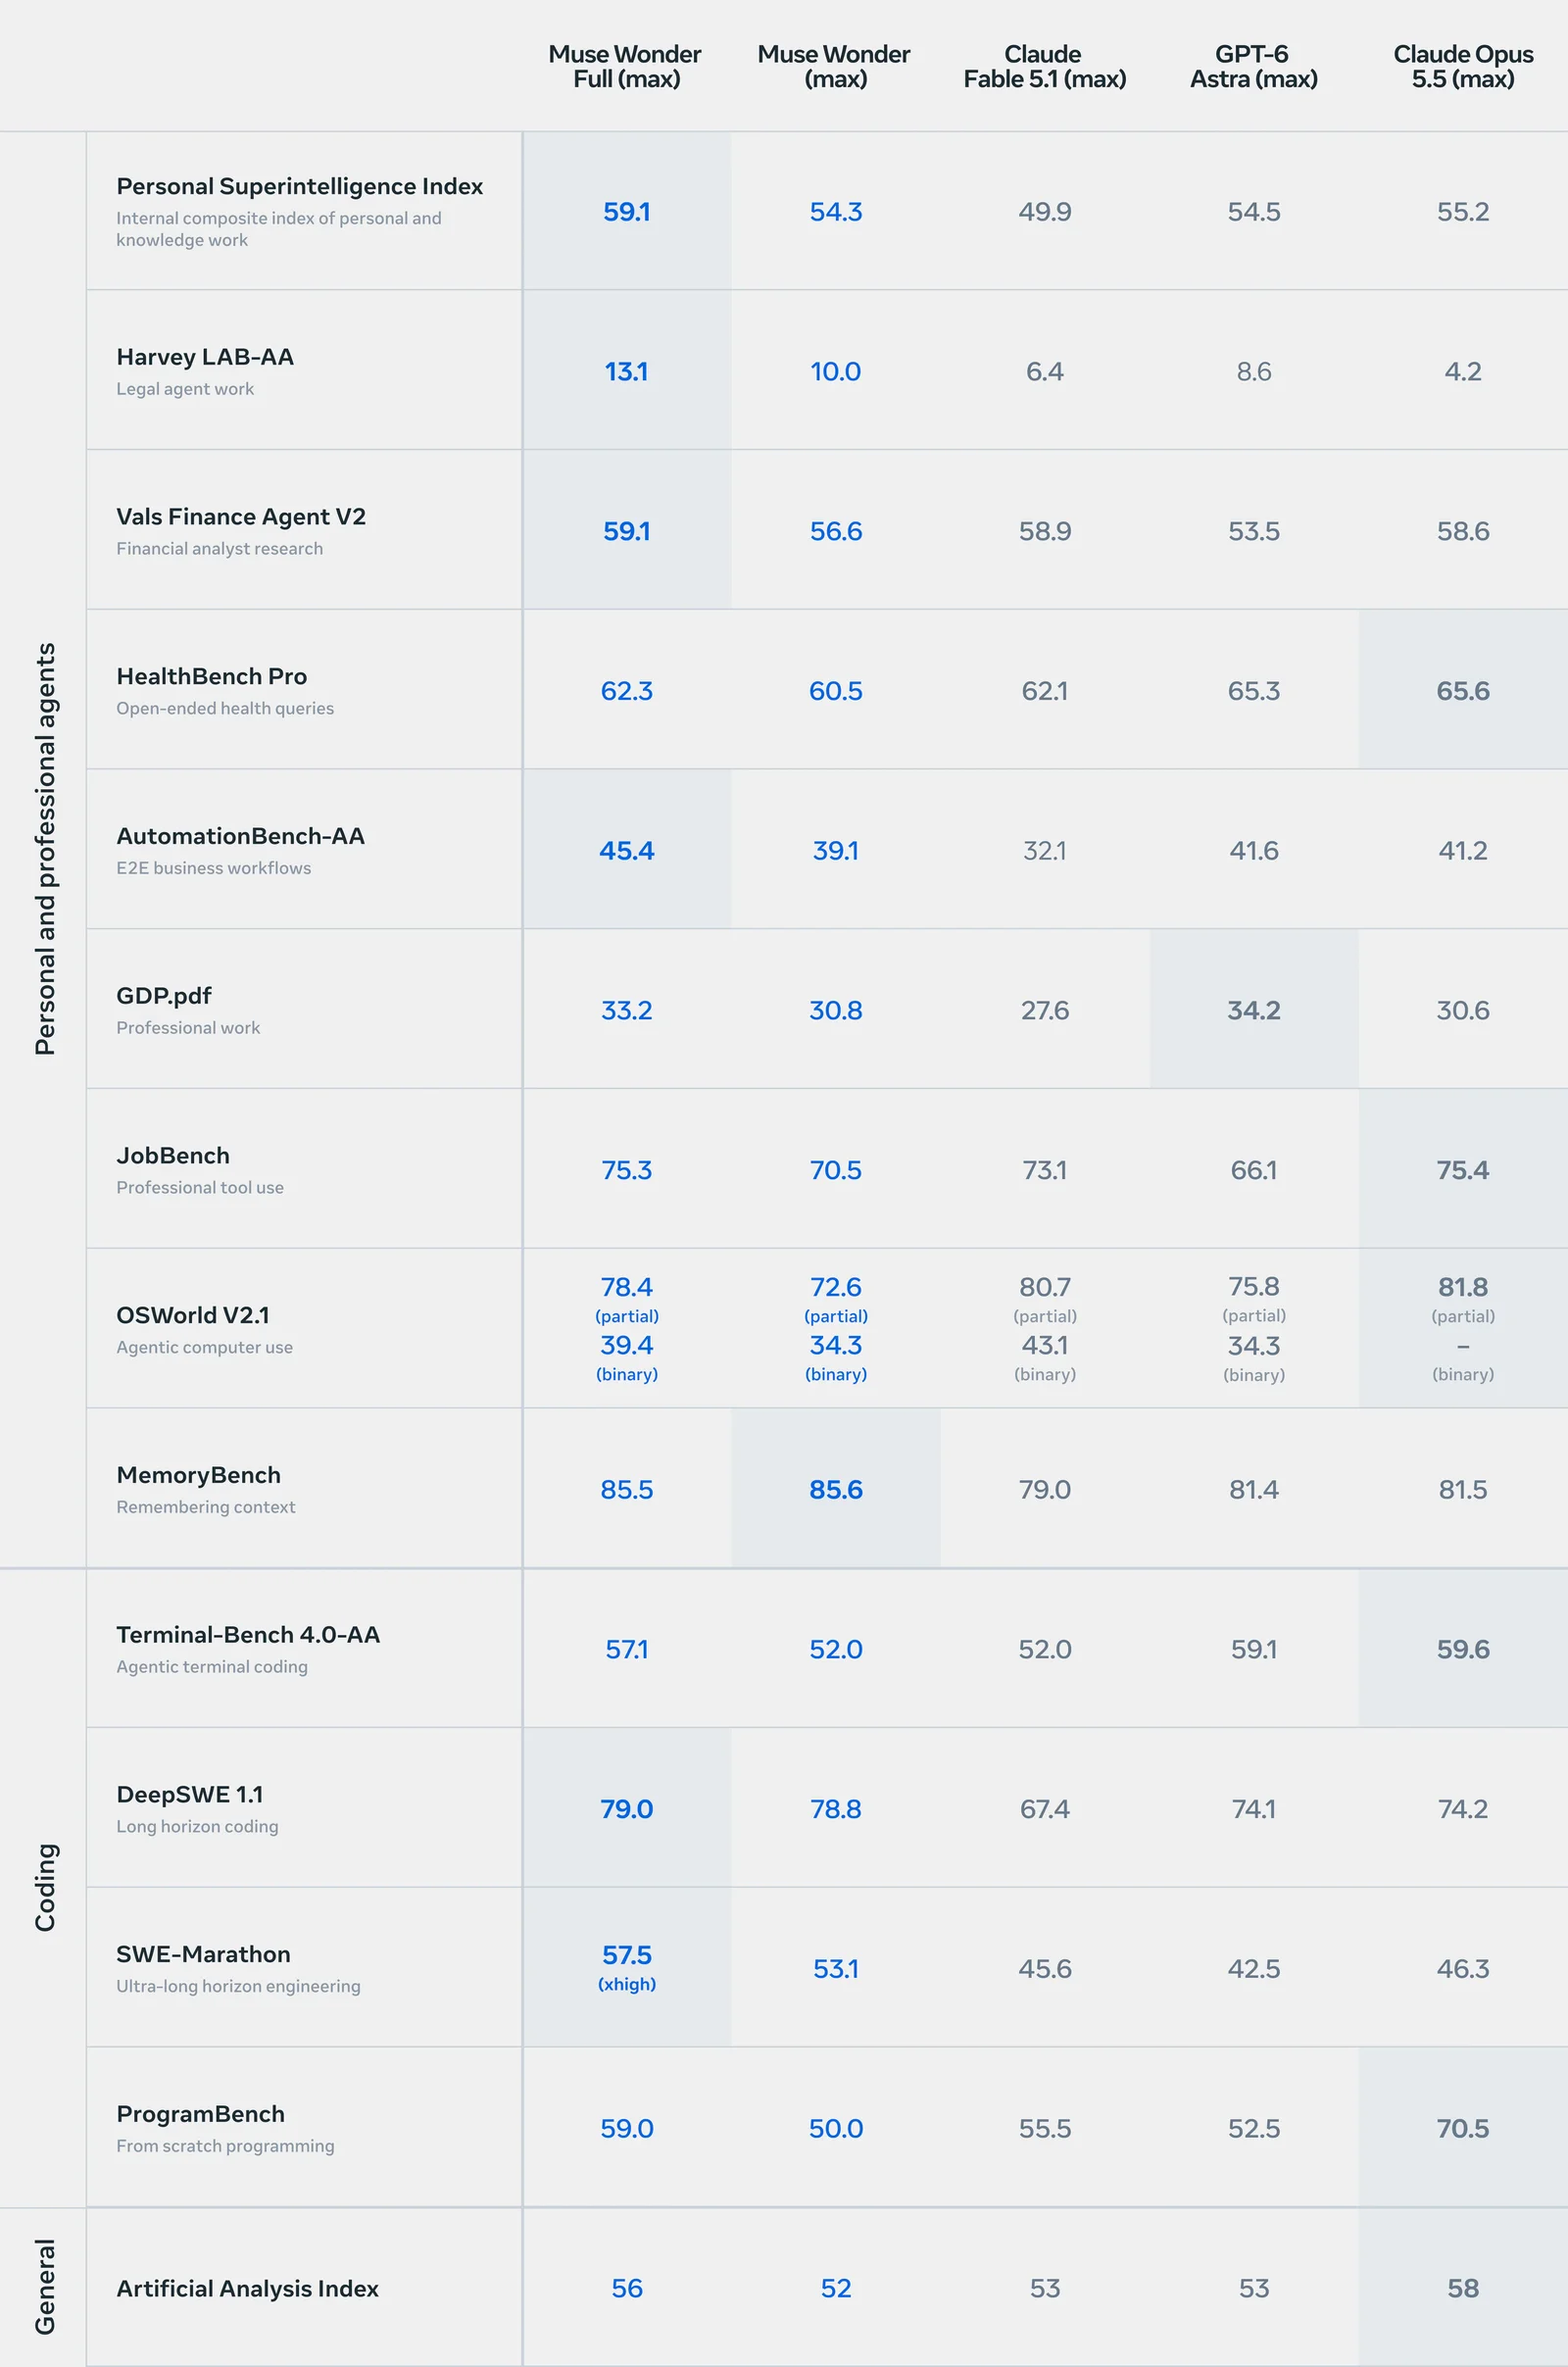
跑分就是让模型完成一组任务,再按各测试的规则打分。这张表大多标示为 max 力度,但 SWE-Marathon 的 Full 用的是 xhigh;不同模型即使使用同名设置,也不代表花费相同的时间或算力。除了分数,还要看谁出的题、谁来跑,以及比较条件是否一致。
由第三方执行的评测包括 Harvey LAB-AA、AutomationBench-AA 与 Vals Finance Agent V2。根据 Meta 公布的表,Harvey LAB-AA v1.1 的 Full 是 13.1、Opus 5.5 是 4.2,完全通过且没有严重幻觉的比例仍然偏低。AutomationBench-AA 的 Full 是 45.4、GPT-6 Astra 是 41.6;model card 说这里采用严格的整项任务通过率,与 AA 网站另外列出的目标完成分数不同。Vals Finance Agent V2 由 Vals AI 执行,Full 59.1、Fable 5.1 58.9,差距很小。这些比较仅限于表内所列模型,不代表完整排行榜第一。
另一类要分清楚内部评测与比较条件。Personal Superintelligence Index 是 Meta 的内部综合指数,由 7 项测试组成,model card 没有披露计算公式;MemoryBench 与 FocusBench 也是 Meta 内部测试。DeepSWE 1.1 混合了 Datacurve 的第三方结果与厂商自报分数。SWE-Marathon 的结果来自 Abundant AI,但对手使用不同的 agent,Full 也用了 xhigh,不能当成同一套运行环境下的比较。Meta 另外提醒,它自行运行的对手测试只是尽力比较,提示词、工具与运行环境未必调到最好。
在 Meta 这张表中,Opus 5.5 领先 HealthBench Pro、Terminal-Bench 4.0-AA 与 OSWorld V2.1 的 partial 分数(81.8);JobBench 的 75.4 与 Full 的 75.3 很接近,GPT-6 Astra 则领先 GDP.pdf(34.2)。ProgramBench 的表内模型都用 mini-swe-agent,Opus 5.5 是 70.5、Full 是 59.0;这里算的是通过至少 95% 测试的运行比例,不是完全重建的成功率。这项测试由 Meta 与学术团队共同搭建。Terminal-Bench 4.0-AA 也采用 mini-swe-agent。
如果只想看一个数字,可以先看 Artificial Analysis 的综合指数,它由 10 项测试组成,所有模型由同一家第三方统一评测(Meta 引用、标注日期为 2026-10-12,分数是指数点数,不是百分比):
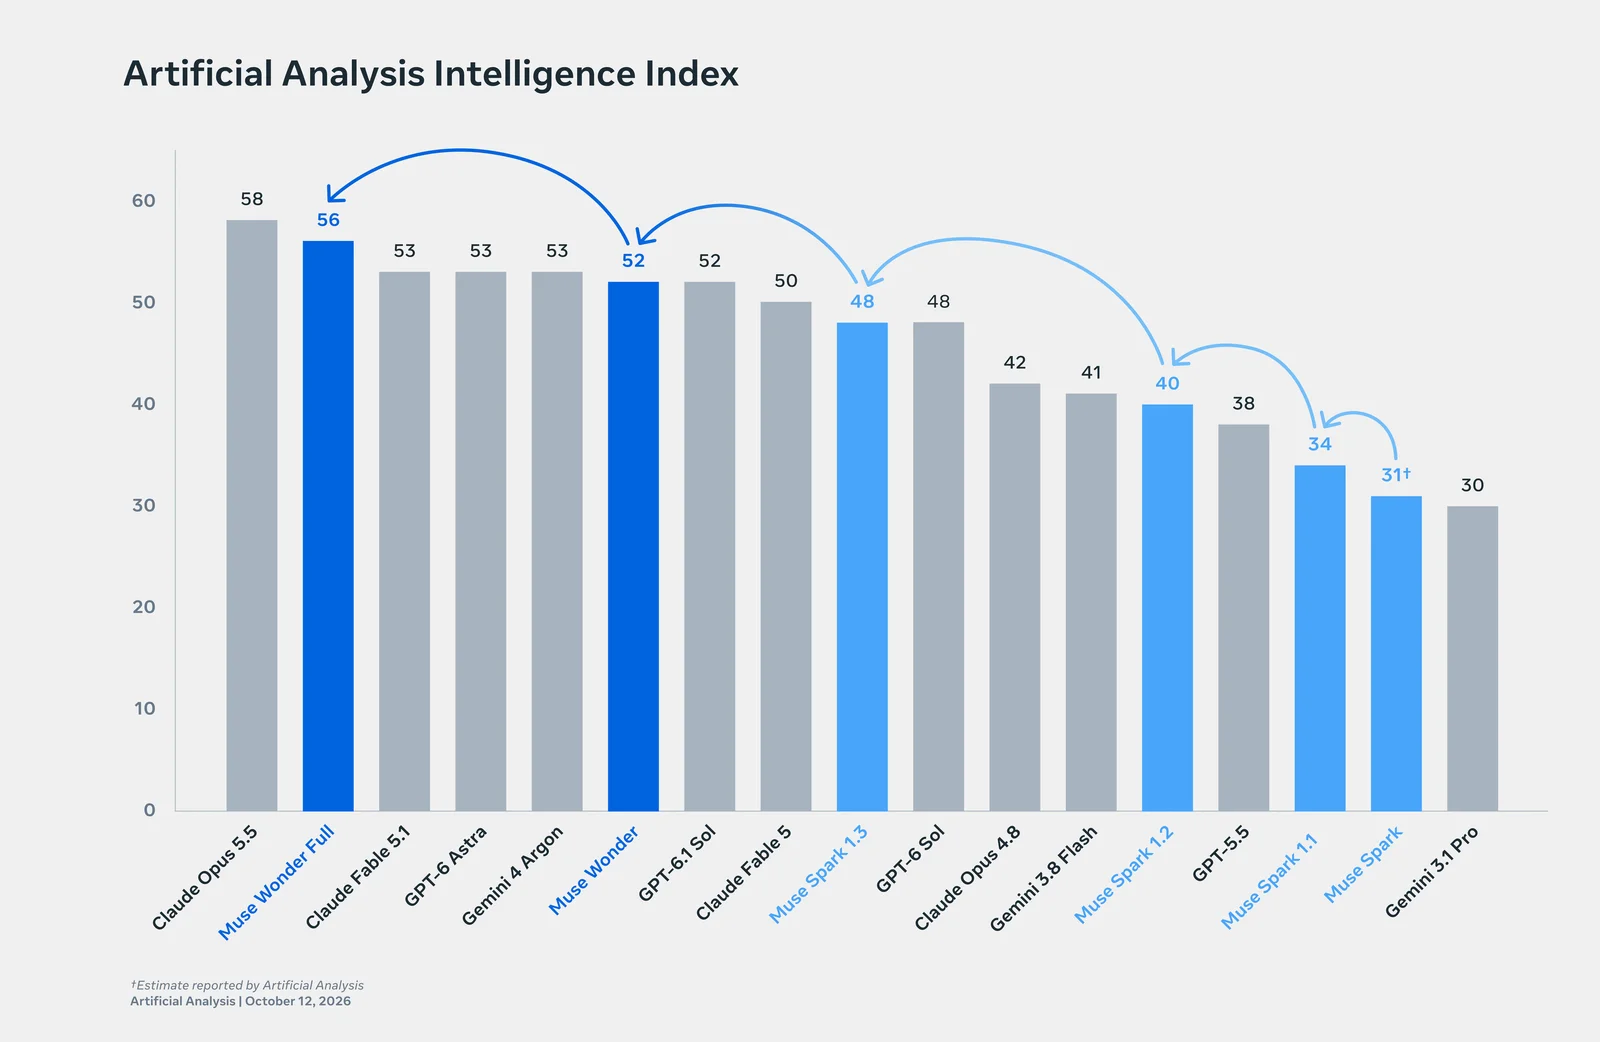
在 Meta 这张 10 月 12 日的图中,Full 是 56,低于 Opus 5.5 的 58。图中的 Fable 5.1、GPT-6 Astra 与 Gemini 4 Argon 都是 53,比 Muse Wonder 高 1 点。API 版 Muse Wonder 是 52,基本 token 单价跟 Opus 5.5 一样,指数低 6 点。这是图中所列模型的比较,不代表目前完整排行榜的名次。
截至 2026 年 10 月 13 日,Artificial Analysis 已公布 Muse Wonder 与 Full 的评测页面,分数同样是 52 与 56,Full 在 AA 完整排行中列第 4;Vals 的 Finance Agent V2 也已列出两款模型。上面的图仍是 Meta 在 10 月 12 日公布的快照,不能当成第三方网站的最新完整排名。
价格与使用方式
| API,每百万 token | 输入 | 输出 | 缓存输入 |
|---|---|---|---|
Muse Wonder(muse-wonder-1.0) | 4 美元 | 20 美元 | 0.20 美元 |
| Claude Opus 5.5 | 4 美元 | 20 美元 | 0.20 美元 |
输入、输出各 100 万 token,两边都是 24 美元。Muse Wonder 的 web search grounding 另收每 1,000 次查询 2.50 美元,OpenRouter 也已上架(meta/muse-wonder),价格相同。官方文档另外写明,长 context 不加价,reasoning tokens 跟输出 token 同价,所以把力度调到 max 会用掉更多 token,账单也会跟着变高。
Muse Code 是 Meta 在终端与 CI 中运行的 coding agent,能规划、修改代码并执行命令。订阅分四个方案,均为每月:
| 方案 | 月费 | 可用 Muse Wonder Full |
|---|---|---|
| Everyday Usage | 5 美元 | 否 |
| High Usage | 15 美元 | 否 |
| Power Usage | 50 美元 | 是 |
| Maximum Usage | 200 美元 | 是 |
有两件事要先知道:
- Contributor mode:Muse Code 订阅默认开启 Contributor mode,提供更多用量,代价是允许 Meta 用你发送的提示词、代码、文件、上下文与模型回复训练未来的模型。可以在设置中关闭,关闭后的新内容不会用于训练。Muse Wonder 的 API 只有 Standard mode,内容不会用于训练 Meta 的模型。
- 台湾:Meta 没有公布逐个国家的名单,只说 API 开放在“多数有 Meta AI 且支持付款的国家和地区”。台湾没有被列为可用,也不在限制名单上(中国含港澳在内),所以不能说一定能用,请在注册时确认。
Active Memory 与 Active Focus
这是 Meta 主打的两个功能。Active Memory 是跨对话记住重要信息,需要时主动调取跟当前任务有关的细节。Active Focus 是遇到困难时换方法继续做,必要时会提问,重要操作前先跟你确认。Meta 用 MemoryBench 与 FocusBench 来展示这两项能力,两者都是 Meta 内部测试。这些都是 Meta 自己的说法与测试,目前没有独立测试验证,实际用起来是否如宣传所说,要等用户的反馈。
安全与开源
根据 model card,在没有防护措施的情况下,Meta 无法排除 Full 在化学与生物领域达到 high 风险门槛;网络安全与失控风险则是 moderate 或以下。加上防护后,所有领域都在 moderate 或以下,Meta 据此决定上线。Meta 另外说,模型具备防止在未经许可的情况下分享私人信息的防护,并会抵抗恶意指令。另一份完整安全报告,Meta 说“available soon”,截至 10 月 13 日还没有看到。
Muse Wonder 系列是否会开放权重,Meta 尚未公布。在 Meta Model API 这份模型总览中,开放权重的模型是 Muse Glimmer(30B)。Axios 报道,Meta Superintelligence Labs 负责人 Alexandr Wang 仍表示会继续支持开源。
小企鹅的总结
AA 的综合指数显示,Muse Wonder 系列已接近领先的模型,但 Full 的 56 仍低于 Opus 5.5 的 58。Meta 发布的表格中,Full 在法律与自动化测试高于所列对手;这不代表完整排行榜第一,也不能直接套用到 API 版 Muse Wonder。各项测试的来源与比较条件仍要分开看。
对 API 用户来说,Muse Wonder 的基本 token 单价与 Opus 5.5 相同,AA 指数是 52 对 58;Full 的领先成绩不能直接套用到 API 版。可以先参考 AA 与 Vals 已公布的评测,再用自己的工作流程小规模测试;单价相同,也不代表完成同一个任务的总费用相同。要在 Muse Code 使用 Full,可选 Power(每月 50 美元)或 Maximum(每月 200 美元)方案,使用前先确认 Contributor mode 的设置。
延伸阅读
封面图片来源:Meta(research.meta.ai/blog/muse-wonder)
本文为 AI 工具功能介绍及订阅方案消费比较,不涉及证券或投资建议。实际定价以各平台官方最新公告为准,本文信息可能已过时(数据截至 2026 年 10 月 13 日)。