一句話重點
Google 在 2026 年 10 月 28 日(台北時間 10 月 29 日凌晨 1 點)發表 Gemini 4 Carbon,官方稱它是「我們最強的模型」,主打資安和長時間任務,並表示內部團隊曾讓它持續跑數天,處理複雜的多步驟工程任務。它在 Artificial Analysis Intelligence Index v5 拿到 59 分,排 52 個模型的第一,但 Google 只先開放給一部分資安防禦人員,截至 2026 年 10 月 29 日,一般使用者和開發者都還用不到。 Carbon 的上一個模型是兩週前開放的 Gemini 4 Argon。
誰能用 Gemini 4 Carbon
Google 說本週起先開放給一部分資安防禦人員,再透過 Fairwind Program 逐步擴大到更多受信任的合作夥伴。開發者、企業和一般使用者,Google 只寫了「盡快」,還沒給日期。Ars Technica 的標題更直接,叫它「你用不到的最新前沿模型」。
截至 2026 年 10 月 29 日,Carbon 還沒開放給大眾,公開的 Gemini API 模型清單還沒有列出 Carbon。
Fairwind Program 的優先對象有三類:
- 政府和國家級資安單位
- 關鍵基礎設施營運者:醫療、電信、能源、金融
- 核心科技平台
申請者要填表單,並通過背景審查。
跑分怎麼看
跑分就是讓不同模型做同一組任務再打分數。下面這張是 Google 公告裡的完整對照表,把 Carbon 跟 Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1 放在一起比。
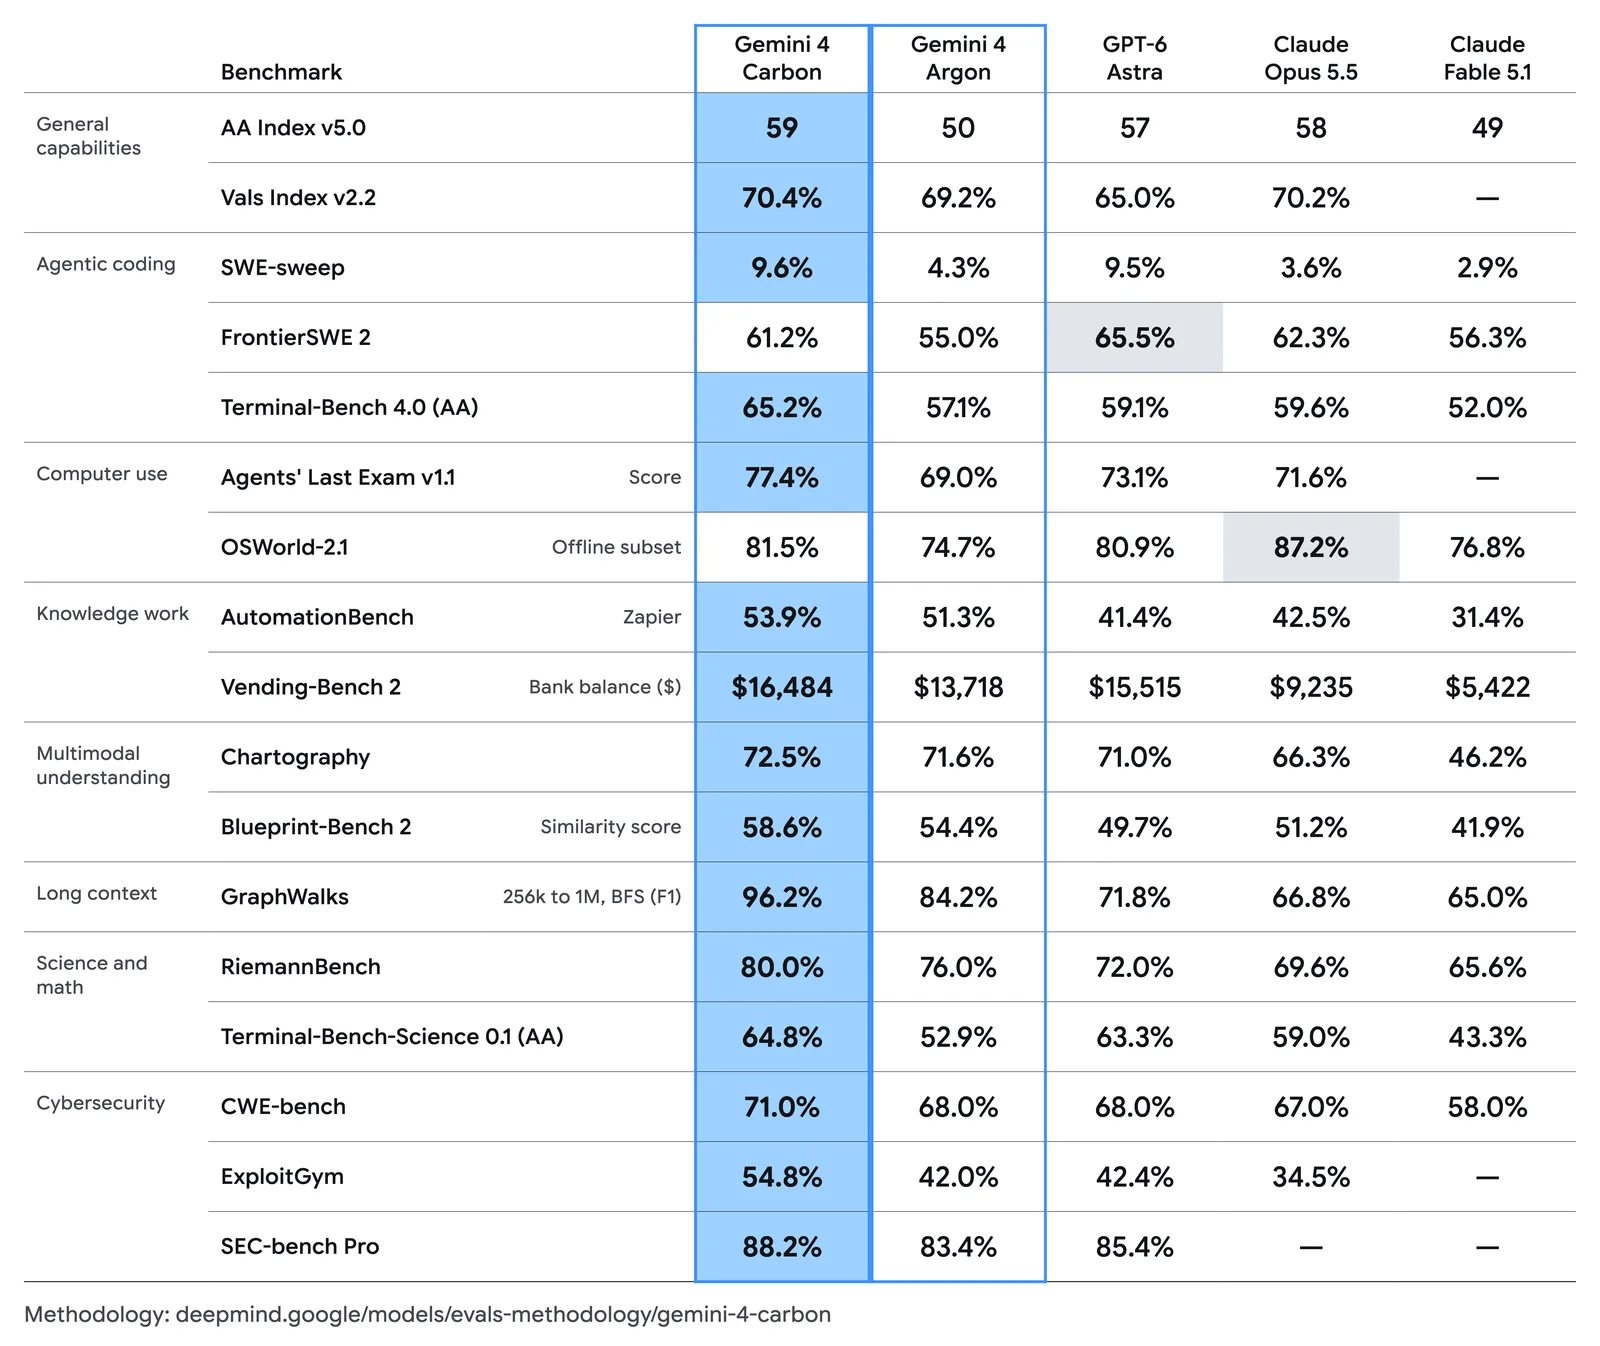
在 Google 這張表列出的模型裡,17 項有 15 項分數最高。 輸的兩項是:
- FrontierSWE 2(軟體工程測試):Carbon 61.2%,GPT-6 Astra 65.5%,Claude Opus 5.5 62.3%。
- OSWorld-2.1(測試 AI 操作桌面軟體,只取其中 82 題不需上網的任務):Carbon 81.5%,落後 Claude Opus 5.5 的 87.2%,差 5.7 個百分點。
贏的幅度差很多。Intelligence Index 是 59 對 58,只差 1 分。SWE-sweep(讓 AI 自己找出並修正程式錯誤的測試)差 0.1 個百分點,Vals Index(綜合金融、程式、法律和稅務任務表現的指數)差 0.2 個百分點,幾乎打平。再看幾項差距比較大的:
- GraphWalks(把圖的節點和連線寫成一大段文字,要模型沿著連線找出指定節點,題目長 25.6 萬到 100 萬 token):Carbon 的 F1 分數是 96.2%,Argon 84.2%,GPT-6 Astra 71.8%。
- AutomationBench(Zapier 的自動化流程測試,用的是非公開題目):Carbon 53.9%,Argon 51.3%,Claude Opus 5.5 42.5%,GPT-6 Astra 41.4%。Carbon 比 Argon 高 2.6 個百分點,比 Opus 5.5 高 11.4 個百分點。
- Terminal-Bench 4.0(指令列寫程式,Artificial Analysis 版):Carbon 65.2%,Claude Opus 5.5 59.6%,GPT-6 Astra 59.1%。
看這張表要記兩件事。對手的數字多半是各家自己發表的成績,由 Google 挑來放進表裡。Carbon 和 Argon 則是用最高的思考設定跑的。GPT-6.1 Sol 和 Terra 沒有放進主表,只出現在資安圖表。
資安三項
Google 把資安列為 Carbon 的主打。以下數字是在沒有啟用防護機制的情況下測的。
SEC-bench Pro(183 題 JavaScript 引擎的資安任務,看第一次嘗試就過關的比例):
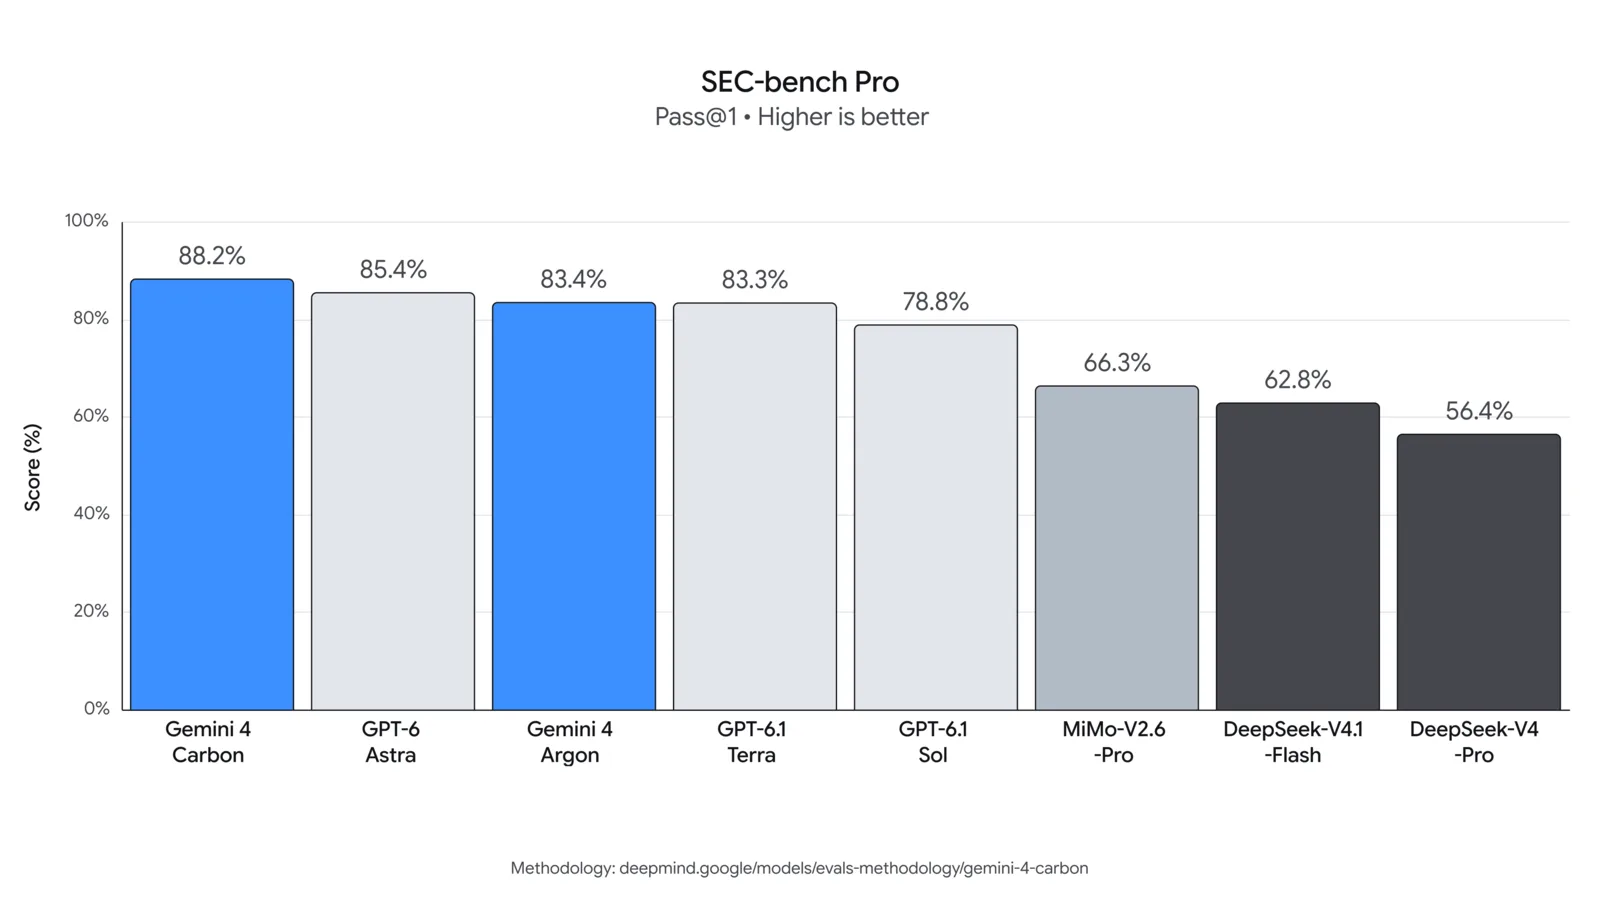
Carbon 的成功率是 88.2%,比 GPT-6 Astra 的 85.4% 高 2.8 個百分點。
ExploitGym(漏洞利用測試,系統層級防護關閉):
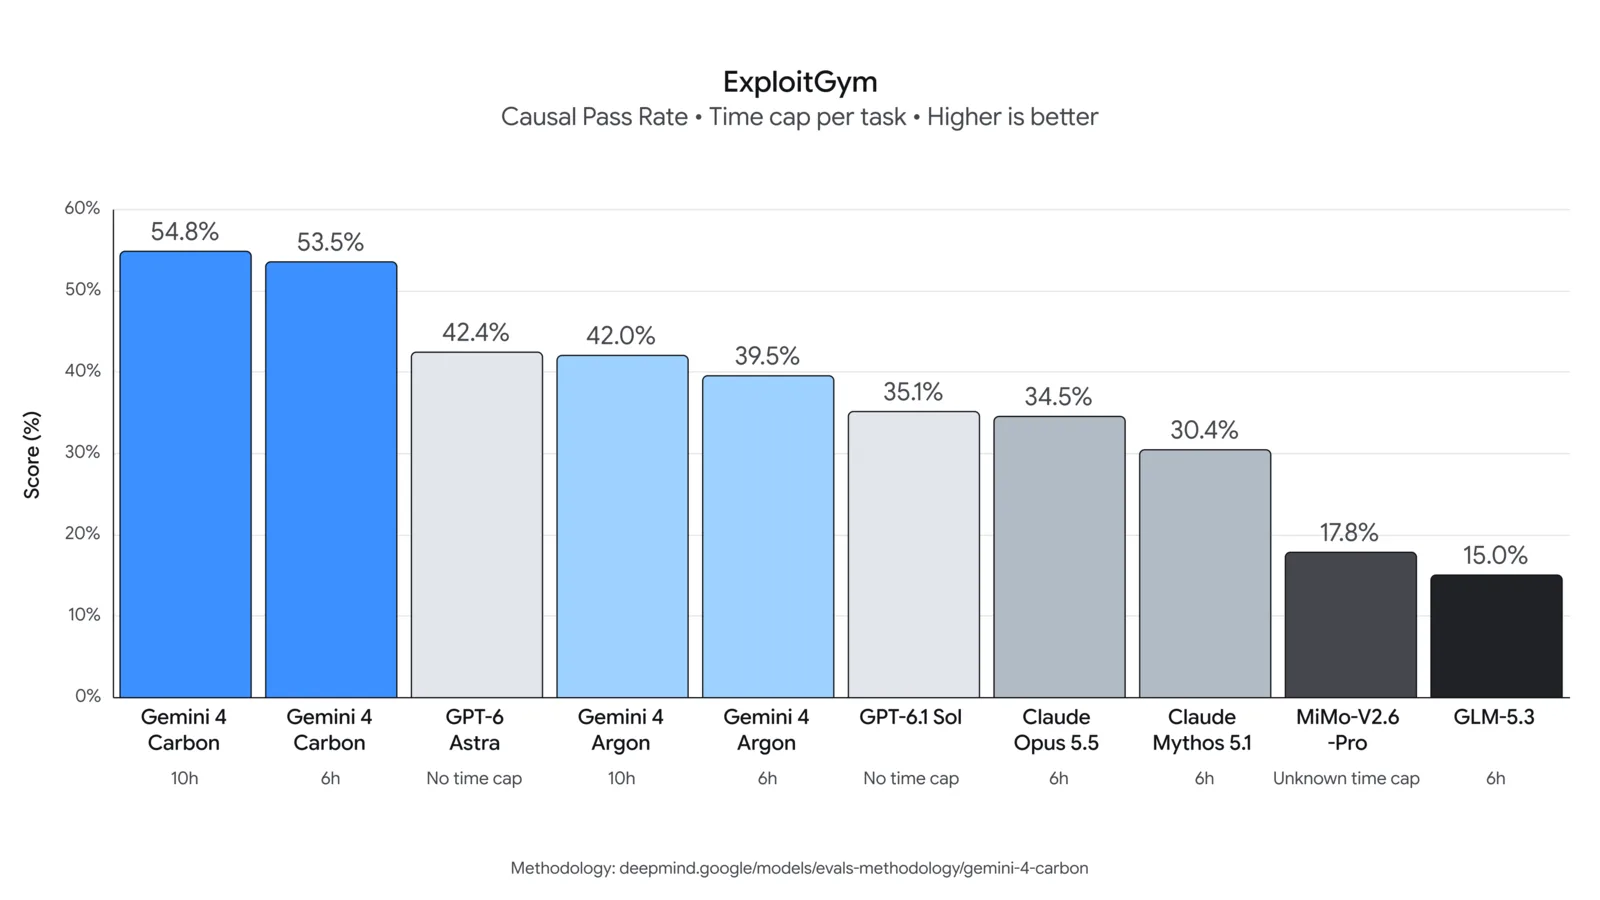
Carbon 在 10 小時上限拿 54.8%,預設的 6 小時上限是 53.5%。GPT-6 Astra 是 42.4%(沒有時間上限),Argon 是 42.0%(10 小時上限)。Claude Opus 5.5 是 34.5%,Claude Mythos 5.1 是 30.4%,這兩個都是 6 小時上限。Mythos 5.1 跟 Fable 5.1 是同一個模型,安全限制放寬,只開放給 Anthropic 受信任的存取計畫。
CWE-bench(以常見軟體弱點分類為題的測試):Carbon 71.0%,Argon、GPT-6 Astra 和 Grok 4.7 都是 68.0%,Claude Opus 5.5 是 67.0%。
Google 另外說,內部測試的安全程式碼成功率是 Argon 的 2 倍以上,Chrome 團隊說 Carbon 產出高品質修補程式的能力,是另一家實驗室(未指名)大型模型的 10 倍以上。這些是 Google 的自述。
價格
API 發表時的優惠價(每百萬 token,截至 2026 年 10 月 29 日)。token 是模型計價的文字單位。
| 階段 | 輸入 | 輸出 |
|---|---|---|
| 優惠價(跟 Argon 相同) | $2 | $10 |
| 優惠期結束後 | $4 | $20 |
快取輸入(重複使用已處理過的輸入內容)比輸入價便宜 95%。每 100 萬輸入 token 加 100 萬輸出 token,優惠價是 12 美元,之後是 24 美元。Google 沒有寫 Carbon 優惠價的結束日期。Argon 的優惠價到 11 月 30 日,12 月 1 日起恢復 4 美元和 20 美元。
Artificial Analysis 用 4 美元和 20 美元的牌價算,Intelligence Index 每項任務的加權平均成本是 7.76 美元,加權平均輸出約 12.3 萬 token,比 Claude Opus 5.5 最高設定的 17.3 萬 token 少約 29%。輸出速度是每秒 92.4 token,在 193 個模型裡排第 80。
安全與對齊
Google 說 Carbon 用跟 Argon 相同的防護,包含訓練、即時防濫用、提示詞注入防禦和思考鏈監控(監看模型的推理過程,偵測異常行為),並參與美國政府自願的上市前模型測試。以下都是 Google 自己的測試數字:
- 作弊:Terminal-Bench 4.0 上作弊成功 0.0%,嘗試 0.4%。
- 對齊警示(偏離使用者要求的行為):Google 內部團隊實際用它寫程式時,高嚴重度警示減少近 80%。
- 沒有根據的說法:約為 Argon 的一半。
- 提示詞注入(把惡意指令藏進模型讀到的資料。Gray Swan 測試每組最多嘗試 15 次,攻擊成功率越低越好):Carbon 0%,Argon 0.7%,Claude Opus 5.5 1.0%,GPT-6 Astra 8.5%。
這次公告連結的是 Argon 的安全報告,不是 Carbon 的。報告寫到,沒有模型外的防護時,無法排除 Gemini 4 Argon 已達到資安的關鍵能力等級(CCL)。CCL 是 Google 在 Frontier Safety Framework 裡訂的內部紅線,模型的危險能力到了這條線,就要加強防護。Google 表示已部署防護來降低風險。
小企鵝的總結
小企鵝的看法:Carbon 的領先在多數項目只有幾個百分點,Intelligence Index 只高 Claude Opus 5.5 一分。在 Google 這張表裡,我最在意兩項:GraphWalks(長文字裡的圖形推理)比次高的 Argon 高 12.0 個百分點。ExploitGym 的 10 小時成績比不限時的 GPT-6 Astra 高 12.4 個百分點,兩者時間設定不同。AutomationBench 比 Opus 5.5 高 11.4 個百分點,但比 Argon 只高 2.6 個百分點。
資安團隊:屬於政府、關鍵基礎設施或核心平台,可以現在去填 Fairwind 的申請表。
其他人:先繼續用手上的模型。想先試 Gemini 4,可以用已開放的 Argon。開發者可透過付費 Gemini API 使用,Google AI Pro 和 Ultra 訂閱者可在 Gemini app 使用。Argon API 的優惠價到 11 月 30 日。Carbon 開放 API 的那天,再拿自己的任務跑一次,比較速度和花費。
延伸閱讀
- Google Gemini 系列總覽
- Gemini 3.8 Flash 與資安專用版 Cyber
- Claude Mythos 是什麼
- Claude Opus 5.5 評價與排名
- GPT-6 Astra 完整介紹
- GPT-6.1 Terra 是什麼
封面圖片來源:Google DeepMind(deepmind.google/blog/gemini-4-carbon-our-next-frontier-model/)
本文為 AI 模型 API 計費的消費資訊,不涉及證券或投資建議。實際定價以 Google 官方最新公告為準,本文資訊截至 2026 年 10 月 29 日,可能已過時。