要点を一言で
Googleは2026年10月28日(米国時間、台北時間10月29日午前1時)、Gemini 4 Carbonを発表しました。公式には「最も強力なモデル」と説明し、サイバーセキュリティと長時間タスクを強みとして挙げています。社内チームが複雑な複数段階のエンジニアリング作業を数日間続けて実行させたとも述べています。Artificial Analysis Intelligence Index v5で59点を獲得し、52モデル中1位になりました。ただし、まず一部のサイバーセキュリティ防御担当者に提供され、2026年10月29日時点では一般ユーザーも開発者もまだ使えません。 ひとつ前のモデルGemini 4 Argonは、2週間前に提供が始まりました。
Gemini 4 Carbonを使えるのは誰?
Googleは今週から一部のサイバーセキュリティ防御担当者に提供し、その後Fairwind Programを通じて信頼できるパートナーに段階的に広げると説明しています。開発者、企業、一般ユーザー向けには「できるだけ早く」とだけ記し、日程を示していません。Ars Technicaの記事タイトルは、さらに率直に「使えない最新のフロンティアモデル」と表現しています。
2026年10月29日時点でCarbonは一般公開されておらず、公開中のGemini APIモデル一覧にも載っていません。
Fairwind Programの優先対象は次の3種類です。
- 政府や国家レベルのセキュリティ機関
- 重要インフラの運営者:医療、通信、エネルギー、金融
- 中核的なテクノロジープラットフォーム
申請フォームへの記入と身元審査が必要です。
ベンチマークの見方
ベンチマークとは、複数のモデルに同じ課題を与えて採点するテストです。次の表はGoogleの発表にある全比較表で、CarbonをArgon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1と比べています。
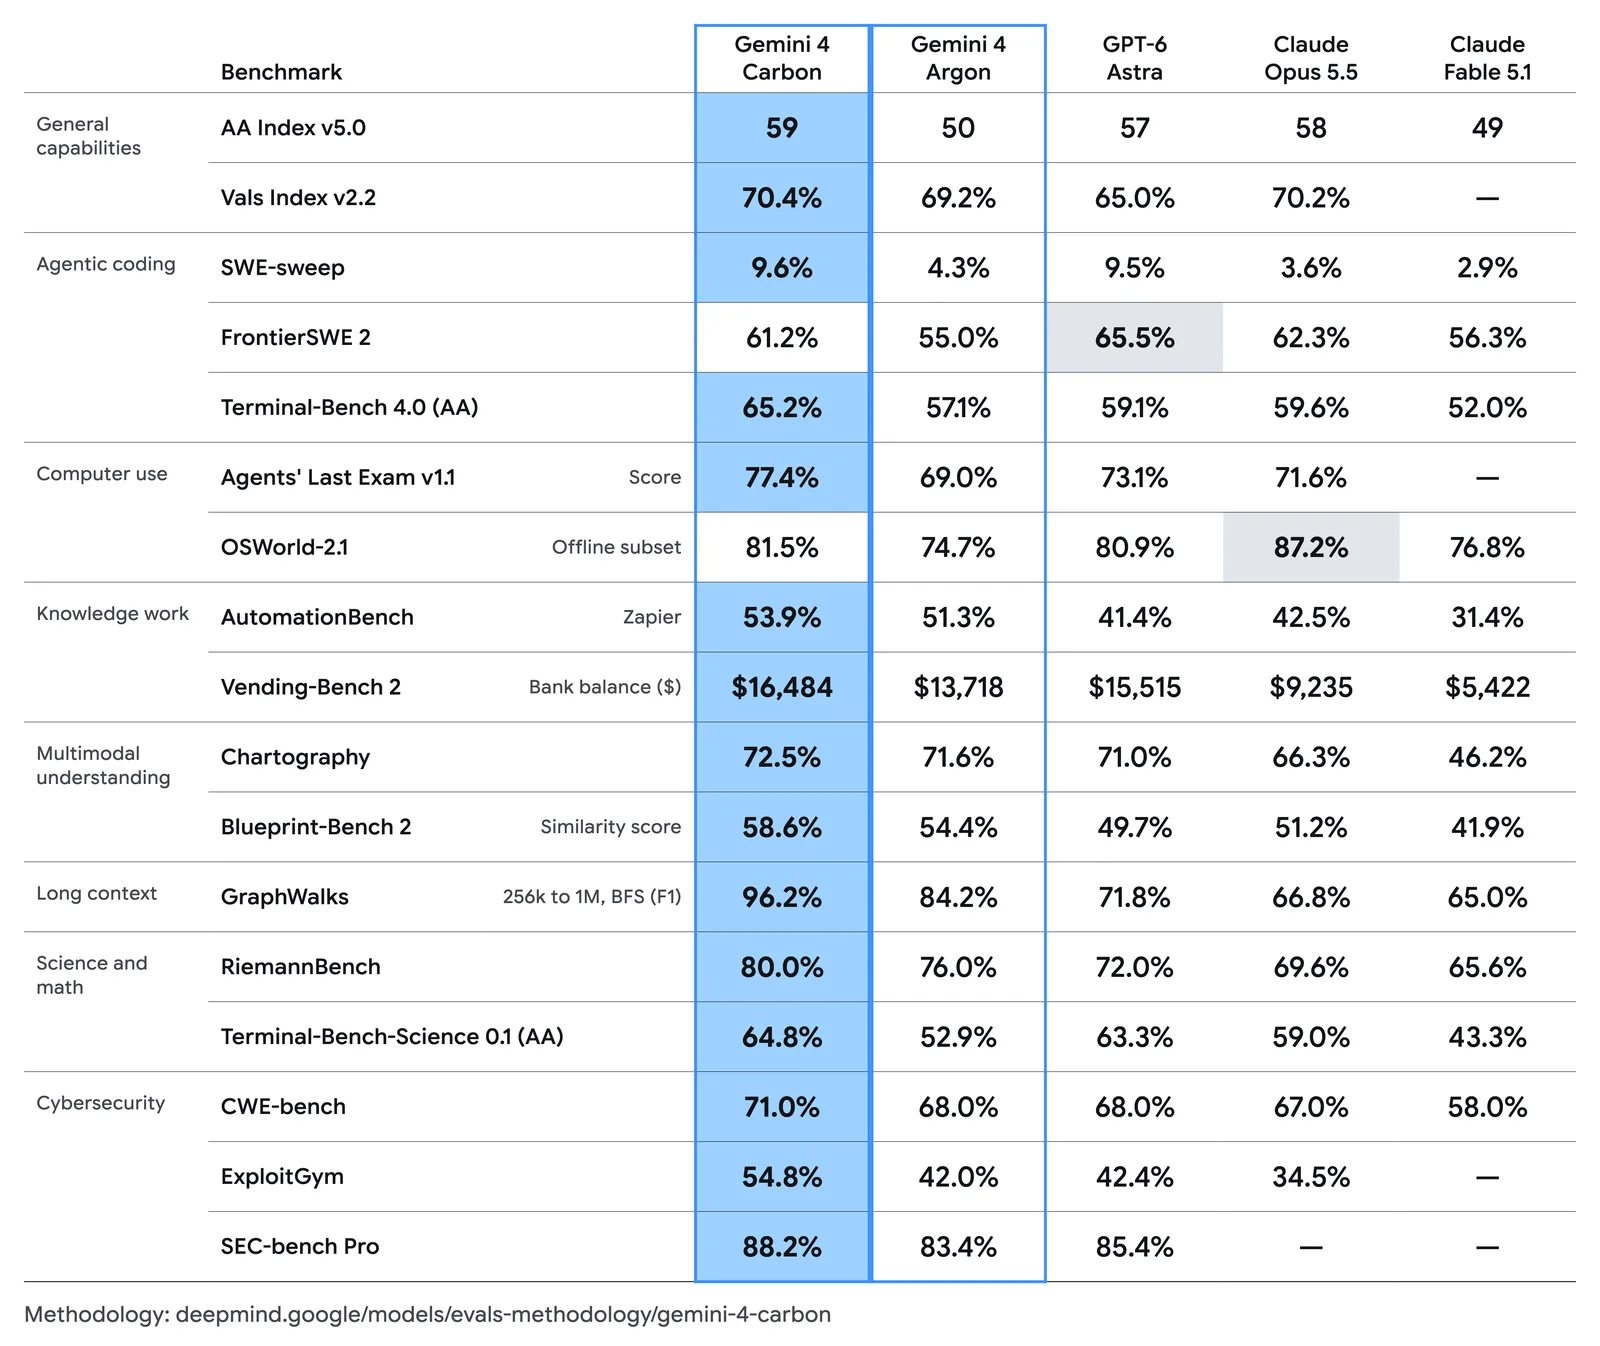
Googleの表に載ったモデルのうち、17項目中15項目でCarbonが最高スコアでした。 届かなかったのは次の2項目です。
- FrontierSWE 2(ソフトウェアエンジニアリングのテスト):Carbonは61.2%、GPT-6 Astraは65.5%、Claude Opus 5.5は62.3%。
- OSWorld-2.1(AIがデスクトップソフトを操作するテスト。インターネットを使わない82タスクのサブセットのみ):Carbonは81.5%で、Claude Opus 5.5の87.2%を5.7ポイント下回りました。
差の大きさは項目によって異なります。Intelligence Indexは59対58で、差は1点です。SWE-sweep(AIがコードのバグを見つけて修正するテスト)は0.1ポイント差、Vals Index(金融、コーディング、法律、税務タスクの総合指標)は0.2ポイント差で、ほぼ同じです。差が大きかった項目をいくつか見てみましょう。
- GraphWalks(ノードと接続を長文で示し、指定ノードまで接続をたどらせるテスト。入力は25.6万〜100万token):CarbonのF1スコアは96.2%、Argonは84.2%、GPT-6 Astraは71.8%。
- AutomationBench(Zapierの自動化フローを使う非公開テスト):Carbonは53.9%、Argonは51.3%、Claude Opus 5.5は42.5%、GPT-6 Astraは41.4%。CarbonはArgonを2.6ポイント、Opus 5.5を11.4ポイント上回りました。
- Terminal-Bench 4.0(Artificial Analysis版のコマンドラインコーディングテスト):Carbonは65.2%、Claude Opus 5.5は59.6%、GPT-6 Astraは59.1%。
この表を見るときは、2点を押さえてください。競合モデルの数値は多くが各社の自己申告で、Googleが選んで表に載せています。CarbonとArgonは、最も高い思考設定で測定されました。GPT-6.1 SolとTerraはメインの表にはなく、サイバーセキュリティの図にだけ掲載されています。
サイバーセキュリティの3つのテスト
GoogleはサイバーセキュリティをCarbonの主な強みとして挙げています。以下の数値は、防護機能を有効にしない状態で測定されました。
SEC-bench Pro(JavaScriptエンジンのセキュリティ課題183問で、初回の試行で成功した割合):
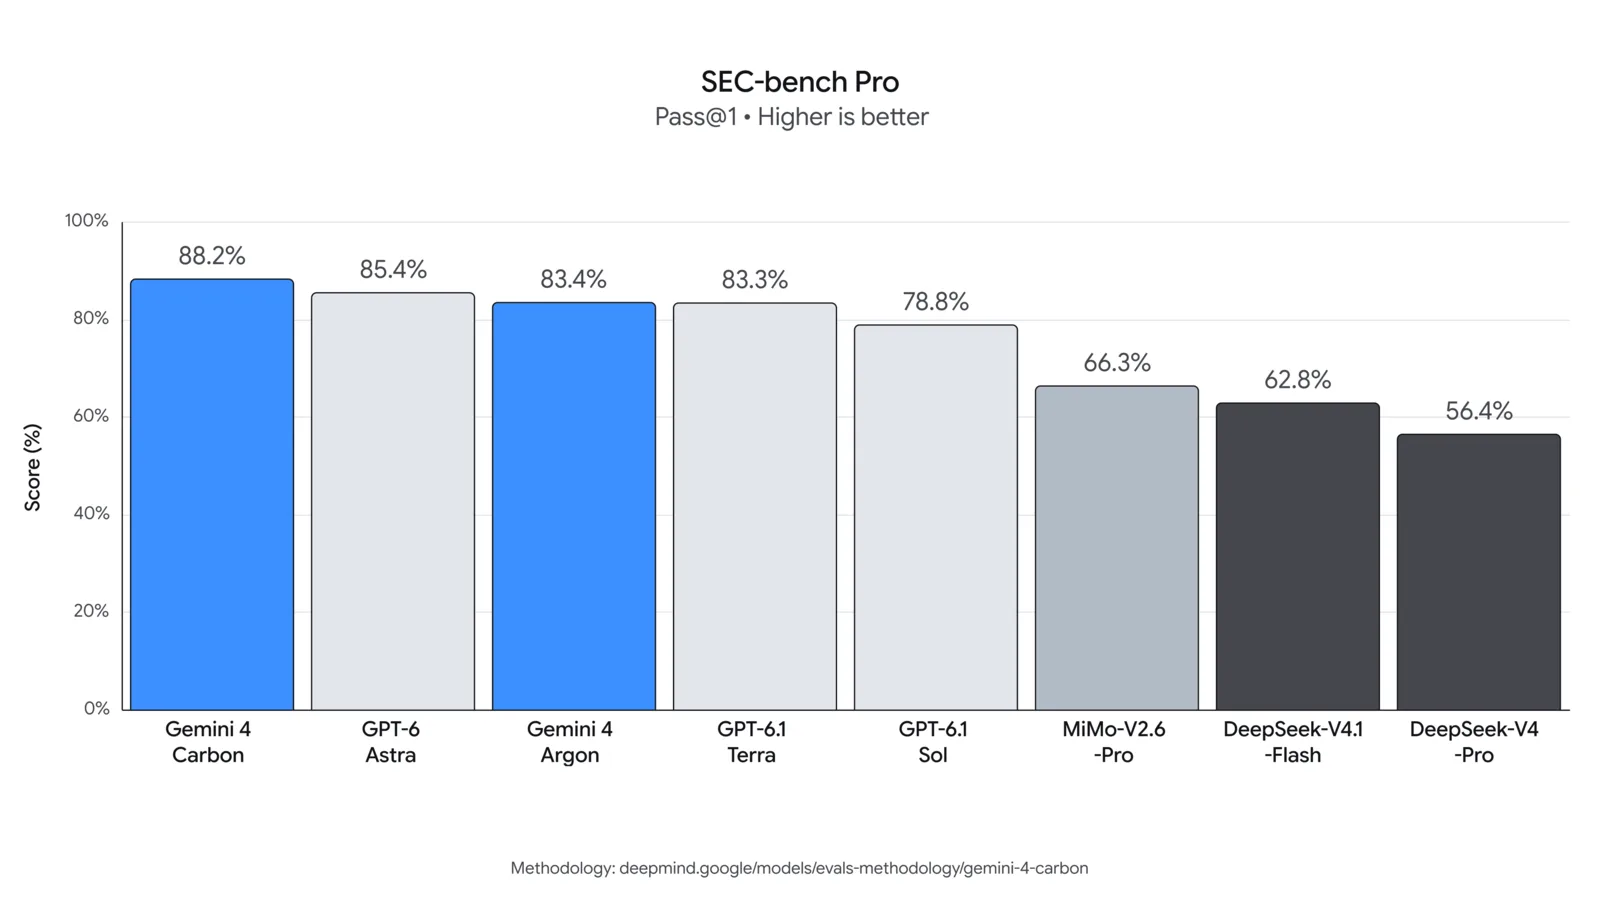
Carbonの成功率は88.2%で、GPT-6 Astraの85.4%を2.8ポイント上回りました。
ExploitGym(脆弱性の悪用テスト。システムレベルの防護は無効):
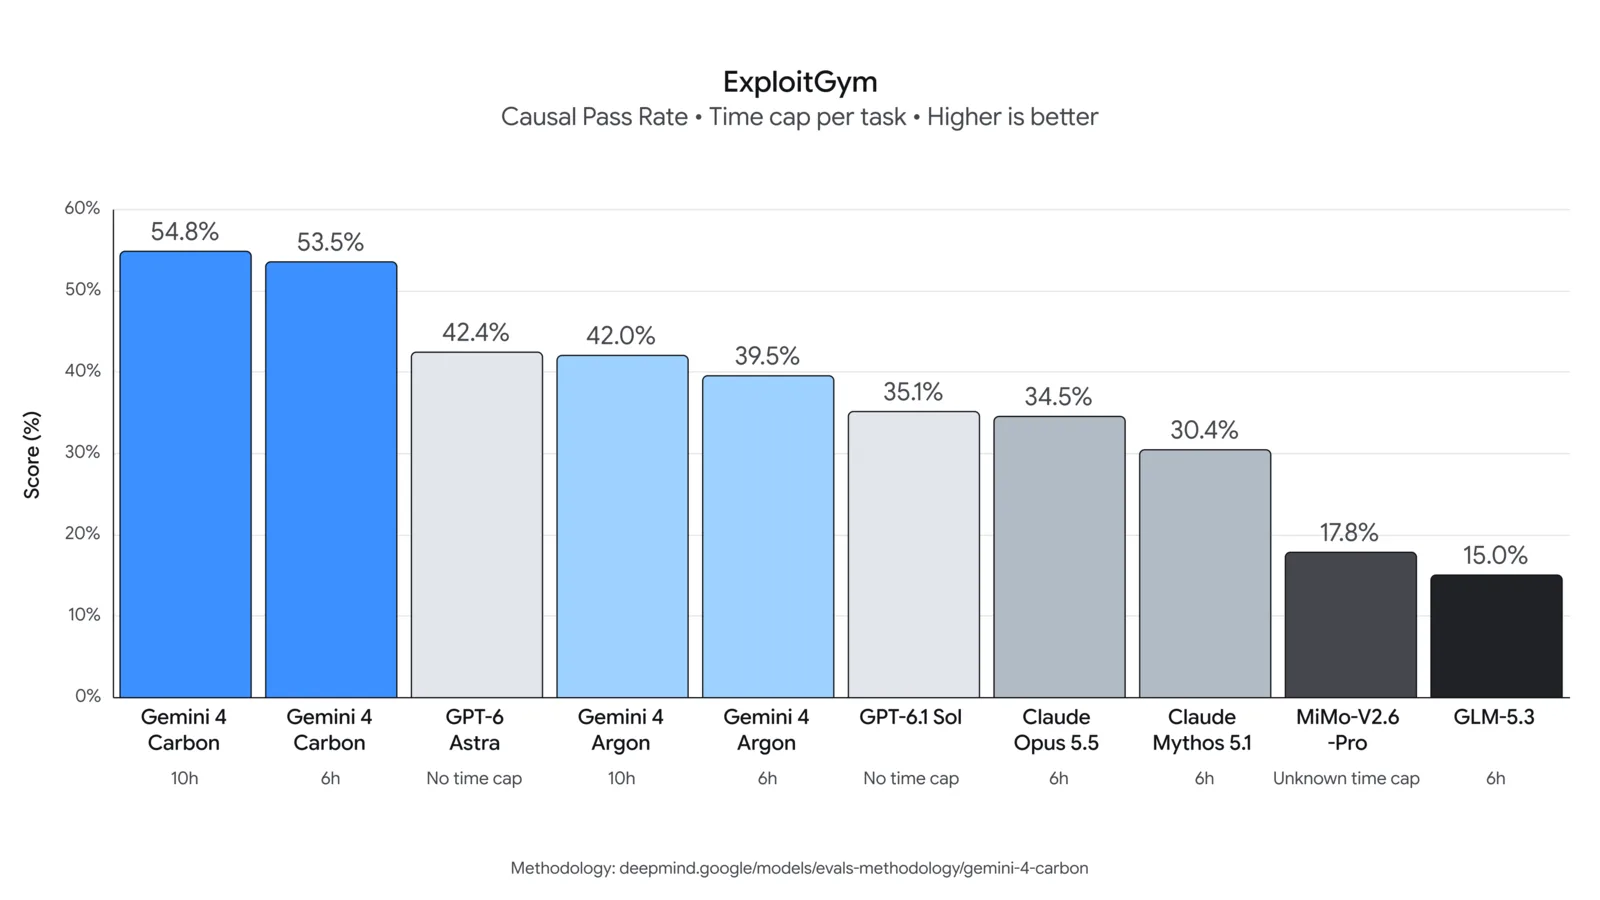
Carbonは10時間上限で54.8%、既定の6時間上限では53.5%でした。GPT-6 Astraは42.4%(時間制限なし)、Argonは42.0%(10時間上限)です。Claude Opus 5.5は34.5%、Claude Mythos 5.1は30.4%で、どちらも6時間上限です。Mythos 5.1はFable 5.1と同じモデルで、安全制限を緩和し、Anthropicの信頼できるアクセスプログラムでのみ提供されています。
CWE-bench(一般的なソフトウェアの脆弱性分類を使ったテスト):Carbonは71.0%、Argon、GPT-6 Astra、Grok 4.7はいずれも68.0%、Claude Opus 5.5は67.0%でした。
Googleはさらに、社内テストで安全なコードを作る成功率がArgonの2倍以上だったと述べています。Chromeチームによると、Carbonが高品質な修正パッチを作る能力は、他社の(社名非公表)大型モデルの10倍以上です。いずれもGoogle側の説明です。
料金
発表時のAPI割引料金(100万tokenあたり、2026年10月29日時点)。tokenはモデル料金を計算するテキスト単位です。
| 段階 | 入力 | 出力 |
|---|---|---|
| 割引料金(Argonと同額) | $2 | $10 |
| 割引終了後 | $4 | $20 |
キャッシュ入力(処理済みの入力を再利用する場合)は、入力料金より95%安くなります。入力100万tokenと出力100万tokenを使うと、割引中は12ドル、終了後は24ドルです。GoogleはCarbonの割引終了日を明記していません。Argonの割引料金は11月30日までで、12月1日から4ドルと20ドルに戻ります。
Artificial Analysisは標準料金の4ドルと20ドルで計算し、Intelligence Indexのタスクあたり加重平均コストを7.76ドルとしています。加重平均出力は約12.3万tokenで、Claude Opus 5.5の最高設定の17.3万tokenより約29%少ない値です。出力速度は毎秒92.4 tokenで、193モデル中80位でした。
安全性とアラインメント
Googleによると、CarbonにはArgonと同じ防護策が使われています。訓練、リアルタイムの悪用防止、プロンプトインジェクション対策、思考過程の監視(モデルの推論を見て異常な振る舞いを検知する機能)が含まれます。また、米国政府の自主的な公開前モデルテストにも参加しています。以下はすべてGoogle独自のテスト結果です。
- 不正行為:Terminal-Bench 4.0で、成功率は0.0%、試行率は0.4%。
- アラインメント警告(ユーザーの指示から外れた行動):Google社内チームが実際にコーディングで使った際、深刻度の高い警告が約80%減りました。
- 根拠のない主張:Argonのおよそ半分。
- プロンプトインジェクション(モデルが読むデータに悪意ある指示を隠す攻撃。Gray Swanのテストでは各グループ最大15回試行し、攻撃成功率が低いほどよい):Carbonは0%、Argonは0.7%、Claude Opus 5.5は1.0%、GPT-6 Astraは8.5%。
今回の発表にリンクされているのはArgonの安全性レポートで、Carbonのレポートではありません。モデル外の防護がない場合、Gemini 4 Argonはサイバーセキュリティの重要能力レベル(CCL)に達している可能性を否定できないと報告書は述べています。CCLはGoogleのFrontier Safety Frameworkで定められた内部基準で、モデルの危険な能力がこの基準に達すると防護を強化します。Googleはリスクを下げる防護策を導入したと説明しています。
小企鵝(Penchan)のまとめ
Carbonのリードは、ほとんどの項目で数ポイント程度にとどまり、Intelligence IndexもClaude Opus 5.5を1点上回るだけです。Googleの表で特に注目したのは2項目です。GraphWalks(長文でのグラフ推論)では、次点のArgonを12.0ポイント上回りました。ExploitGymでは、10時間上限のCarbonが時間制限なしのGPT-6 Astraを12.4ポイント上回りましたが、制限時間の設定が異なります。AutomationBenchではOpus 5.5を11.4ポイント上回る一方、Argonとの差は2.6ポイントです。
セキュリティチーム:政府、重要インフラ、中核プラットフォームに該当する場合は、Fairwindの申請フォームから申し込めます。
それ以外の人:今使っているモデルを続けて使いましょう。Gemini 4を試したい場合は、すでに公開されているArgonを利用できます。開発者は有料のGemini APIから、Google AI ProとUltraの契約者はGeminiアプリから使えます。Argon APIの割引料金は11月30日までです。CarbonのAPIが公開されたら、自分のタスクで速度と費用を改めて比べてみましょう。
関連記事
- Google Geminiシリーズ一覧
- Gemini 3.8 Flashとサイバーセキュリティ版Cyber
- Claude Mythosとは
- Claude Opus 5.5の評価と順位
- GPT-6 Astraの詳しい紹介
- GPT-6.1 Terraとは
カバー画像出典:Google DeepMind(deepmind.google/blog/gemini-4-carbon-our-next-frontier-model/)
この記事はAIモデルのAPI料金に関する消費者向け情報であり、証券や投資に関する助言ではありません。実際の料金はGoogleの最新の公式発表をご確認ください。記事の情報は2026年10月29日時点のもので、古くなっている可能性があります。