一句话重点
Gemini 4 Argon 是 Google 目前面向大众开放、能力最强的 Gemini 模型。Google 于美国时间 2026 年 10 月 13 日全面开放(台北时间 10 月 14 日凌晨)。美国时间 9 月 30 日的首次开放只面向通过 Fairwind Program(Google 面向可信网络安全防御人员的计划)申请的人。Gemini app 只有 AI Pro 或 Ultra 订阅用户能用 Argon,Plus 和免费版都没有,API 没有免费额度,优惠价只到 11 月 30 日。
Gemini 4 Carbon 于美国时间 10 月 28 日(台北时间 10 月 29 日凌晨)发布,综合跑分高于 Argon。它目前和 Argon 一样,先向网络安全防御人员开放。截至 10 月 29 日,尚未向公众开放。Argon 从限量开放到全面开放间隔约两周。
谁能用、多少钱
Gemini app:根据 Google 帮助中心 10 月 29 日查询到的方案表,个人账户可用的模型如下。
| 方案 | 月费(台湾) | 能用 Argon 吗 |
|---|---|---|
| 免费 | NT$0 | 不能,可用 Auto 或 Flash-Lite |
| Google AI Plus | NT$165 | 不能,可用 Flash-Lite、Flash、Pro |
| Google AI Pro | NT$650 | 可以 |
| Google AI Ultra | NT$3,300 或 NT$6,500 | 可以 |
Pro 的用量是免费版的 4 倍,Ultra 是 Pro 的 5 倍(NT$3,300)或 20 倍(NT$6,500)。Google 没有公布各方案中 Argon 的消息数量。Pro 和 Ultra 也能在 Google 搜索的 AI 模式中使用 Argon。Antigravity(Google 的 AI 编程工具)中的 Argon,发布时只向 Ultra 订阅用户开放。
开发者:Gemini API 没有 Argon 的免费额度,需要使用付费版。模型 ID 是 gemini-4-argon,付费 API 可在 Google AI Studio 和 Android Studio 中使用,AI Ultra 订阅用户也能在 AI Studio 试用,企业客户从 10 月 13 日起可在 Vertex AI 使用。
API 价格(每百万 token,token 是模型计费的文本单位):
| 阶段 | 输入 | 输出(含思考) | 缓存输入 |
|---|---|---|---|
| 标准价,到 11 月 30 日 | $2 | $10 | $0.10 |
| 标准价,12 月 1 日起 | $4 | $20 | $0.20 |
| Batch / Flex,到 11 月 30 日 | $1 | $5 | $0.05 |
Batch 是一次提交一批请求,不必实时等待结果,价格是标准价的一半。Flex 同样便宜,但请求可能需要等待更久才会处理。缓存输入指重复使用同一段内容时的较低价格。Argon 只有隐式缓存(implicit caching),由系统自动识别重复输入,不需要自己创建缓存。Argon 没有针对超长输入额外收费的档位。
按标准价估算:多次请求累计使用输入和输出各 100 万 token,优惠期价格为 12 美元,12 月 1 日起为 24 美元。Gemini 3.1 Pro Preview 的标价是输入 2 美元、输出 12 美元(输入不超过 20 万 token),超过 20 万 token 则为 4 美元和 18 美元。因此从 12 月起,Argon 比 3.1 Pro 贵。
规格
- 上下文长度:1,048,576 token,输入和输出共用。
- 输出长度:默认最多 65,536 token,开启长解码(long decode,一次输出超长内容的模式)后最多 1,048,576 token。Google 称这是业界领先,原本为 64K。
- 输入格式:文本、图片、视频、音频、PDF。只输出文本。
- 思考等级(thinking level,控制模型回答前思考多久):low、medium、high,默认 medium。
- 知识截止日期:2026 年 3 月。
Google 表示 Argon 不是对现有模型的修改版或微调版。
跑分怎么看
跑分就是让不同模型完成同一组任务,再给出分数。下面是 Google 发布 Argon 时的对照表,比较 Argon、GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。
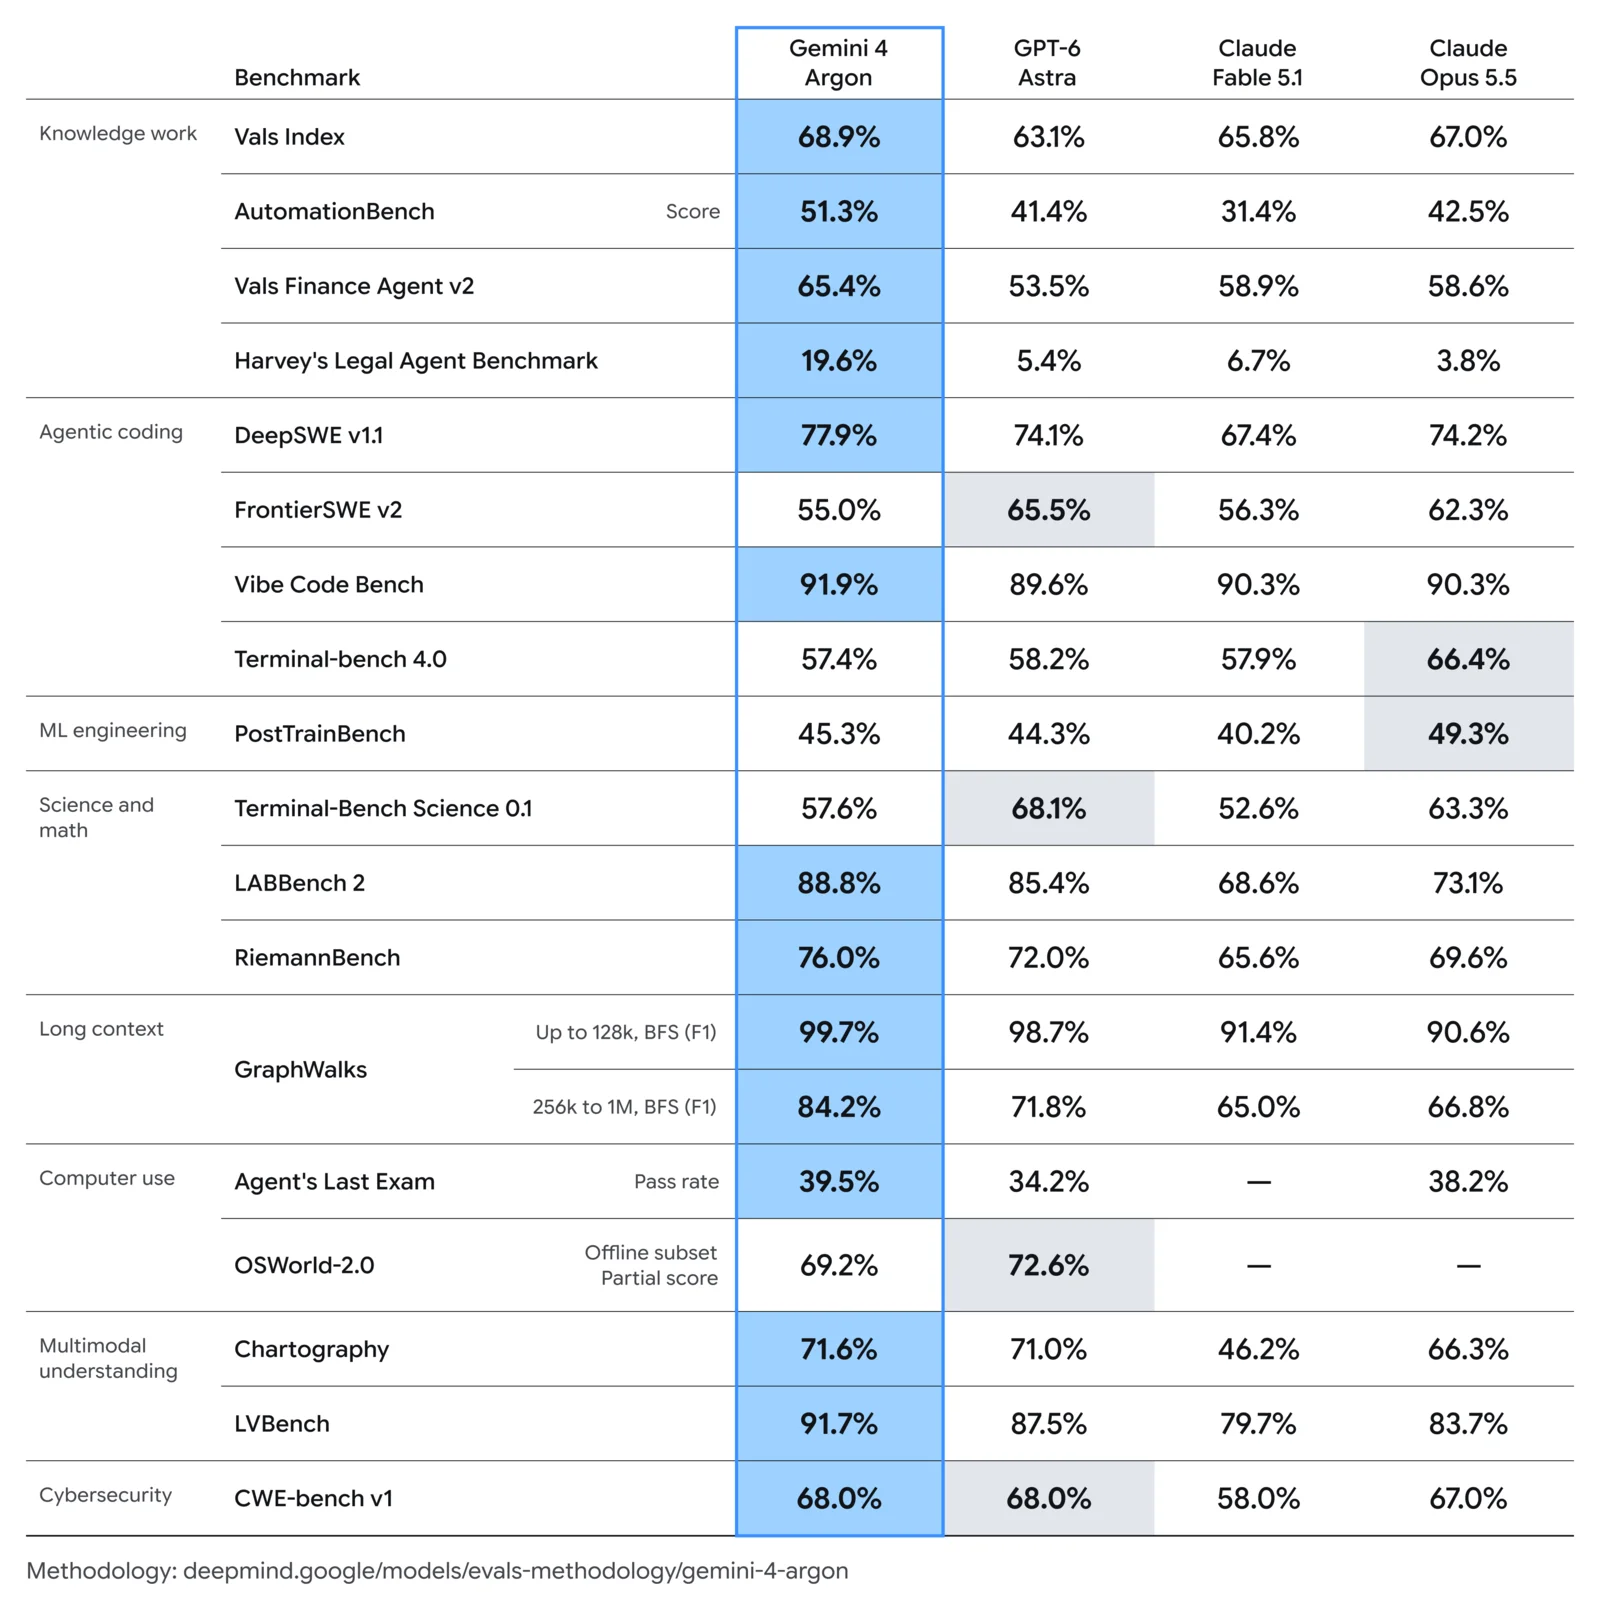
在 Google 这张表列出的模型中,19 项测试有 13 项 Argon 得分最高,1 项并列(CWE-bench,Argon 和 GPT-6 Astra 均为 68.0%),5 项落后。 最明显的三个优势领域:
- 法律和金融 AI Agent:Harvey’s Legal Agent Benchmark 得分为 19.6%,第二名 Claude Fable 5.1 只有 6.7%。Vals Finance Agent v2 为 65.4%,比 Fable 5.1 的 58.9% 高 6.5 个百分点。
- 长文本中的关系网络推理:GraphWalks 测试关系网络推理(像人际关系图那样由点和线组成的网络,不是图片)。它把节点和连接写成一大段文本,模型需要沿着连接找出指定节点,而不是在文档中搜索。在长度为 25.6 万到 100 万 token 的题目组中,Argon 的 F1 分数(同时看查全率和准确率)是 84.2%,GPT-6 Astra 是 71.8%,相差 12.4 个百分点。长度不超过 12.8 万 token 的题目组得分为 99.7%。
- 长视频:LVBench 得分为 91.7%,GPT-6 Astra 为 87.5%,高 4.2 个百分点。
落后的 5 项如下,后面列出的是得分最高的对手:
- FrontierSWE v2(软件工程):Argon 55.0%,GPT-6 Astra 65.5%。
- Terminal-bench 4.0(命令行编程):Argon 57.4%,Claude Opus 5.5 66.4%,相差 9.0 个百分点。
- PostTrainBench(测试 AI 能否接手训练和调整另一个模型):Argon 45.3%,Claude Opus 5.5 49.3%。
- Terminal-Bench Science 0.1(通过命令行完成科学研究任务):Argon 57.6%,GPT-6 Astra 68.1%。
- OSWorld-2.0(测试 AI 操作桌面软件,只统计不需要上网的任务):Argon 69.2%,GPT-6 Astra 72.6%。
编程并非全面落后。DeepSWE v1.1 是 Argon 最高(77.9%,Opus 5.5 为 74.2%),Vibe Code Bench 也由 Argon 领先(91.9%)。落后项主要集中在命令行和电脑操作这两类任务。
看这张表要记住两点。第一,表中混合了第三方排行榜、Google 自测和各厂商公布的成绩,测试设置也不完全相同。第二,Argon 使用最高思考设置进行测试。Carbon 发布时,Google 的新版表格用更新版测试重测了部分 Argon 项目,数字与这张表不同,不要把两张表混在一起比较。
网络安全
Google 另外公布了两项网络安全测试,并与自家的网络安全专用模型 Gemini 3.8 Flash Cyber 对比。
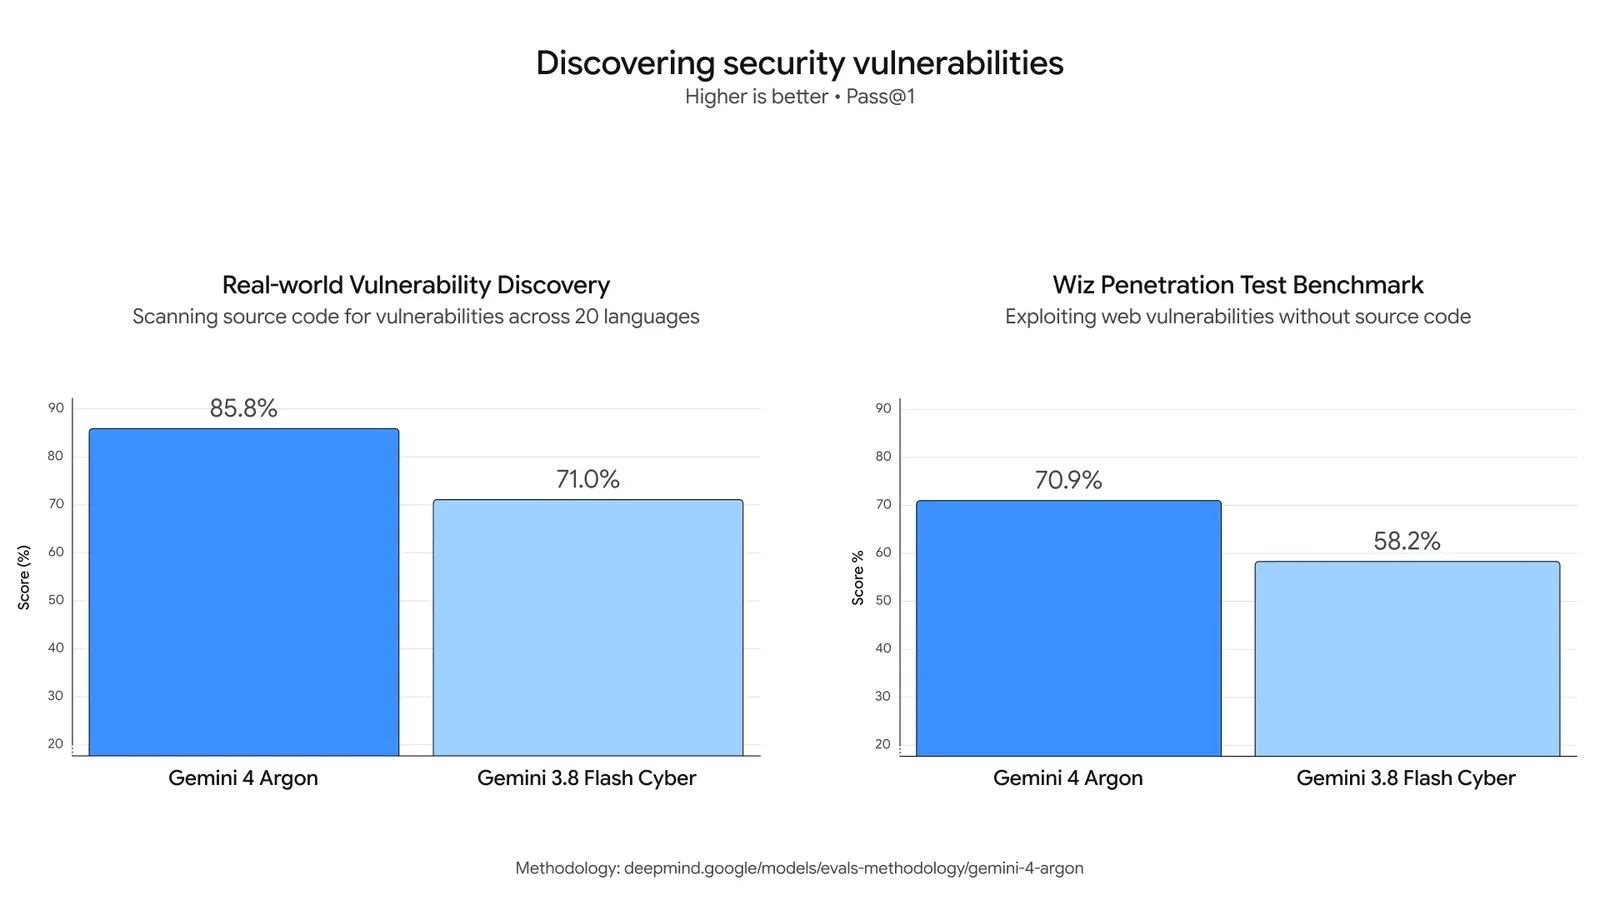
- Real-world Vulnerability Discovery(发现真实代码中的漏洞,涵盖 20 种编程语言,Google 内部测试):Argon 85.8%,3.8 Flash Cyber 71.0%。
- Wiz Penetration Test Benchmark(Wiz 内部黑盒渗透测试,测试时看不到源代码):Argon 70.9%,3.8 Flash Cyber 58.2%。
另一项是 Gray Swan 的提示注入(prompt injection)测试,也就是把恶意指令藏进模型读取的数据中,诱使它照做。每组最多尝试 15 次,攻击成功率越低越好:Argon 0.7%,Claude Opus 5.5 和 Claude Fable 5.1 均为 1.0%,GPT-6 Astra 为 8.5%,GPT-6 Sol 为 10.1%。
还有一个面向网络安全用途放宽限制的版本 gemini-4-argon-cyber-permissive,只向 Fairwind 名单中的用户开放,普通 API 用户无法使用。
与 Gemini 3.1 Pro、Carbon 的关系
Gemini 3.1 Pro:仍在提供。API 的 gemini-3.1-pro-preview 没有公布停用日期,Gemini app 的方案页也同时列出了两个模型。Google 没有说 Argon 会取代 3.1 Pro。
Carbon:综合跑分更高,开放日期未定。优惠价与 Argon 相同(输入 2 美元、输出 10 美元)。在 Artificial Analysis Intelligence Index v5(第三方综合智力指数)中,Argon 得分 50,Carbon 得分 59。Artificial Analysis 测得 Argon 的输出速度约为每秒 82 token,评价是“低于平均速度,而且比较啰嗦”。输出是费用较高的那一半,估算成本时也要算进去。
安全
Google 的 Argon 安全报告表示,不能排除未加防护的模型已在网络安全和 CBRN(化学、生物、放射性、核)两个领域达到关键能力级别(CCL)。CCL 是 Google 在 Frontier Safety Framework 中为高风险 AI 设定的内部红线,达到后就需要加强防护。因此 Google 部署了防护措施,包括监控模型的推理过程和行为,必要时可以中止执行。外部测试机构包括英国 AISI、美国 NIST 的 CAISSI(按报告中的拼法)、Gray Swan 和 Trajectory Labs。
小企鹅的总结
已经订阅 Pro 或 Ultra 的用户:在模型菜单中切换到 Argon,用自己的法律文件、财报或长 PDF 任务试一次,并与原来使用的模型比较。Argon 的优势是法律和金融 AI Agent。GraphWalks 测的是关系网络,不是一般的长文档。
使用 Plus 或免费版的用户:我的看法是不必为了 Argon 升级。Plus 到 Pro 相差 NT$485。想在 Gemini app 中试用,AI Pro 是月费最低的方案。
主要做编程的用户:Argon 在命令行和 FrontierSWE v2 项目上落后于对手,这类工作可以先看看 Claude Opus 5.5 和 GPT-6 Astra。
开发者:使用付费 Gemini API,按 12 月 1 日起的 4 美元和 20 美元估算成本,把优惠价视为短期折扣。可以等待结果的批量任务用 Batch。Argon 输出偏长,而且输出价格更高,先用自己的任务量跑一轮,看看实际花费。
Carbon 开放 API 后,用同一批任务再比较一次。
延伸阅读
- Gemini 4 Carbon 是什么
- Google Gemini 系列总览
- Gemini 免费版和 Pro 有什么区别
- 如何使用 Google AI Studio
- Gemini 3.8 Flash 与网络安全专用版 Cyber
- Claude Opus 5.5 评价与排名
- GPT-6 Astra 完整介绍
封面图片来源:Google
本文是关于 AI 模型方案和 API 计费的消费信息,不涉及证券或投资建议。实际价格与功能以 Google 官方最新公告为准,本文信息截至 2026 年 10 月 29 日,可能已经过时。