要点を一言で
Gemini 4 Argonは、現在一般向けで最も高性能なGoogleのGeminiモデルです。Googleは2026年10月13日(米国時間、台北時間10月14日午前0時)に一般公開しました。米国時間9月30日の先行提供は、Fairwind Program(Googleが信頼するサイバーセキュリティ防御担当者向けのプログラム)に申請した人だけが対象でした。GeminiアプリでArgonを使うにはAI ProまたはUltraが必要です。Plusと無料プランでは使えず、APIに無料枠はありません。割引料金は11月30日までです。
Gemini 4 Carbonは米国時間10月28日(台北時間10月29日未明)に発表され、総合スコアはArgonを上回ります。現在の提供方法はArgonと同じで、まずサイバーセキュリティ防御担当者に限られています。10月29日時点では一般公開されていません。Argonは限定提供から一般公開まで約2週間かかりました。
使える人と料金
Geminiアプリ:Googleヘルプで10月29日に確認したプラン表によると、個人アカウントで使えるモデルは次のとおりです。
| プラン | 月額料金(台湾) | Argonを使えるか |
|---|---|---|
| 無料 | NT$0 | 使えない。AutoまたはFlash-Liteを利用 |
| Google AI Plus | NT$165 | 使えない。Flash-Lite、Flash、Proを利用 |
| Google AI Pro | NT$650 | 使える |
| Google AI Ultra | NT$3,300またはNT$6,500 | 使える |
Proの利用上限は無料プランの4倍、UltraはProの5倍(NT$3,300の場合)または20倍(NT$6,500の場合)です。Googleは各プランのArgon利用回数を公表していません。ProとUltraではGoogle検索のAIモードでもArgonを利用できます。Antigravity(GoogleのAIコーディングツール)でのArgonは、発表時点ではUltra契約者のみが対象です。
開発者:Gemini APIにArgonの無料枠はなく、有料版が必要です。モデルIDはgemini-4-argonです。有料APIはGoogle AI StudioとAndroid Studioで利用でき、AI Ultra契約者もAI Studioで試せます。企業ユーザーは10月13日からVertex AIで利用できます。
API料金(100万tokenあたり。tokenはモデルの料金計算に使うテキスト単位です):
| 期間 | 入力 | 出力(思考を含む) | キャッシュ入力 |
|---|---|---|---|
| 通常、11月30日まで | $2 | $10 | $0.10 |
| 通常、12月1日以降 | $4 | $20 | $0.20 |
| Batch / Flex、11月30日まで | $1 | $5 | $0.05 |
Batchは大量のリクエストをまとめて送信し、結果をすぐに待たない方法で、通常料金の半額です。Flexも同じく安価ですが、処理まで時間がかかる場合があります。キャッシュ入力は同じ内容を再利用する場合の割引料金です。Argonは暗黙的キャッシュ(implicit caching)のみを使い、システムが重複する入力を自動で判別するため、自分でキャッシュを作る必要はありません。Argonには非常に長い入力向けの追加料金区分はありません。
通常料金で、複数回のリクエストの合計が入力100万token、出力100万tokenになった場合、割引期間中は12ドル、12月1日からは24ドルです。Gemini 3.1 Pro Previewの通常料金は入力2ドル、出力12ドル(入力20万tokenまで)で、20万tokenを超えると4ドルと18ドルです。そのため12月以降はArgonのほうが高くなります。
仕様
- コンテキスト長:1,048,576 token。入力と出力で共有します。
- 出力長:既定で最大65,536 token。長い出力を一度に生成するlong decodeを有効にすると最大1,048,576 tokenです。Googleは業界をリードする長さと説明しており、従来は64Kでした。
- 入力形式:テキスト、画像、動画、音声、PDF。出力はテキストのみです。
- 思考レベル(回答前にどれだけ考えるかを制御):low、medium、high。既定値はmediumです。
- 知識の期限:2026年3月。
Googleによると、Argonは既存モデルを改良または微調整したものではありません。
ベンチマークの見方
ベンチマークとは、複数のモデルに同じ課題を与えて採点するテストです。以下はArgon発表時にGoogleが示した比較表で、ArgonをGPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5と比べています。
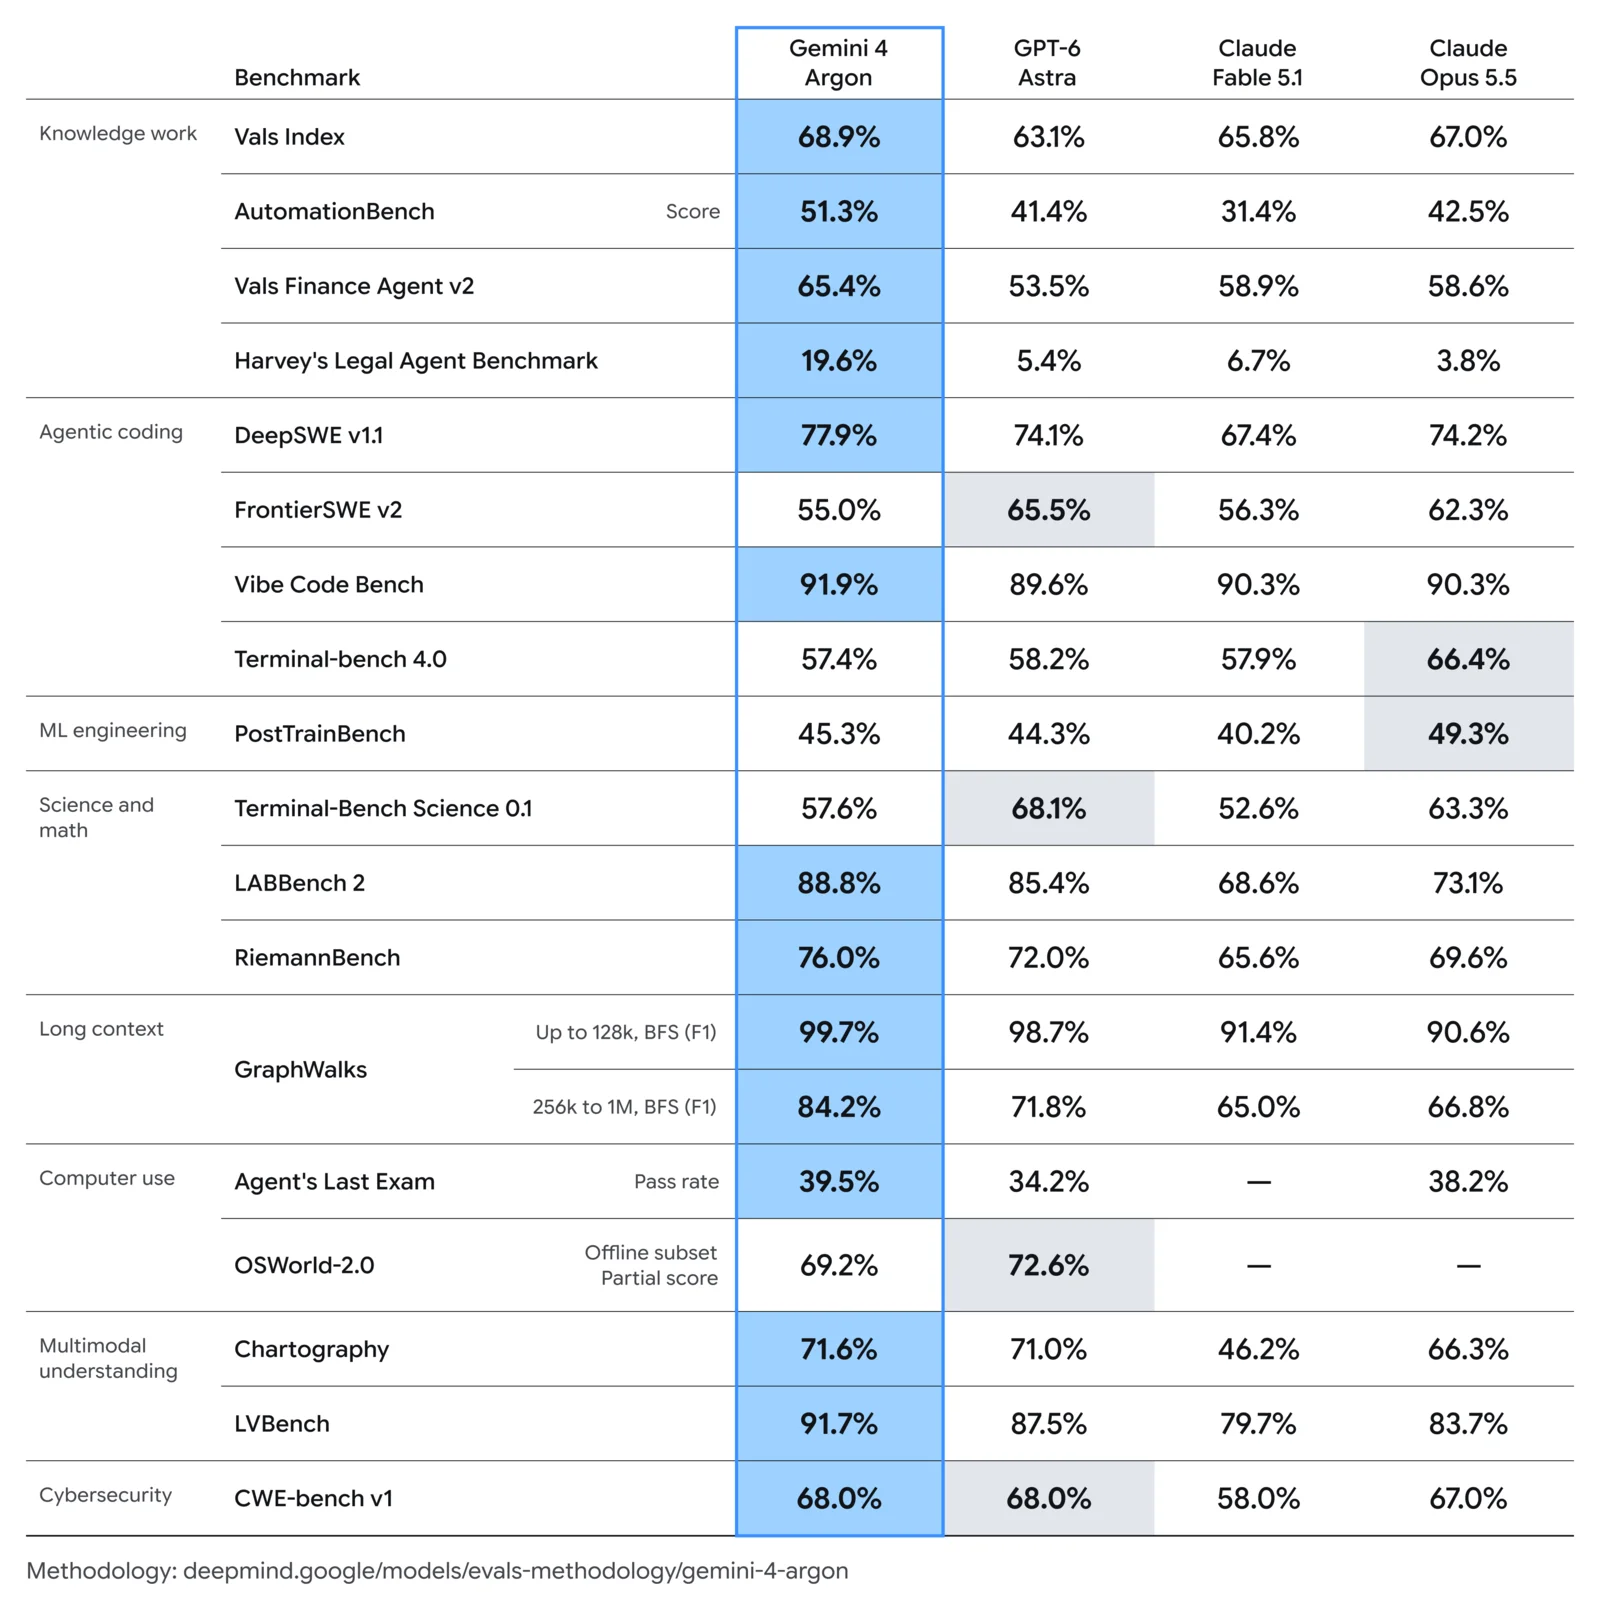
Googleの表に載ったモデルでは、19項目中13項目でArgonが最高スコア、1項目で同点(CWE-benchはArgonとGPT-6 Astraがともに68.0%)、5項目で下回りました。 特に差が大きかったのは次の3分野です。
- 法律・金融AI Agent:Harvey’s Legal Agent Benchmarkは19.6%で、次点のClaude Fable 5.1(6.7%)を上回りました。Vals Finance Agent v2は65.4%で、Fable 5.1の58.9%より6.5ポイント高い結果でした。
- 長文に含まれる関係の推論:GraphWalksは、関係を点と線で表すネットワークを推論するテストです(画像ではありません)。ノードと接続を長文で示し、文書内を検索するのではなく、接続をたどって指定されたノードを探します。25.6万〜100万tokenの問題では、ArgonのF1スコア(見落としの少なさと正確さを合わせた指標)は84.2%、GPT-6 Astraは71.8%で、差は12.4ポイントでした。12.8万token以下の問題では99.7%でした。
- 長時間動画:LVBenchでは91.7%で、GPT-6 Astraの87.5%より4.2ポイント高い結果でした。
下回った5項目と、最高スコアの競合モデルは次のとおりです。
- FrontierSWE v2(ソフトウェアエンジニアリング):Argonは55.0%、GPT-6 Astraは65.5%。
- Terminal-bench 4.0(コマンドラインでのコーディング):Argonは57.4%、Claude Opus 5.5は66.4%で、差は9.0ポイント。
- PostTrainBench(AIが別のモデルの訓練や調整を引き継げるかを測定):Argonは45.3%、Claude Opus 5.5は49.3%。
- Terminal-Bench Science 0.1(コマンドラインで科学研究の課題を完了するテスト):Argonは57.6%、GPT-6 Astraは68.1%。
- OSWorld-2.0(AIによるデスクトップソフトの操作を測定。インターネット接続が不要な課題のみ):Argonは69.2%、GPT-6 Astraは72.6%。
コーディングですべて負けたわけではありません。DeepSWE v1.1ではArgonが最高の77.9%(Opus 5.5は74.2%)、Vibe Code Benchでも最高の91.9%でした。差がついたのは主にコマンドラインとコンピューター操作のテストです。
この表を見るときは2点に注意してください。第一に、第三者ランキング、Google独自の測定、各社が公表したスコアが混在しており、テスト条件も完全にはそろっていません。第二に、Argonは最も高い思考設定で測定されました。Carbonの発表時にGoogleは新しい表で、新しいバージョンのテストを使ってArgonの一部項目を再測定しており、数値がこの表と異なります。2つの表の数値を混ぜて比較しないでください。
サイバーセキュリティ
Googleは自社のサイバーセキュリティ専用モデルGemini 3.8 Flash Cyberとの比較テストを2つ公表しました。
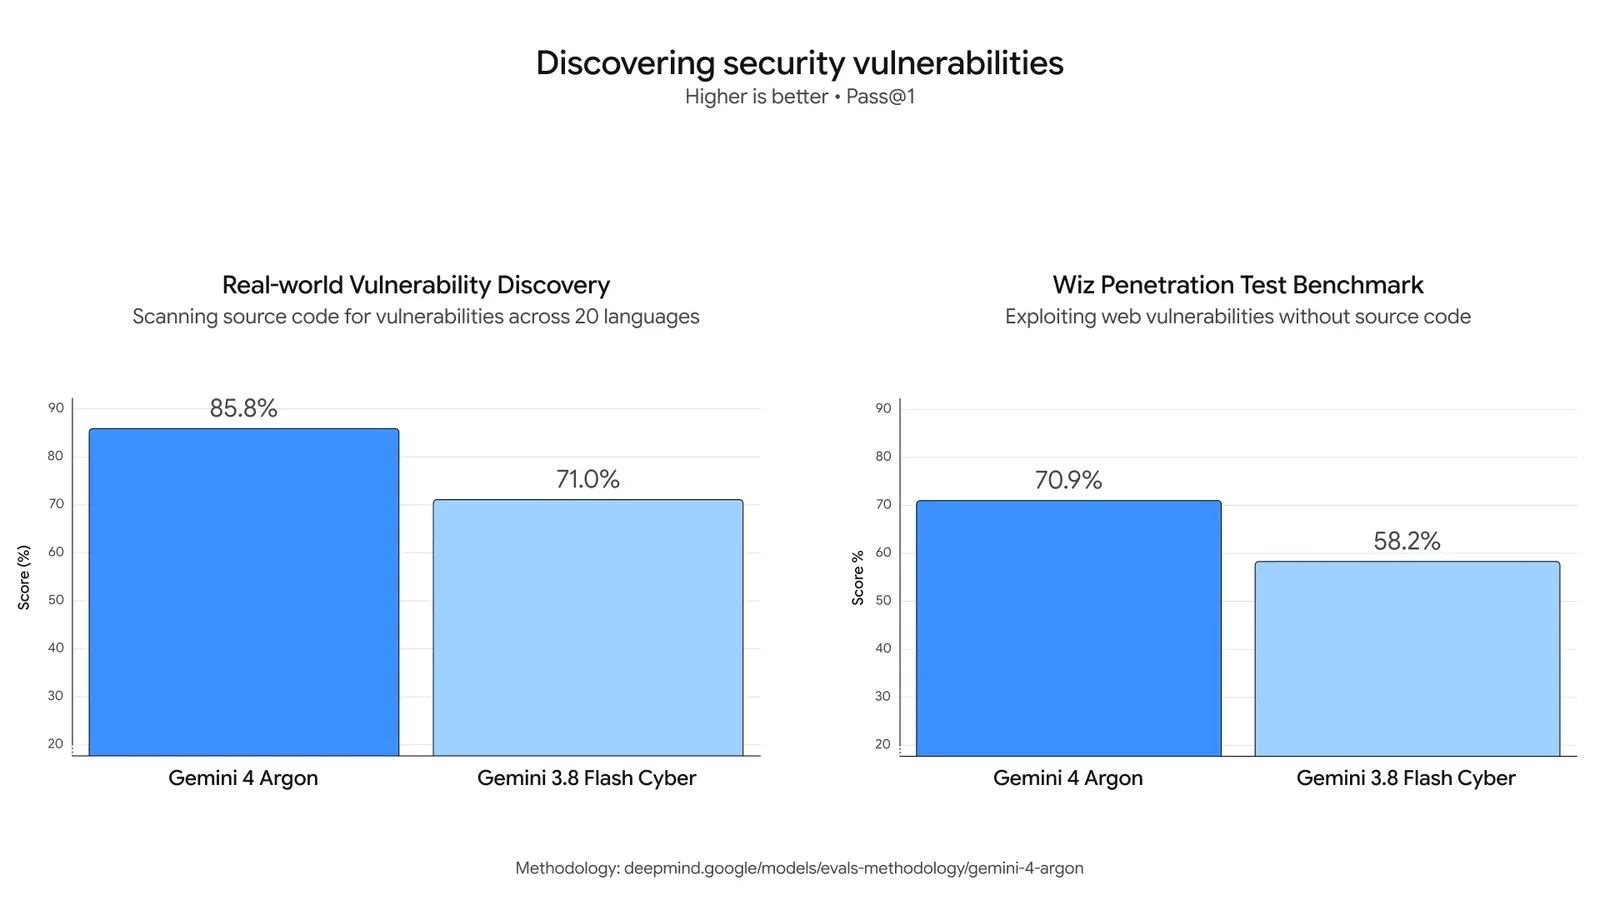
- Real-world Vulnerability Discovery(実際のコードに含まれる脆弱性の発見。20種類のプログラミング言語を対象としたGoogle社内テスト):Argonは85.8%、3.8 Flash Cyberは71.0%。
- Wiz Penetration Test Benchmark(Wiz社内のブラックボックス侵入テスト。テスト中にソースコードは見えません):Argonは70.9%、3.8 Flash Cyberは58.2%。
Gray Swanはプロンプトインジェクションのテストも行いました。これは、モデルが読むデータに悪意ある指示を隠し、それに従わせようとする攻撃です。各グループで最大15回試し、攻撃の成功率が低いほど優れています。Argonは0.7%、Claude Opus 5.5とClaude Fable 5.1はいずれも1.0%、GPT-6 Astraは8.5%、GPT-6 Solは10.1%でした。
サイバーセキュリティ向けに制限を緩和したgemini-4-argon-cyber-permissiveもありますが、Fairwindの対象者のみが利用でき、一般のAPIでは使えません。
Gemini 3.1 ProとCarbonとの関係
Gemini 3.1 Pro:引き続き提供されています。APIのgemini-3.1-pro-previewに提供終了日は発表されておらず、Geminiアプリのプランページにも両方のモデルが載っています。GoogleはArgonが3.1 Proを置き換えるとは説明していません。
Carbon:総合スコアは高いものの、一般公開日は未定です。割引料金はArgonと同じ(入力2ドル、出力10ドル)です。第三者の総合指標Artificial Analysis Intelligence Index v5ではArgonが50点、Carbonが59点でした。Artificial AnalysisによるとArgonの出力速度は毎秒約82tokenで、「平均より遅く、やや冗長」と評価されています。出力側は料金が高いので、コストを見積もる際は考慮してください。
安全性
GoogleのArgon安全性レポートは、防護策のないモデルがサイバーセキュリティとCBRN(化学、生物、放射性物質、核)の両分野で重要能力レベル(CCL)に達している可能性を否定できないとしています。CCLはGoogleのFrontier Safety Frameworkで高リスクAIに設定された社内の基準です。基準に達した場合は、防護を強化する必要があります。そのためGoogleは、モデルの推論過程や動作を監視し、必要に応じて実行を停止する対策を導入しました。外部の評価機関には英国AISI、米国NISTのCAISSI(報告書に記載された綴り)、Gray Swan、Trajectory Labsが含まれます。
小企鵝(Penchan)のまとめ
すでにProまたはUltraを契約している人:モデルメニューでArgonを選び、自分の法律文書、財務報告書、長いPDFなどで試し、普段使うモデルと比べてみましょう。Argonは法律・金融AI Agentで強みを示しています。GraphWalksは関係ネットワークのテストで、一般的な長文読解とは異なります。
Plusまたは無料プランの人:Argonを使うためだけにアップグレードする必要はない、というのが私の見方です。PlusからProにすると月額NT$485高くなります。GeminiアプリでArgonを試すなら、AI Proが最も安いプランです。
コーディングが中心の人:ArgonはコマンドラインとFrontierSWE v2で競合に届きませんでした。この種の作業では、まずClaude Opus 5.5やGPT-6 Astraを検討します。
開発者:有料のGemini APIを使い、コストは12月1日以降の4ドルと20ドルで見積もりましょう。割引価格は短期の値下げとして扱ってください。結果を待てる一括処理にはBatchを使えます。Argonは出力が長くなりやすく、出力側の料金も高いため、まず実際のタスクで費用を試算しましょう。
CarbonがAPIで公開されたら、同じタスクで改めて比較しましょう。
関連記事
- Gemini 4 Carbonとは
- Google Geminiシリーズ一覧
- Gemini無料版とProの違い
- Google AI Studioの使い方
- Gemini 3.8 Flashとサイバーセキュリティ版Cyber
- Claude Opus 5.5の評価と順位
- GPT-6 Astraの詳しい紹介
カバー画像出典:Google
この記事はAIモデルのプランとAPI料金に関する消費者向け情報であり、証券や投資に関する助言ではありません。実際の料金や機能はGoogleの最新の公式発表をご確認ください。記事の情報は2026年10月29日時点のもので、古くなっている可能性があります。